Curva ROC e AUC
Um classificador produz um escore para cada observação. Converter escores em rótulos de classe exige a escolha de um limiar. A curva ROC mostra como a sensibilidade e a especificidade se equilibram conforme o limiar varia por toda a sua faixa. A AUC resume essa curva em um único número: a probabilidade de que o modelo classifique um caso positivo aleatório com um escore maior do que um caso negativo aleatório.
De escores a previsões: a matriz de confusão
Para a anatomia completa da matriz de confusão, exemplos resolvidos, e a média multiclasse (macro, micro, ponderada), veja o post dedicado à matriz de confusão.
Um classificador binário atribui a cada observação um escore \(\hat{p} \in [0,1]\) e prevê positivo se \(\hat{p} \geq t\) para algum limiar \(t\). As previsões resultantes são resumidas na matriz de confusão:
| Previsto positivo | Previsto negativo | |
|---|---|---|
| Realmente positivo | VP | FN |
| Realmente negativo | FP | VN |
Métricas-chave derivadas da matriz de confusão:
\[\text{Sensibilidade (Recall, TPR)} = \frac{VP}{VP+FN}\]
(de todos os positivos, quantos capturamos?)
\[\text{Especificidade} = \frac{VN}{VN+FP}, \quad \text{FPR} = 1 - \text{Especificidade} = \frac{FP}{FP+VN}\]
\[\text{Precisão (PPV)} = \frac{VP}{VP+FP}\]
(de todos os previstos positivos, quantos são realmente positivos?)
\[\text{Acurácia} = \frac{VP+VN}{n}\]
O limiar \(t\) controla a compensação: um \(t\) menor captura mais positivos (TPR alta), mas também classifica mal mais negativos (FPR alta).
A curva ROC
A curva ROC (Receiver Operating Characteristic) plota a TPR (sensibilidade) no eixo y contra a FPR (1-especificidade) no eixo x, para todo limiar possível \(t \in [0,1]\).
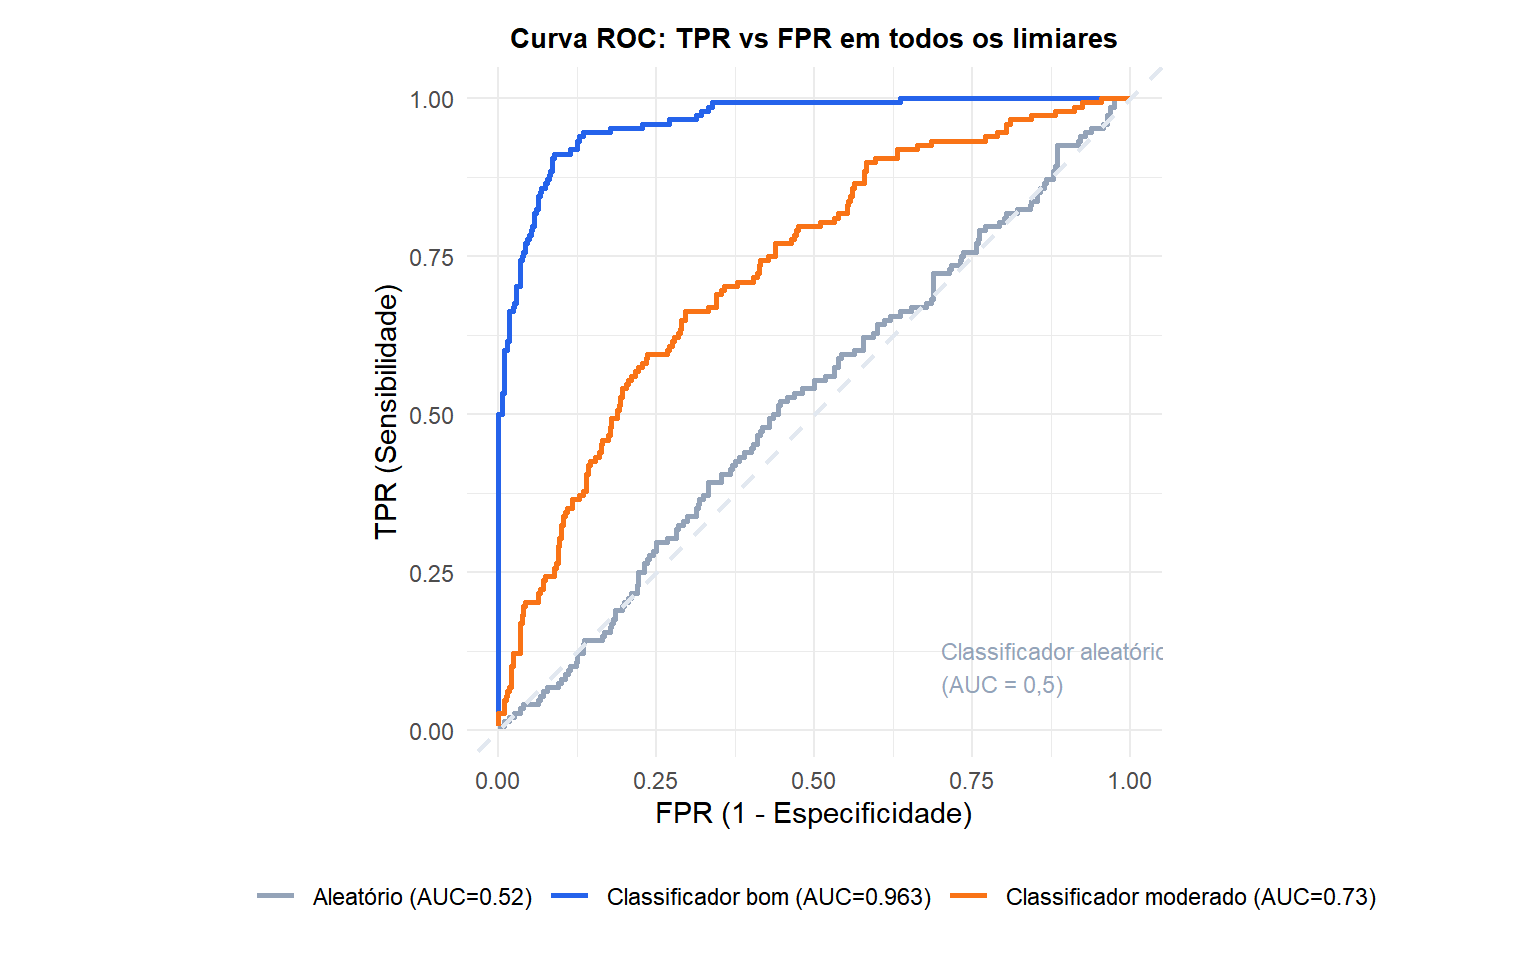
A linha diagonal representa um classificador aleatório (AUC = 0,5): ele alcança a mesma TPR que a FPR em cada limiar, sem ganhar nada com os escores. Um classificador perfeito alcançaria o canto superior esquerdo (TPR=1, FPR=0) e teria AUC=1. Quanto mais a curva se projeta para o canto superior esquerdo, melhor é o classificador.
AUC: área sob a curva ROC
A AUC (Area Under the Curve) é a integral da curva ROC:
\[\text{AUC} = \int_0^1 \text{TPR}(\text{FPR}^{-1}(t))\, dt\]
Ela tem uma interpretação probabilística clara (estatística de Wilcoxon-Mann-Whitney):
\[\text{AUC} = P(\hat{p}_+ > \hat{p}_-)\]
A probabilidade de que um caso positivo escolhido aleatoriamente receba um escore maior do que um caso negativo escolhido aleatoriamente. AUC = 0,5: ranqueamento aleatório. AUC = 1: ranqueamento perfeito. AUC = 0: ranqueamento perfeitamente invertido.
Essa interpretação torna a AUC independente do limiar: ela mede a qualidade do ranqueamento dos escores, não a qualidade de nenhuma decisão de limiar específica.
Escolhendo um limiar operacional
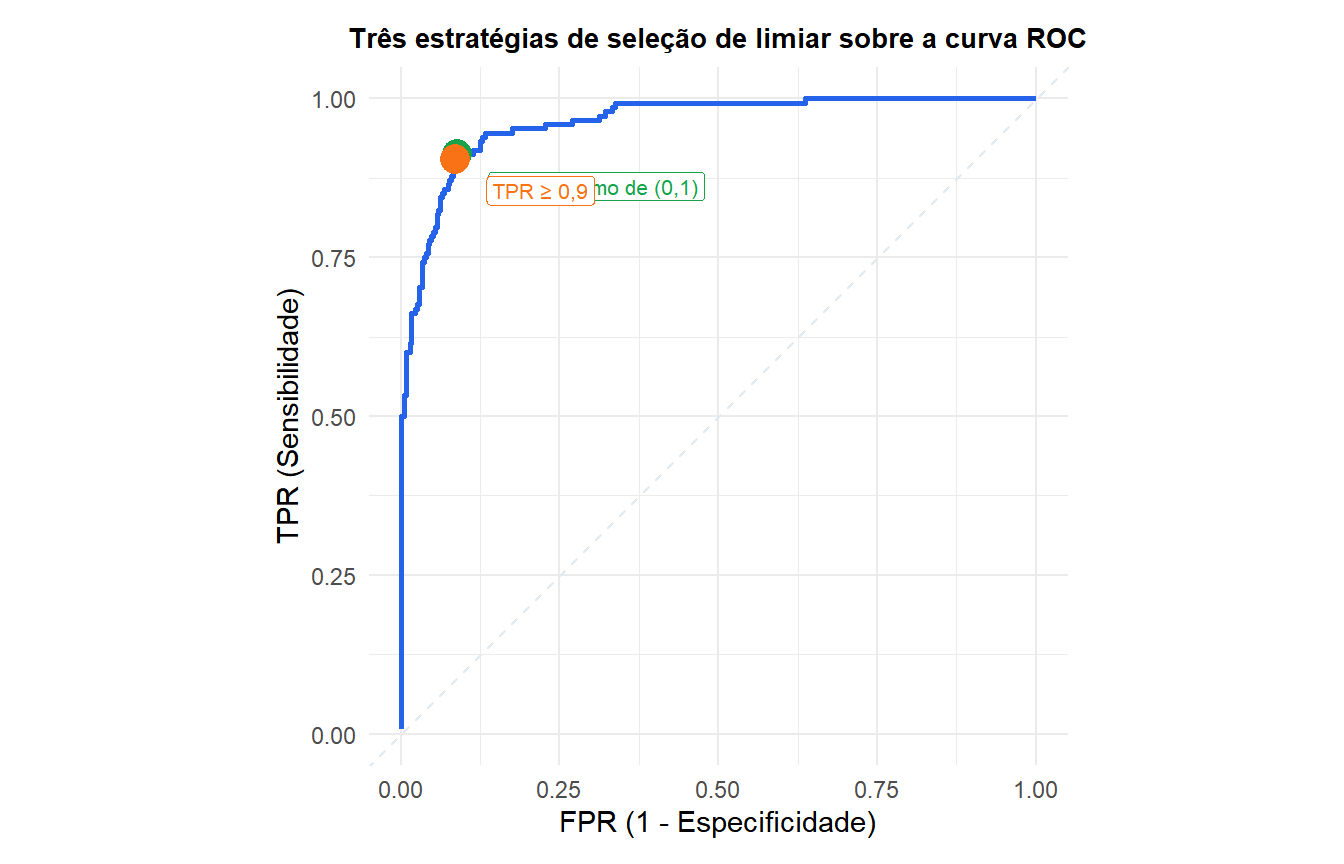
A AUC avalia a qualidade geral do ranqueamento, mas decisões reais exigem um limiar. Como escolher \(t\):
- Custo igual: maximize a acurácia, ou equivalentemente encontre o limiar mais próximo do canto superior esquerdo da curva ROC (distância mínima a \((0,1)\)).
- Sensível a custo: se um falso negativo é \(c\) vezes mais caro do que um falso positivo, o limiar ótimo satisfaz a condição de inclinação na curva ROC.
- Índice J de Youden: maximize \(J = \text{TPR} - \text{FPR} = \text{Sensibilidade} + \text{Especificidade} - 1\).
- Restrição de domínio: fixe uma FPR máxima aceitável (por exemplo, em triagem, aceite no máximo 10% de falsos positivos) e encontre o limiar que maximiza a TPR sob essa restrição.
Curva de precisão-recall
Para conjuntos de dados altamente desbalanceados (por exemplo, detecção de fraude em que 0,1% dos casos são positivos), a ROC e a AUC podem ser enganosas: um classificador que rotula tudo como negativo alcança FPR=0 e uma AUC alta, mesmo sendo completamente inútil.
A curva de Precisão-Recall (PR) plota precisão vs recall em todos os limiares. Ela se concentra na classe positiva e é mais informativa quando:
- O conjunto de dados é altamente desbalanceado.
- O custo de falsos negativos e falsos positivos é muito diferente.
- A classe rara é a classe de interesse.
A precisão média (AP) resume a curva PR, análoga à AUC para a curva ROC.
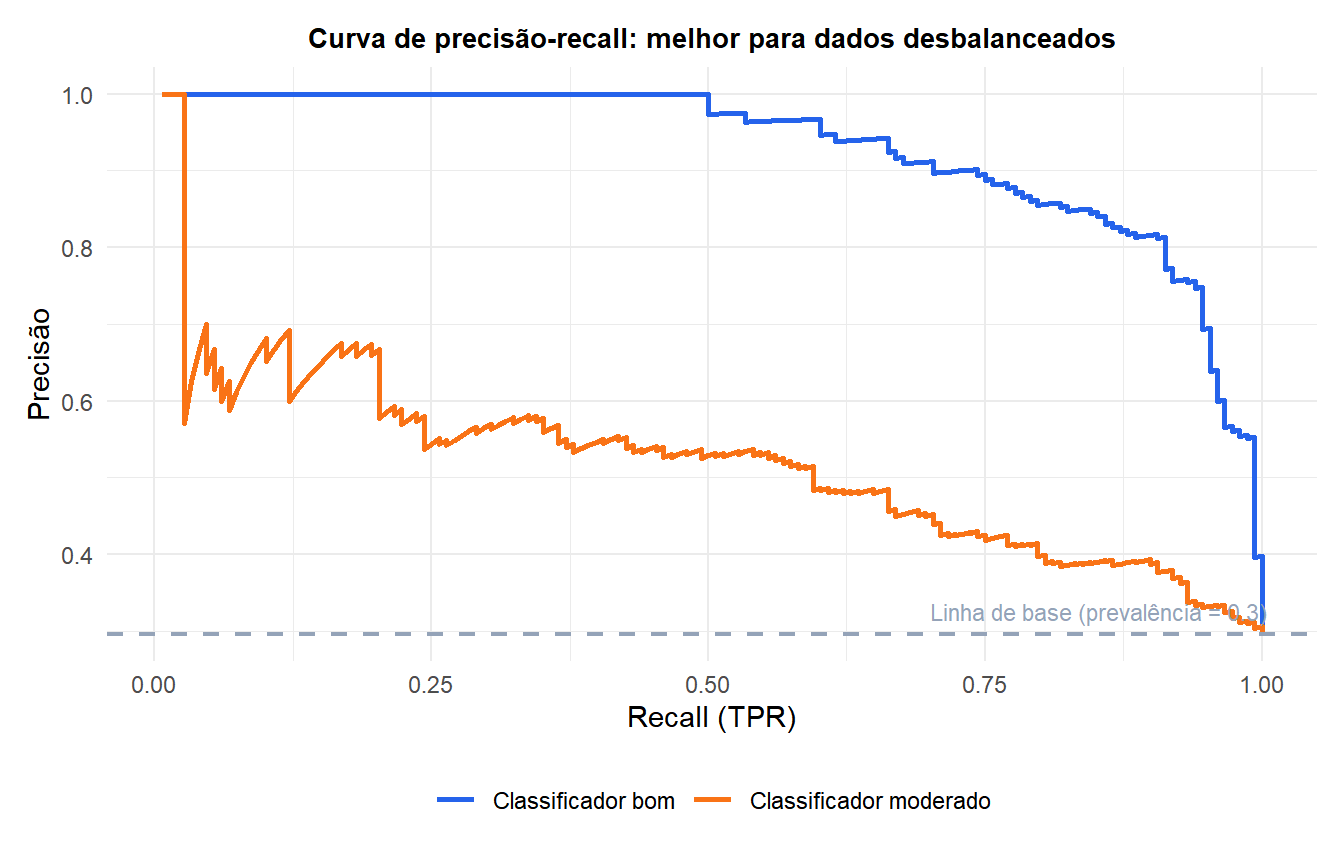
A linha de base (tracejada) é a precisão alcançada prevendo aleatoriamente positivo com probabilidade igual à prevalência. Um classificador útil deve se manter bem acima dessa linha.
⚠️ A AUC não é a métrica certa quando as classes estão severamente desbalanceadas
Considere um sistema de detecção de fraude em que 0,1% das transações são fraudulentas. Um classificador que sempre prevê “sem fraude” alcança acurácia = 99,9%, AUC próxima de 0,5 (ligeiramente acima, porque o palpite aleatório respeita o desbalanceamento). Mas a precisão média poderia estar próxima de zero.
Use a AUC da curva PR (ou precisão média) em vez da AUC-ROC quando:
- A classe positiva é rara (prevalência \(< 5\)-10%).
- Você se preocupa principalmente com detectar a classe rara.
- Falsos positivos têm custos muito diferentes de falsos negativos.
Além disso: ao comparar modelos com AUC, verifique se a diferença é estatisticamente significativa. O teste de DeLong compara duas curvas ROC e fornece um valor-p para a diferença na AUC.
💡 ROC e AUC em R
library(pROC)

# ROC curve and AUC
roc_obj <- roc(y_true, scores, levels=c(0,1), direction="<")
auc(roc_obj)                         # AUC value
ci.auc(roc_obj)                      # 95% CI for AUC
plot(roc_obj, col="#2563EB")         # ROC plot

# Compare two ROC curves
roc1 <- roc(y_true, scores1)
roc2 <- roc(y_true, scores2)
roc.test(roc1, roc2)                 # DeLong test

# Optimal threshold by Youden's J
coords(roc_obj, "best", best.method="youden")

# Precision-Recall
library(PRROC)
pr_obj <- pr.curve(scores.class1=scores[y_true==1],
                   scores.class0=scores[y_true==0],
                   curve=TRUE)
pr_obj$auc.integral   # average precision
plot(pr_obj)

# Full evaluation with caret
library(caret)
confusionMatrix(pred_labels, true_labels, positive="1")
