Matriz de confusão, precisão, recall e F1-score
Toda métrica de classificação usada para avaliar um modelo, acurácia, precisão, recall, F1-score e mais, é calculada diretamente a partir de apenas quatro números: a matriz de confusão. Este post cobre a anatomia completa dessa matriz e cada métrica derivada dela, tanto para problemas binários quanto multiclasse. Depois de entender essas métricas em um único limiar, a curva ROC e a AUC resumem como elas se comportam conforme o limiar varia.
A matriz de confusão
Um classificador binário que já se comprometeu com uma decisão (positivo ou negativo) pode ser comparado com os rótulos verdadeiros. Toda observação cai em exatamente uma de quatro células:
| Previsto positivo | Previsto negativo | |
|---|---|---|
| Realmente positivo | Verdadeiro Positivo (VP) | Falso Negativo (FN) |
| Realmente negativo | Falso Positivo (FP) | Verdadeiro Negativo (VN) |
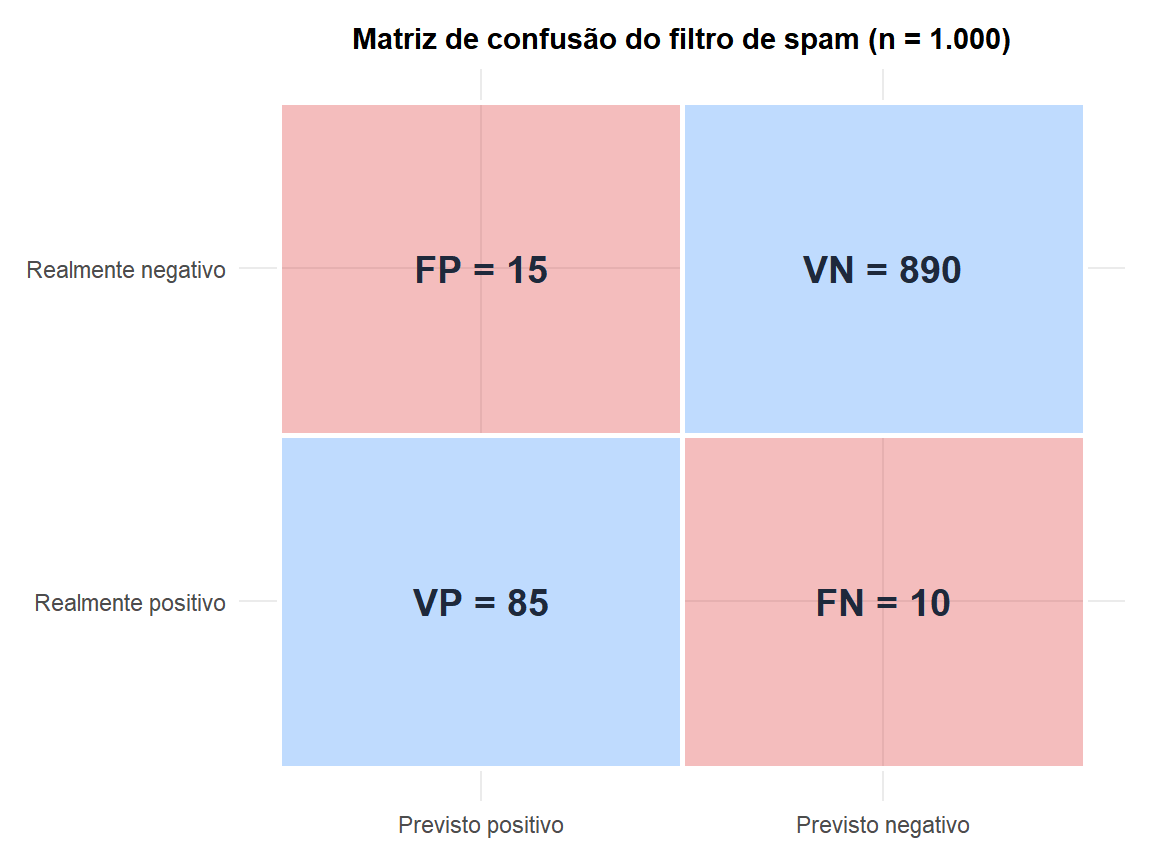
Um exemplo concreto torna as quatro células fáceis de lembrar. Considere um filtro de spam decidindo, para cada e-mail recebido, se ele é spam:
- Verdadeiro Positivo (VP): spam corretamente detectado e enviado para a pasta de spam.
- Falso Negativo (FN): spam que escapou do filtro e chegou à caixa de entrada, uma falha por omissão.
- Falso Positivo (FP): um e-mail real e legítimo erroneamente enviado para a pasta de spam, um falso alarme.
- Verdadeiro Negativo (VN): um e-mail real corretamente mantido na caixa de entrada.
Toda métrica deste post não é nada além de uma razão diferente calculada a partir dessas quatro contagens.
Métricas derivadas da matriz
Cada métrica abaixo é apenas uma razão diferente das quatro contagens de células acima, mas cada uma responde a uma pergunta distinta sobre o comportamento do classificador.
\[\text{Acurácia} = \frac{VP+VN}{VP+FP+FN+VN} \qquad \text{Precisão} = \frac{VP}{VP+FP}\] \[\text{Recall (Sensibilidade)} = \frac{VP}{VP+FN} \qquad \text{Especificidade} = \frac{VN}{VN+FP}\] \[F_1 = \frac{2 \cdot \text{Precisão} \cdot \text{Recall}}{\text{Precisão}+\text{Recall}}\]
A precisão responde a uma pergunta de falso alarme: de tudo que marquei como positivo, quanto estava realmente correto? O recall responde a uma pergunta de casos perdidos: de tudo que era realmente positivo, quanto eu capturei? Os dois trocam um pelo outro: um modelo que marca tudo como positivo obtém recall perfeito (100%), porque nunca perde um verdadeiro positivo, mas precisão péssima, porque a maioria de suas marcações positivas está errada. Um modelo que só marca os casos de que tem mais certeza faz o oposto: alta precisão, baixo recall.
O \(F_1\) é a média harmônica da precisão e do recall, não a média aritmética, e essa escolha é deliberada. A média harmônica penaliza um grande desequilíbrio entre os dois com muito mais força do que uma média simples faria, então um modelo não consegue obter um bom F1 sendo excelente em um e péssimo no outro: ambos precisam ser razoavelmente bons ao mesmo tempo.
\[VP = 85 \qquad FP = 15 \qquad FN = 10 \qquad VN = 890 \qquad n = 1000\]
\[\text{Acurácia} = \frac{85+890}{1000} = 0{,}975 \qquad \text{Precisão} = \frac{85}{85+15} = 0{,}850\] \[\text{Recall} = \frac{85}{85+10} = 0{,}8947 \qquad \text{Especificidade} = \frac{890}{890+15} = 0{,}9834\] \[F_1 = \frac{2 \times 0{,}850 \times 0{,}8947}{0{,}850+0{,}8947} = 0{,}8718\]
A acurácia parece excelente (97,5%), mas esse conjunto de dados está desbalanceado: apenas \(VP+FN=95\) dos 1.000 e-mails são realmente spam (prevalência de 9,5%). Um classificador trivial que sempre prevê “não é spam” acertaria \(VN+FP = 905\) de 1.000, uma acurácia de 0,905 (90,5%), apenas 7 pontos percentuais abaixo do classificador real, mesmo sendo completamente inútil (ele nunca captura um único e-mail de spam, recall = 0). É exatamente por isso que a acurácia isolada é um número enganoso em dados desbalanceados: precisão, recall e F1 contam a história real.

O caso multiclasse: médias macro, micro e ponderada
Com mais de duas classes, não há uma única célula da matriz de confusão para chamar de “positiva”. Em vez disso, cada classe, por sua vez, é tratada como “positiva” e todas as outras como “negativas” (um-contra-o-resto), o que produz uma precisão, um recall e um F1 por classe. Esses números por classe então precisam ser combinados em um único escore resumo, e há três formas padrão de fazer isso.
\[\text{Média macro} = \frac{1}{k}\sum_{i=1}^k \text{métrica}_i\] \[\text{Média ponderada} = \sum_{i=1}^k \frac{n_i}{n}\, \text{métrica}_i\] \[\text{Média micro} = \frac{\sum_i VP_i}{\sum_i VP_i + \sum_i FP_i}\]
A média macro toma a média não ponderada entre classes. A média ponderada pondera a métrica de cada classe por seu suporte \(n_i\). A média micro agrupa primeiro os VP/FP/FN de todas as classes, antes de calcular uma única razão, o que, para um problema multiclasse de rótulo único, equivale exatamente à acurácia geral.
Matriz de confusão (linhas = classe real, colunas = classe prevista):
| Previsto Gato | Previsto Cachorro | Previsto Pássaro | Total (suporte) | |
|---|---|---|---|---|
| Real Gato | 50 | 8 | 2 | 60 |
| Real Cachorro | 5 | 40 | 5 | 50 |
| Real Pássaro | 3 | 7 | 30 | 40 |
Precisão, recall e F1 por classe (cada classe tratada como “positiva” por vez, por exemplo para Gato: \(VP=50\), \(FP=5+3=8\), \(FN=8+2=10\)):
| Classe | Precisão | Recall | F1 | Suporte |
|---|---|---|---|---|
| Gato | 0,8621 | 0,8333 | 0,8475 | 60 |
| Cachorro | 0,7273 | 0,8000 | 0,7619 | 50 |
| Pássaro | 0,8108 | 0,7500 | 0,7792 | 40 |
F1 com média macro \(= (0{,}8475+0{,}7619+0{,}7792)/3 = 0{,}7962\) (trata as três classes como igualmente importantes, independentemente de quantos exemplos existam de cada uma).
F1 com média ponderada \(= (0{,}8475{\times}60 + 0{,}7619{\times}50 + 0{,}7792{\times}40)/150 = 0{,}8007\) (pondera o F1 de cada classe por sua frequência nos dados, então é dominado pelo desempenho nas classes majoritárias).
Média micro (= acurácia geral aqui) \(= (50+40+30)/150 = 0{,}8000\).
Os três números-resumo respondem a uma pergunta genuinamente diferente, e podem divergir bastante quando os tamanhos das classes são muito desiguais; sempre declare explicitamente qual método de média uma métrica reportada usa.
⚠️ A média macro pode esconder o desempenho ruim em classes raras, e vice-versa
Se uma classe é rara (suporte pequeno) e o modelo tem desempenho terrível nela, o F1 com MÉDIA MACRO refletirá claramente esse desempenho ruim (todas as classes contam igualmente, então uma classe ruim arrasta visivelmente a média macro para baixo), mas o F1 com MÉDIA PONDERADA (e a acurácia pura) pode parecer enganosamente bom, já que a classe rara quase não move um número ponderado por suporte. Essa é exatamente a mesma armadilha de dados desbalanceados do exemplo binário de spam acima, generalizada para múltiplas classes: quando uma classe rara específica importa muito (por exemplo, detectar um subtipo raro de doença, ou um tipo raro de fraude entre várias categorias de fraude), reporte a média macro E a precisão/recall próprios dessa classe específica, não apenas um número agregado que uma classe majoritária pode dominar.
Executando em R
As métricas binárias podem ser calculadas manualmente a partir das quatro contagens, mas caret e yardstick tratam diretamente dos fluxos completos binário e multiclasse, incluindo a média macro/micro:
# Binary case
TP <- 85; FP <- 15; FN <- 10; TN <- 890
precision <- TP / (TP + FP)
recall    <- TP / (TP + FN)
f1        <- 2 * precision * recall / (precision + recall)

# Using caret on real predicted/actual label vectors
library(caret)
confusionMatrix(pred_labels, true_labels, positive = "spam", mode = "prec_recall")

# Multi-class: full per-class + macro/weighted summary
library(yardstick)
library(dplyr)
df <- data.frame(truth = factor(c("Cat","Cat","Dog","Bird")),
                  estimate = factor(c("Cat","Dog","Dog","Bird")))
df %>% yardstick::precision(truth, estimate, estimator = "macro")
df %>% yardstick::f_meas(truth, estimate, estimator = "macro")
df %>% yardstick::f_meas(truth, estimate, estimator = "micro")
💡 Qual métrica otimizar
Não existe uma única métrica “melhor”; isso depende completamente do custo relativo dos dois tipos de erro. Otimize para RECALL quando perder um caso positivo é caro (triagem médica para uma doença grave, detecção de fraude em que uma fraude não detectada é muito custosa). Otimize para PRECISÃO quando um falso alarme é caro (um filtro de spam que erroneamente enterra um e-mail importante, um sistema de recomendação que mostra sugestões irrelevantes e irritantes). Use o F1 como um número único equilibrado quando ambos os tipos de erro importam aproximadamente igual e você precisa de um único número para comparar modelos ou ajustar um limiar; mas sempre observe também a precisão e o recall separadamente, pois o F1 isolado pode esconder qual dos dois está causando um escore baixo.

