K-médias (K-means)
O k-médias particiona \(n\) observações em \(K\) clusters minimizando a variância total intra-cluster. Ele alterna entre atribuir cada ponto ao seu centroide mais próximo e recalcular os centroides até a convergência. Simples, rápido, e escalável para grandes conjuntos de dados, o k-médias é o ponto de partida padrão para clustering. Sua principal limitação: assume clusters esféricos de tamanho semelhante, diferentemente do agrupamento hierárquico, que não faz essa suposição, mas escala pior.
Função objetivo
O k-médias minimiza a soma de quadrados intra-cluster (WCSS):
\[\min_{C_1,\ldots,C_K} \sum_{k=1}^K \sum_{\mathbf{x}_i \in C_k} \|\mathbf{x}_i - \boldsymbol{\mu}_k\|^2\]
em que \(\boldsymbol{\mu}_k = \frac{1}{|C_k|}\sum_{\mathbf{x}_i \in C_k} \mathbf{x}_i\) é o centroide do cluster \(k\). Isso é equivalente a maximizar a variância entre clusters: um bom agrupamento concentra os pontos dentro dos clusters e separa os clusters entre si.
A otimização é NP-difícil em geral (número exponencial de partições a verificar), mas o algoritmo de Lloyd encontra um mínimo local eficientemente.
O algoritmo de Lloyd
Inicialização: posicione \(K\) centroides no espaço de atributos (veja K-means++ abaixo).
Repita até a convergência:
Passo de atribuição: atribua cada ponto ao seu centroide mais próximo:
\[c_i = \arg\min_{k} \|\mathbf{x}_i - \boldsymbol{\mu}_k\|^2\]
Passo de atualização: recalcule cada centroide como a média de seus pontos atribuídos:
\[\boldsymbol{\mu}_k = \frac{1}{|C_k|}\sum_{i: c_i=k} \mathbf{x}_i\]
Cada passo diminui ou mantém a WCSS, então o algoritmo sempre converge. No entanto, converge para um mínimo local, não necessariamente o global.
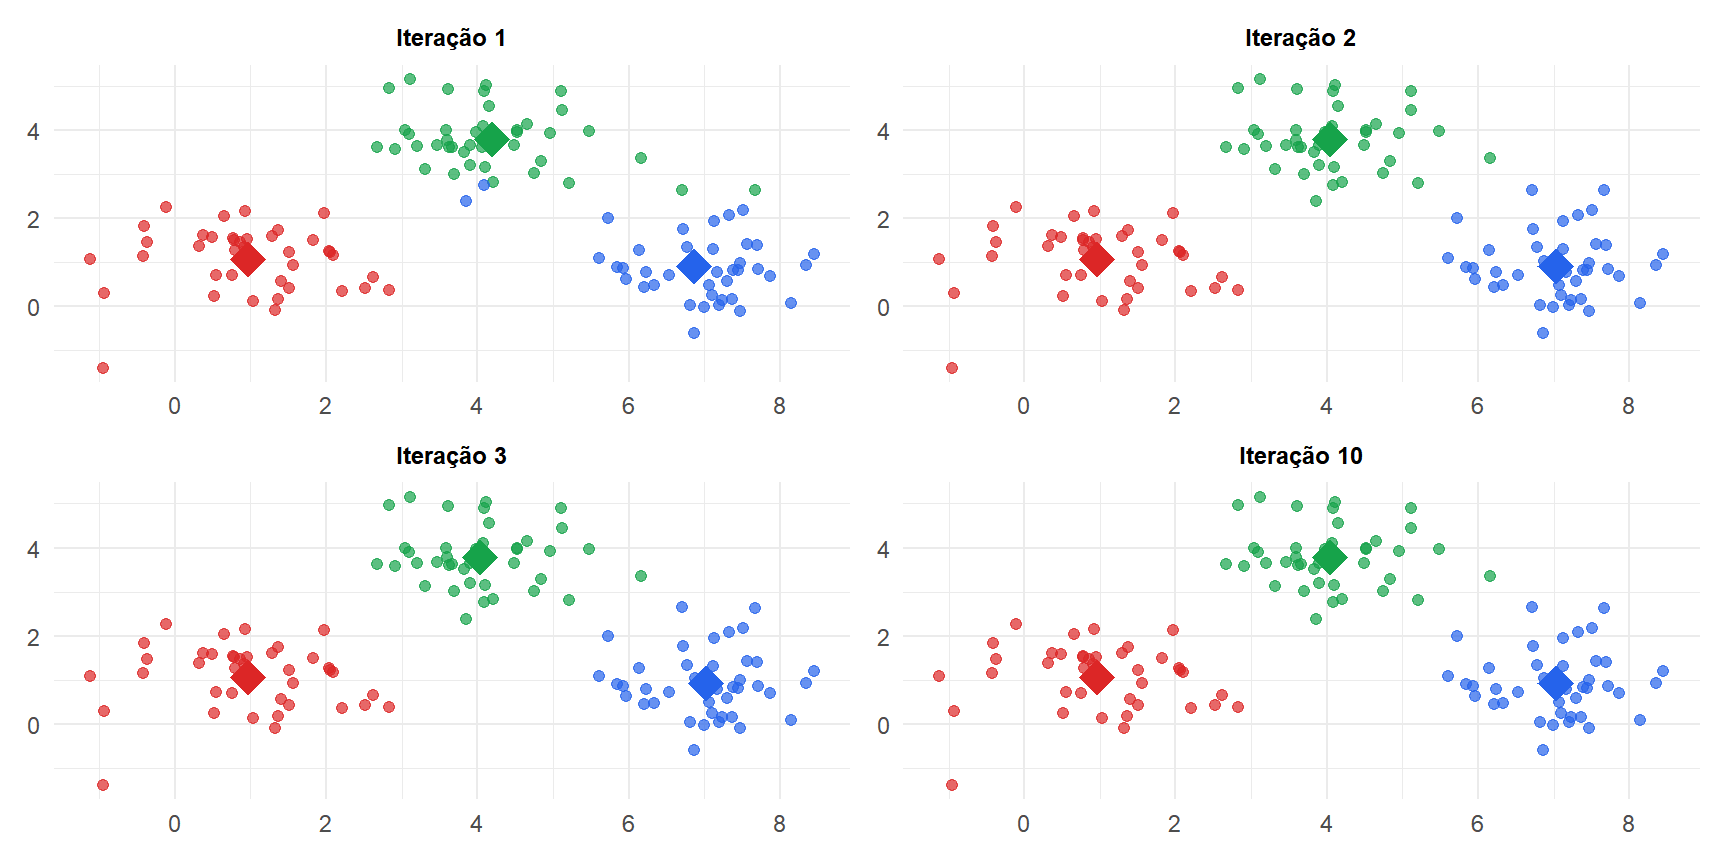
Os diamantes são os centroides. Após a iteração 1, as atribuições são aproximadas; na iteração 10, o algoritmo convergiu para os três clusters corretos.
Inicialização K-means++
A inicialização aleatória pode levar a mínimos locais ruins: se dois centroides começam no mesmo cluster, esse cluster será dividido artificialmente. O K-means++ seleciona centroides iniciais que estão espalhados:
- Escolha o primeiro centroide uniformemente ao acaso a partir dos dados.
- Para cada centroide subsequente: escolha um ponto com probabilidade proporcional à sua distância ao quadrado do centroide já escolhido mais próximo.
- Repita até que \(K\) centroides sejam escolhidos.
Isso dá uma garantia de aproximação \(O(\log K)\) para a WCSS ótima em expectativa, e, na prática, reduz o número de iterações necessárias e a probabilidade de soluções ruins. O K-means++ é o padrão na maioria das implementações.
Escolhendo K
Método do cotovelo
Plote a WCSS em função de \(K\). A WCSS sempre diminui conforme \(K\) aumenta (com \(K=n\), cada ponto é seu próprio cluster, WCSS=0). O “cotovelo” é o ponto em que adicionar outro cluster dá retornos decrescentes.
Escore de silhueta
Para cada ponto \(i\), seja \(a_i\) sua distância média aos pontos de seu próprio cluster e \(b_i\) sua distância média aos pontos do cluster mais próximo diferente:
\[s_i = \frac{b_i - a_i}{\max(a_i, b_i)} \in [-1, 1]\]
\(s_i \approx 1\): bem agrupado. \(s_i \approx 0\): na fronteira entre clusters. \(s_i < 0\): provavelmente no cluster errado. O escore de silhueta médio sobre todos os pontos é maximizado no melhor \(K\).
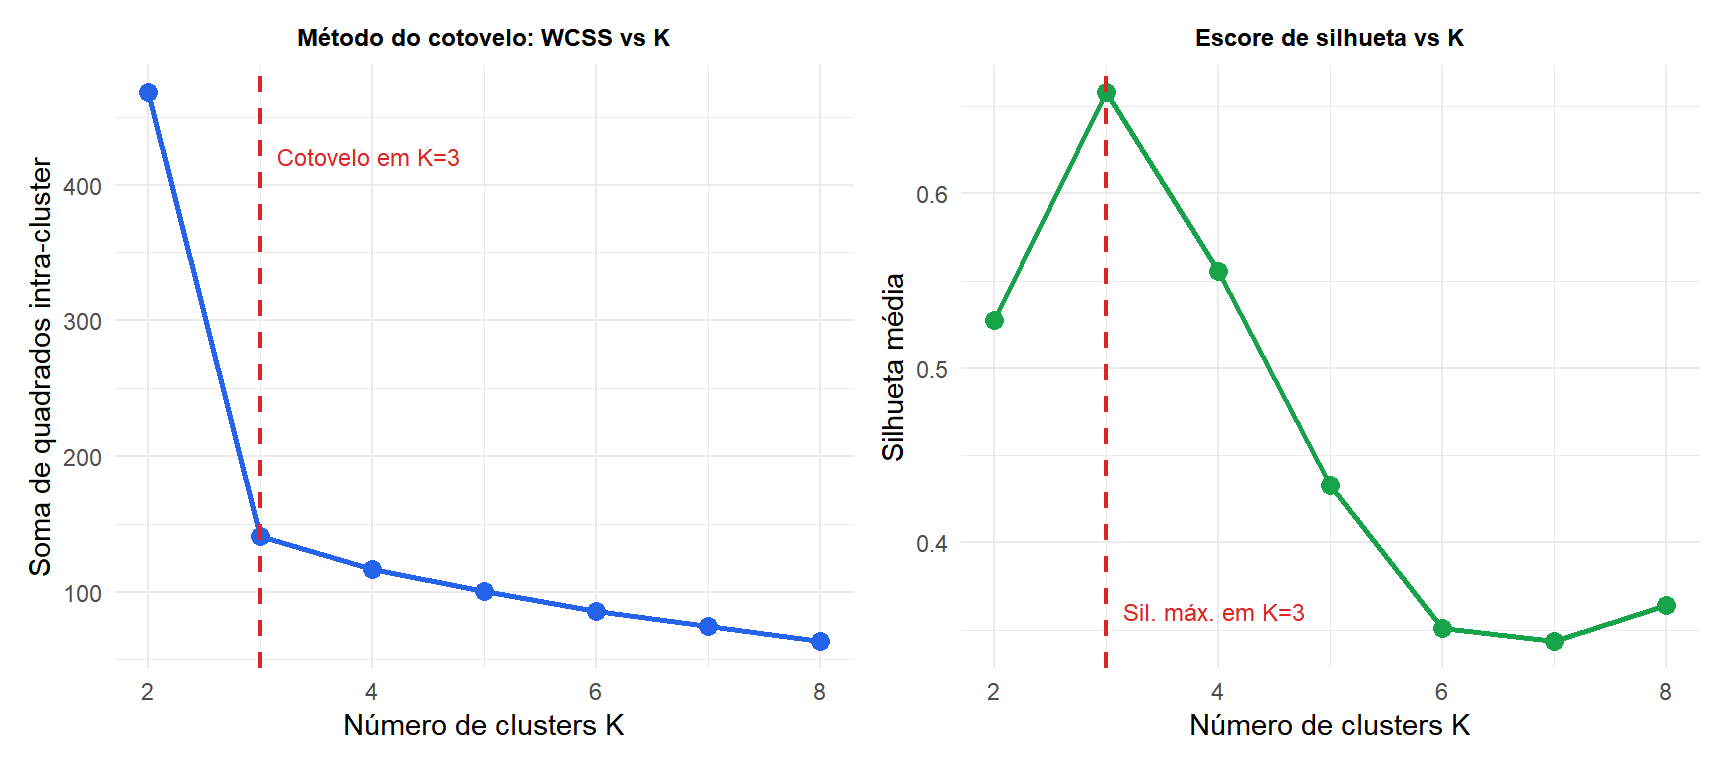
Ambos os métodos identificam corretamente \(K=3\) como ótimo para este conjunto de dados: o cotovelo é claro e a silhueta é maximizada em \(K=3\).
Quando o K-médias falha
O k-médias assume que os clusters são esféricos (distância euclidiana ao centroide), aproximadamente iguais em tamanho, e com densidade semelhante. Ele falha quando essas suposições são violadas.
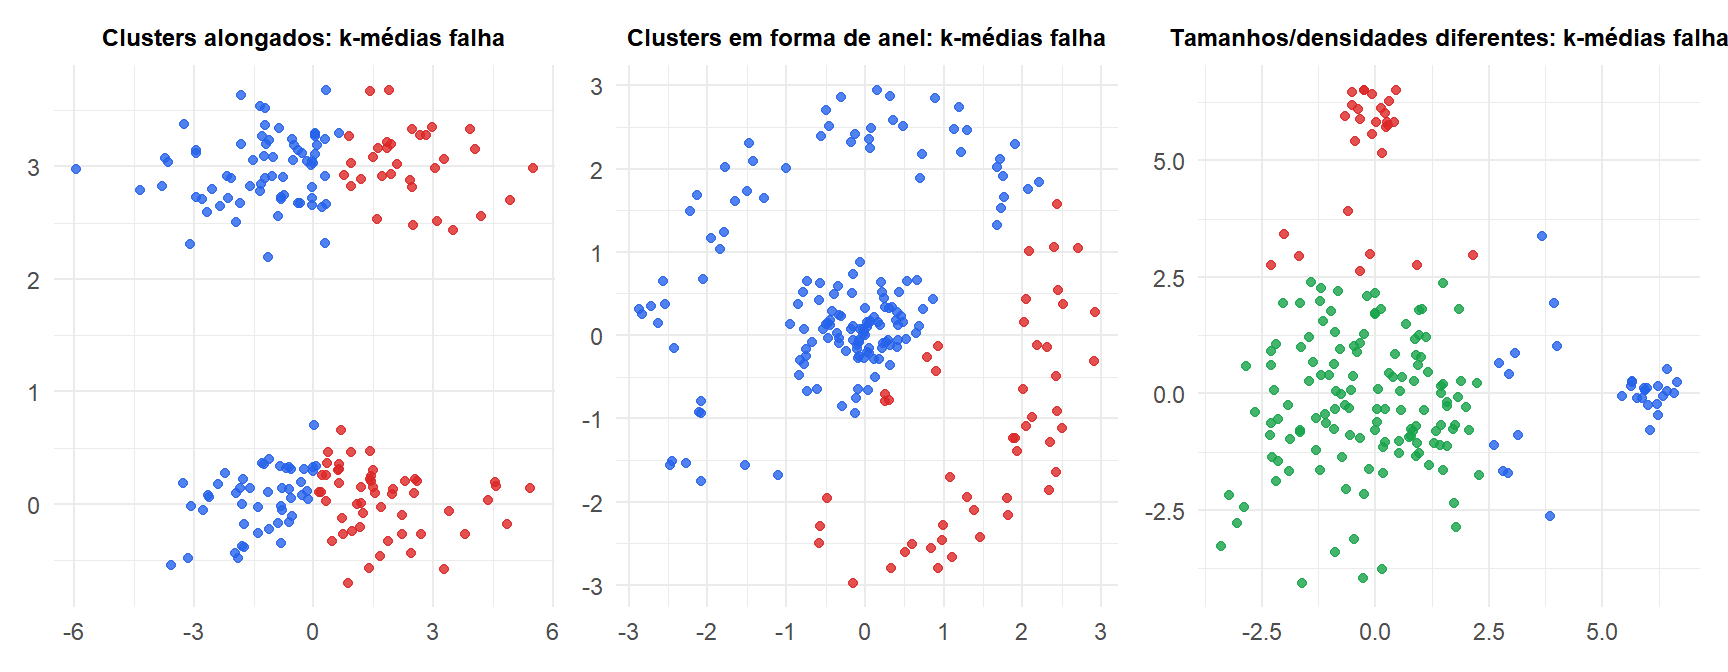
Para clusters não esféricos ou de tamanhos diferentes, use o DBSCAN (baseado em densidade) ou o agrupamento hierárquico com a ligação apropriada.
⚠️ O K-médias é sensível a outliers e à escala dos atributos
Um único outlier distante de qualquer centroide de cluster vai puxar o centroide em sua direção, distorcendo todo o cluster. Padronize os atributos antes de executar o k-médias (caso contrário, atributos com faixas grandes dominam a distância), e considere remover ou reduzir o peso de outliers primeiro.
Além disso: o k-médias não é determinístico. Sempre execute com múltiplas inicializações aleatórias (nstart=20 ou mais) e use a solução com a menor WCSS. Uma única execução pode convergir para um mínimo local ruim.
💡 K-médias em R
# K-means with 20 random starts (best solution returned)
km <- kmeans(X, centers=3, nstart=20, iter.max=100)
km$cluster        # cluster assignments
km$centers        # centroid coordinates
km$tot.withinss   # total WCSS

# Elbow method
wcss <- sapply(1:10, function(k)
  kmeans(X, centers=k, nstart=20)$tot.withinss)
plot(1:10, wcss, type="b", xlab="K", ylab="WCSS")

# Silhouette score
library(cluster)
sil <- silhouette(km$cluster, dist(X))
mean(sil[,3])   # mean silhouette
plot(sil)

# Gap statistic
gap <- clusGap(X, FUN=kmeans, nstart=20, K.max=10, B=50)
plot(gap)
