Regressão ElasticNet
O ElasticNet combina a penalidade \(L_1\) do Lasso com a penalidade \(L_2\) do Ridge. Ele herda a capacidade do Lasso de fixar coeficientes em exatamente zero (seleção de variáveis), corrigindo ao mesmo tempo as duas principais fraquezas do Lasso: instabilidade com preditores correlacionados e a restrição \(p > n\). Um único parâmetro de mistura \(\alpha\) controla a combinação entre as duas penalidades.
Função objetivo
O ElasticNet minimiza a usual perda por erro quadrático mais uma penalidade que é, ela mesma, uma mistura ponderada das penalidades do Lasso e do Ridge:
\[\hat{\boldsymbol{\beta}}^{EN} = \arg\min_{\boldsymbol{\beta}} \|\mathbf{y} - \mathbf{X}\boldsymbol{\beta}\|_2^2 + \lambda\left[\alpha\|\boldsymbol{\beta}\|_1 + \frac{1-\alpha}{2}\|\boldsymbol{\beta}\|_2^2\right]\]
Dois hiperparâmetros:
- \(\lambda \geq 0\): a força geral da regularização. \(\lambda\) maior encolhe mais.
- \(\alpha \in [0,1]\): o parâmetro de mistura.
- \(\alpha = 1\): Lasso puro.
- \(\alpha = 0\): Ridge puro.
- \(\alpha \in (0,1)\): mistura do ElasticNet.
O fator \(1/2\) no termo \(L_2\) é uma convenção que simplifica as derivadas; o ponto-chave é que \(\alpha\) controla o peso relativo entre as duas penalidades.
Por que o ElasticNet existe: os dois problemas do Lasso
Problema 1: preditores correlacionados
Quando dois preditores \(x_j\) e \(x_k\) são altamente correlacionados e ambos relevantes, o Lasso escolhe um arbitrariamente e fixa o outro em zero. A seleção depende da variação aleatória nos dados: execute o Lasso duas vezes em amostras levemente diferentes e você pode obter subconjuntos selecionados diferentes.
O componente \(L_2\) do ElasticNet introduz um efeito de agrupamento: quando os preditores são correlacionados, o ElasticNet tende a incluí-los ou excluí-los juntos, atribuindo coeficientes semelhantes a preditores que fornecem informação semelhante. O limite na diferença entre coeficientes correlacionados é:
\[|\hat{\beta}_j^{EN} - \hat{\beta}_k^{EN}| \leq \frac{1}{\lambda(1-\alpha)}\sqrt{2(1-r_{jk})}\]
em que \(r_{jk}\) é a correlação entre \(x_j\) e \(x_k\). Conforme \(r_{jk} \to 1\), os dois coeficientes convergem para o mesmo valor.
Problema 2: situações \(p > n\)
O Lasso pode selecionar no máximo \(n\) variáveis quando \(p > n\) (o posto de \(\mathbf{X}\) limita o número de coeficientes não nulos). O ElasticNet não tem essa restrição: o componente \(L_2\) estabiliza a otimização e permite que mais de \(n\) variáveis sejam selecionadas simultaneamente.
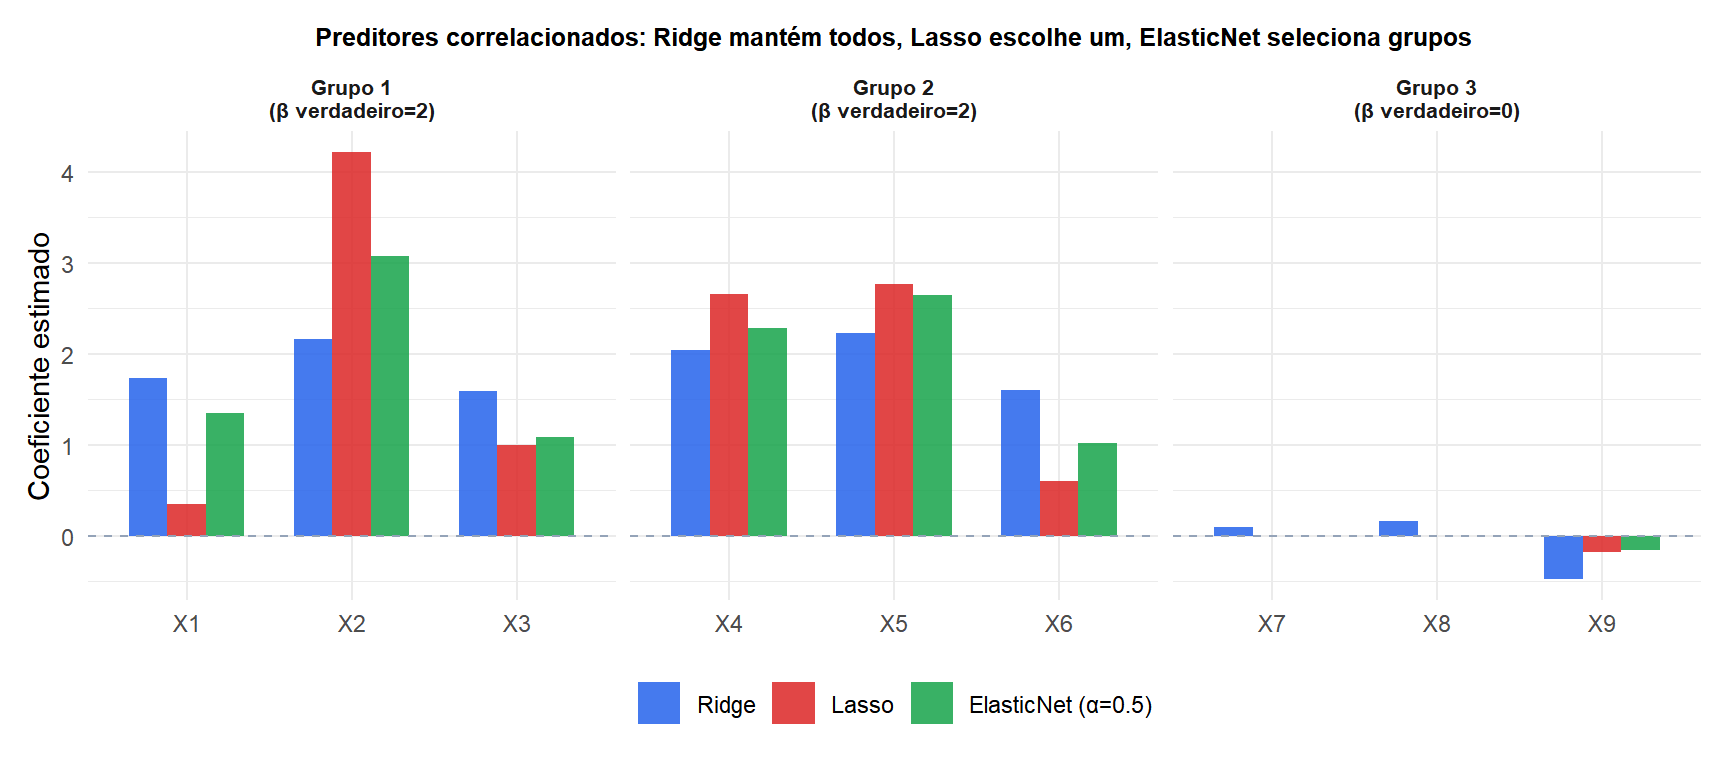
Com três grupos de preditores correlacionados: o Ridge (azul) mantém todos com coeficientes semelhantes; o Lasso (vermelho) escolhe um por grupo arbitrariamente; o ElasticNet (verde) seleciona o grupo em conjunto, atribuindo coeficientes não nulos semelhantes a preditores correlacionados e zerando o grupo irrelevante.
Efeito do parâmetro de mistura \(\alpha\)
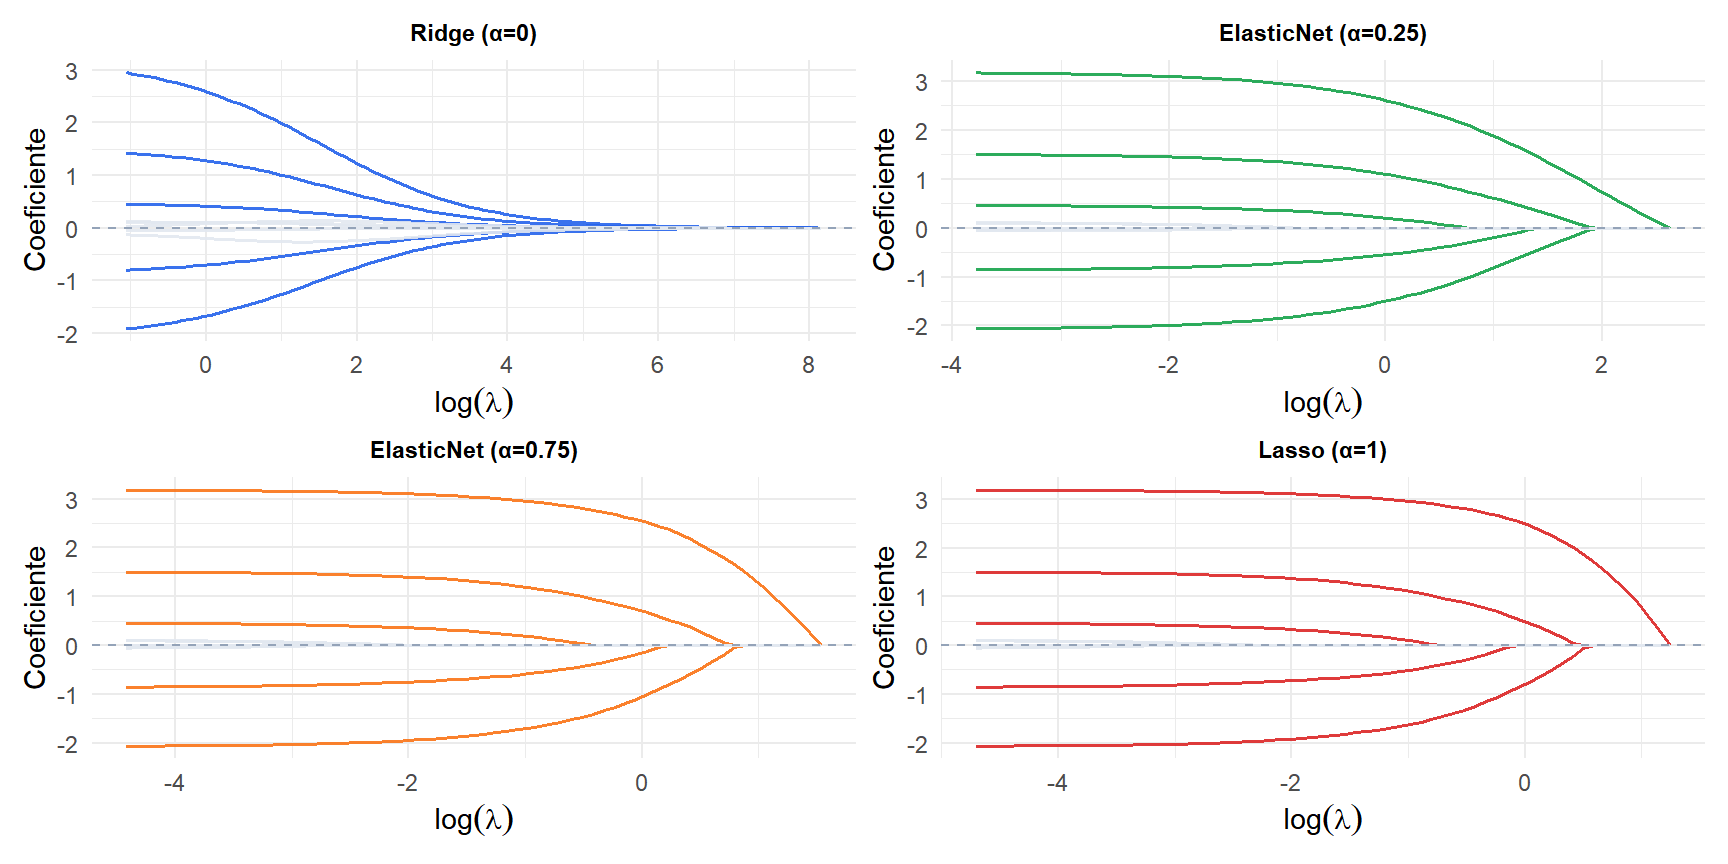
Conforme \(\alpha\) aumenta de 0 (Ridge) para 1 (Lasso), os caminhos dos coeficientes passam de um encolhimento suave para um limiar abrupto. Em \(\alpha=0,25\) e \(\alpha=0,75\) o comportamento é intermediário: alguns coeficientes chegam a zero, mas de forma menos abrupta do que o Lasso puro.
Selecionando \(\alpha\) e \(\lambda\)
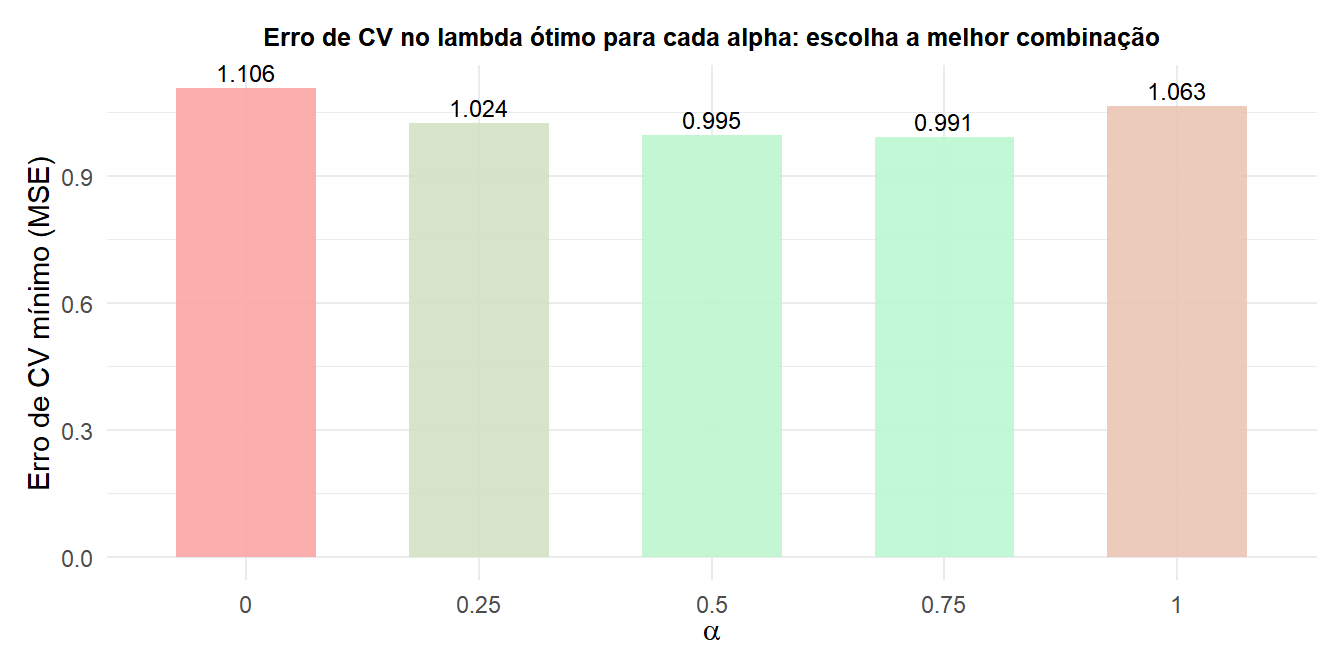
Tanto \(\alpha\) quanto \(\lambda\) precisam ser selecionados. A abordagem padrão é uma busca em grade aninhada com validação cruzada:
- Defina uma grade de valores de \(\alpha\) (por exemplo, 0, 0,1, 0,25, 0,5, 0,75, 0,9, 1).
- Para cada \(\alpha\), execute
cv.glmnetpara encontrar o \(\lambda\) ótimo. - Selecione o par \((\alpha, \lambda)\) com o menor erro de CV.
Ridge, Lasso ou ElasticNet?
| Situação | Método recomendado |
|---|---|
| Todos os preditores relevantes, sinal denso | Ridge |
| Sinal esparso, preditores independentes | Lasso |
| Sinal esparso, preditores correlacionados | ElasticNet |
| \(p \gg n\), muitos preditores relevantes | ElasticNet |
| Seleção de variáveis é o objetivo | Lasso ou ElasticNet |
| Apenas previsão, sem necessidade de interpretabilidade | Qualquer um; ajuste \(\alpha\) por CV |
Na prática, o ElasticNet com \(\alpha\) selecionado por CV raramente tem desempenho pior do que Ridge ou Lasso, porque inclui ambos como casos especiais. O custo é um hiperparâmetro extra.
⚠️ A penalização dupla muda a escala efetiva de lambda
A penalidade do ElasticNet é \(\lambda[\alpha|\beta_j| + (1-\alpha)\beta_j^2/2]\). O termo \(L_2\) encolhe os coeficientes mesmo quando \(\alpha\) está próximo de 1, o que significa que a regularização efetiva é mais forte do que o Lasso puro no mesmo \(\lambda\). Ao comparar modelos em diferentes valores de \(\alpha\), sempre compare no \(\lambda\) ótimo de CV para cada \(\alpha\), não no mesmo \(\lambda\) nominal.
Além disso: padronize os preditores antes de ajustar. O glmnet faz isso por padrão.
💡 ElasticNet em R
library(glmnet)

# Single alpha: ElasticNet with alpha=0.5
fit_en <- glmnet(X, y, alpha=0.5)
cv_en  <- cv.glmnet(X, y, alpha=0.5, nfolds=10)
coef(cv_en, s="lambda.min")

# Grid search over alpha and lambda
alphas <- c(0, 0.25, 0.5, 0.75, 1)
cv_list <- lapply(alphas, function(a)
  cv.glmnet(X, y, alpha=a, nfolds=10))

# Best combination
best_cvm <- sapply(cv_list, function(cv) min(cv$cvm))
best_alpha  <- alphas[which.min(best_cvm)]
best_lambda <- cv_list[[which.min(best_cvm)]]$lambda.min

# Fit final model
fit_final <- glmnet(X, y, alpha=best_alpha, lambda=best_lambda)
coef(fit_final)
