Regressão Lasso
O Lasso (Least Absolute Shrinkage and Selection Operator) adiciona uma penalidade \(L_1\) ao objetivo do MQO. A propriedade-chave que o distingue do Ridge: a penalidade \(L_1\) não é diferenciável em zero, o que força alguns coeficientes a exatamente zero. O Lasso é, portanto, simultaneamente um método de regularização e um método de seleção de variáveis.
Função objetivo
O Lasso substitui a penalidade ao quadrado do Ridge pela soma dos valores absolutos dos coeficientes, uma pequena mudança na fórmula com um grande efeito sobre a solução:
\[\hat{\boldsymbol{\beta}}^L = \arg\min_{\boldsymbol{\beta}} \|\mathbf{y} - \mathbf{X}\boldsymbol{\beta}\|_2^2 + \lambda\|\boldsymbol{\beta}\|_1 = \arg\min_{\boldsymbol{\beta}} \|\mathbf{y} - \mathbf{X}\boldsymbol{\beta}\|_2^2 + \lambda\sum_{j=1}^p |\beta_j|\]
Não há solução em forma fechada porque \(|\beta_j|\) não é diferenciável em \(\beta_j = 0\). O subdiferencial de \(|\beta_j|\) em zero é o intervalo \([-1, 1]\), o que permite que a solução se posicione exatamente em zero sem que a condição de gradiente seja violada.
Por que o L1 produz zeros exatos: soft-thresholding
Para o caso de desenho ortonormal (\(\mathbf{X}^T\mathbf{X} = \mathbf{I}\)), a solução do Lasso tem forma fechada: o operador de soft-thresholding:
\[\hat{\beta}_j^L = \text{sign}(\hat{\beta}_j^{\text{OLS}}) \cdot \max(|\hat{\beta}_j^{\text{OLS}}| - \lambda/2,\; 0)\]
Isso desloca todo coeficiente de MQO em direção a zero por \(\lambda/2\). Se \(|\hat{\beta}_j^{\text{OLS}}| \leq \lambda/2\), o coeficiente é fixado em exatamente zero. Compare com o Ridge, que usa um fator de encolhimento multiplicativo \(1/(1+\lambda)\) que nunca chega a zero.
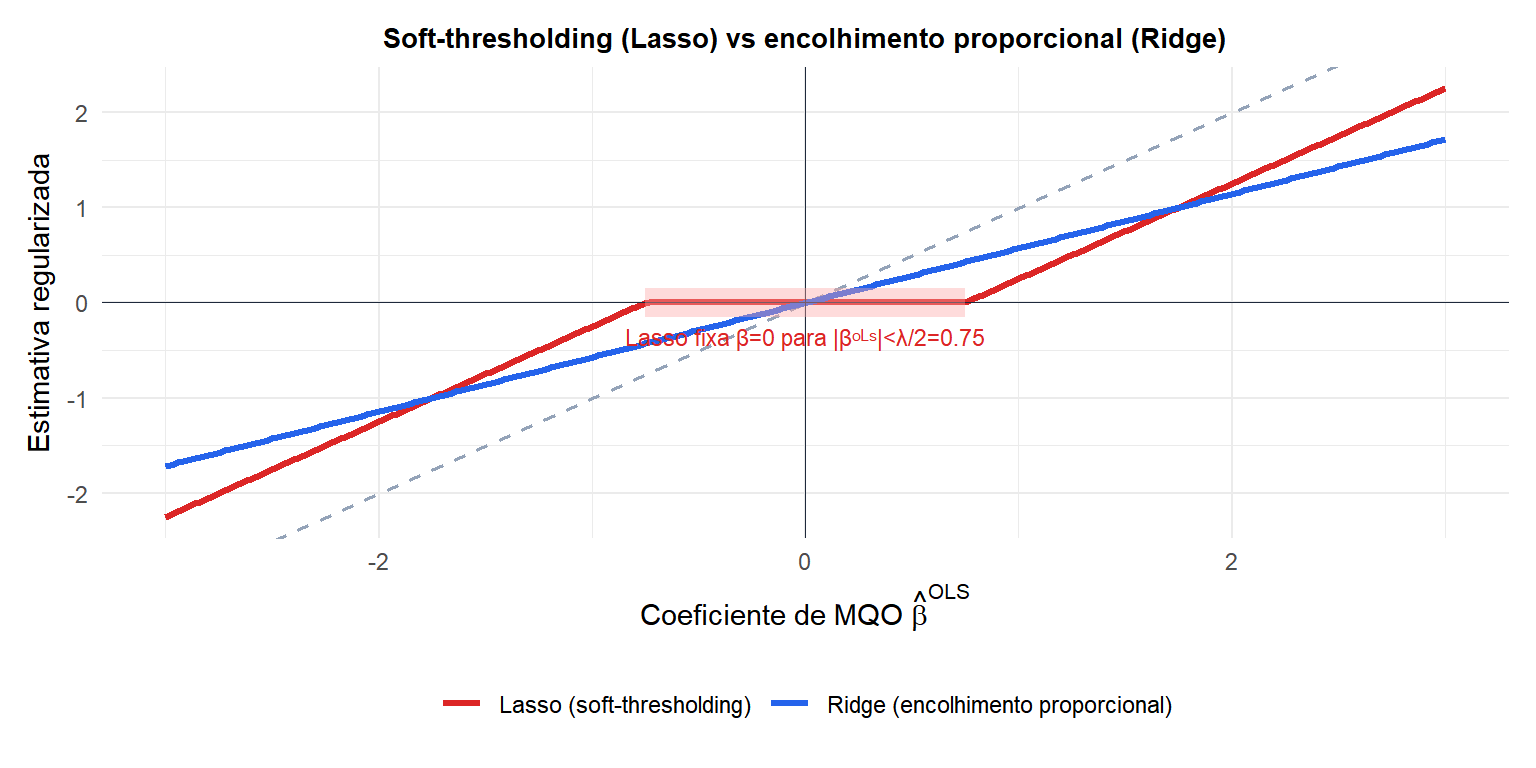
A zona vermelha mostra onde o Lasso fixa o coeficiente em exatamente zero. O Ridge (azul) sempre produz uma estimativa não nula, apenas reduzida em escala. A linha tracejada é a identidade (MQO).
Algoritmo de descida de coordenadas
O algoritmo padrão para ajustar o Lasso é a descida de coordenadas: percorre os preditores um por vez, minimizando o objetivo em relação a \(\beta_j\) enquanto mantém todos os outros fixos.
Para o preditor \(j\), o resíduo parcial é \(\mathbf{r}_j = \mathbf{y} - \sum_{k \neq j} \hat{\beta}_k \mathbf{x}_k\). A atualização é:
\[\hat{\beta}_j \leftarrow \frac{1}{n}\text{ST}\!\left(\mathbf{x}_j^T \mathbf{r}_j / n,\; \lambda/2\right)\]
em que \(\text{ST}\) é o operador de soft-thresholding. Isso é rápido e converge para o mínimo global, porque o objetivo do Lasso é convexo.
O caminho completo do Lasso (soluções para todos os \(\lambda\)) é calculado eficientemente pelo LARS (Least Angle Regression): conforme \(\lambda\) diminui de \(\infty\) para 0, as variáveis entram no modelo uma a uma. Isso fornece o caminho inteiro a um custo aproximadamente igual ao de um único ajuste de MQO.
Seleção de variáveis na prática
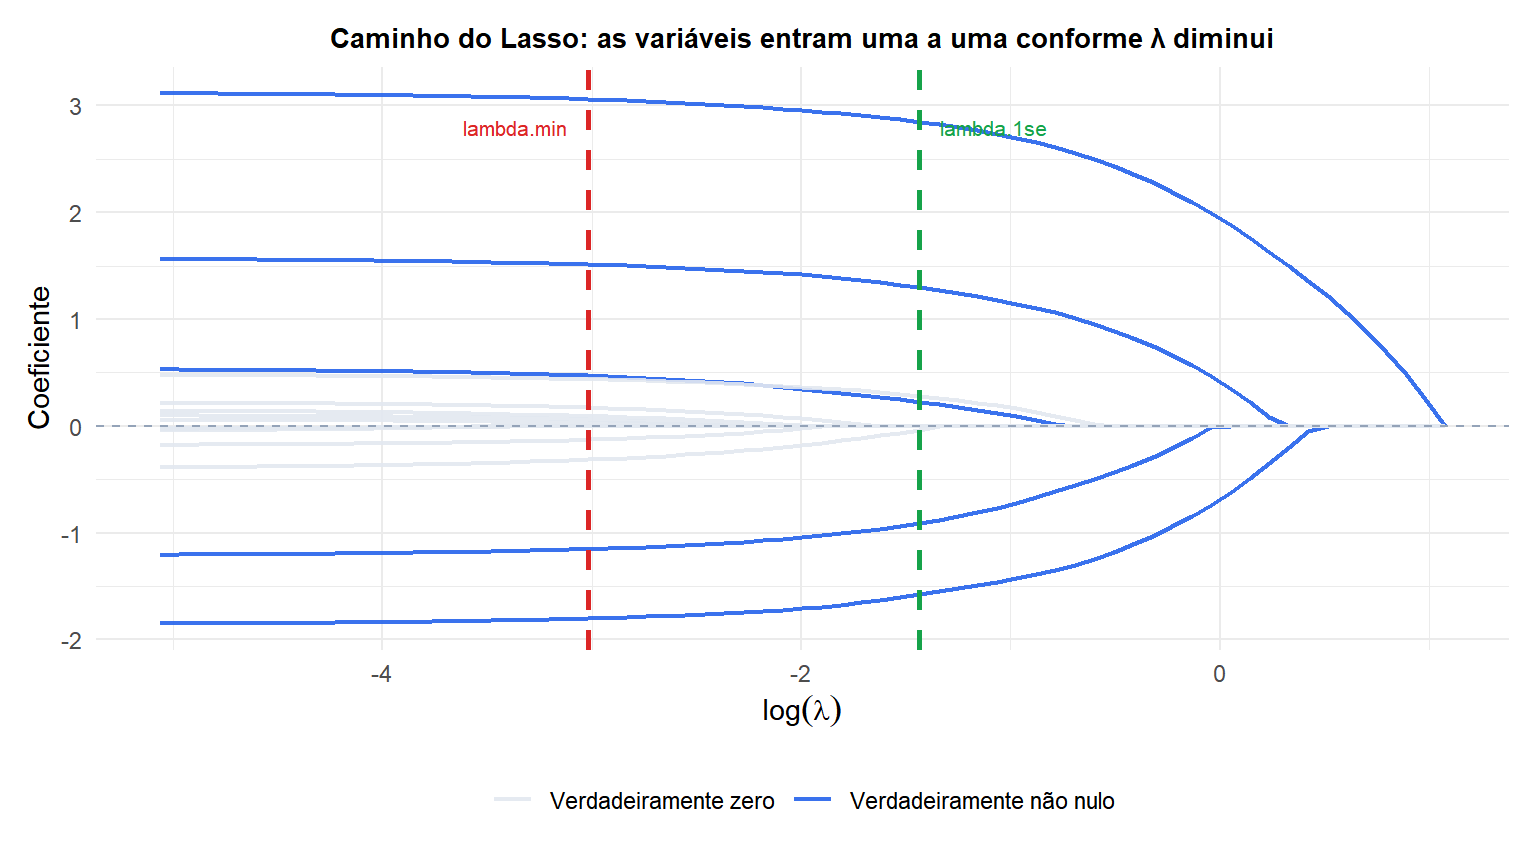
Os cinco preditores verdadeiramente não nulos (azul) entram no modelo primeiro conforme \(\lambda\) diminui. Os dez verdadeiros zeros (cinza) permanecem em zero até \(\lambda\) muito pequeno. O \(\lambda\) selecionado por CV identifica corretamente, de forma aproximada, a esparsidade correta.
Limitações do Lasso
Preditores correlacionados: seleção arbitrária
Quando dois preditores são altamente correlacionados e ambos são relevantes, o Lasso tende a selecionar um arbitrariamente e fixar o outro em zero. O preditor selecionado depende da variação aleatória nos dados. Isso torna o Lasso instável para seleção de atributos quando os preditores são correlacionados: execute o Lasso em dois conjuntos de dados semelhantes e você pode obter subconjuntos selecionados diferentes.
O Ridge trata melhor os preditores correlacionados, encolhendo ambos os coeficientes para valores semelhantes. O ElasticNet combina ambas as penalidades e seleciona grupos de preditores correlacionados juntos.
Quando \(p > n\): o Lasso seleciona no máximo \(n\) variáveis
Quando há mais preditores do que observações, o Lasso pode selecionar no máximo \(n\) variáveis (o posto de \(\mathbf{X}\)). Se o modelo verdadeiro tiver mais de \(n\) preditores relevantes, o Lasso deixará alguns de fora. O ElasticNet não tem essa restrição.
⚠️ A seleção do Lasso não é estável: use com cautela para inferência
A seleção de variáveis do Lasso é uma ferramenta de previsão, não um teste estatístico formal. O conjunto de variáveis selecionadas pode mudar substancialmente com pequenas perturbações nos dados (faça bootstrap da seleção de variáveis para ver quão estável ela é). Usar “o Lasso selecionou estas variáveis” como evidência de que elas são os verdadeiros preditores causais é problemático.
Para seleção de variáveis estável com valores-p válidos, considere: seleção por estabilidade, métodos de inferência pós-seleção (inferência seletiva), ou validação cruzada sobre todo o procedimento de seleção de variáveis.
💡 Lasso em R
library(glmnet)

# Fit Lasso (alpha=1)
fit_lasso <- glmnet(X, y, alpha=1)
plot(fit_lasso, xvar="lambda", label=TRUE)

# Select lambda by CV
cv_lasso <- cv.glmnet(X, y, alpha=1, nfolds=10)
plot(cv_lasso)

# Selected variables at lambda.1se (sparser, more conservative)
coef_selected <- coef(cv_lasso, s="lambda.1se")
selected_vars  <- rownames(coef_selected)[coef_selected[,1] != 0]

# Bootstrap stability of variable selection
library(dplyr)
B <- 200
selected_counts <- table(unlist(lapply(1:B, function(b) {
  idx <- sample(nrow(X), replace=TRUE)
  cv_b <- cv.glmnet(X[idx,], y[idx], alpha=1)
  cf   <- coef(cv_b, s="lambda.1se")
  rownames(cf)[cf[,1] != 0]
})))
# Variables selected in > 80% of bootstrap samples are stable
