Equilíbrio viés-variância
O equilíbrio viés-variância é a tensão central no aprendizado supervisionado. Todo erro de previsão pode ser decomposto em três componentes: viés (erro sistemático decorrente de suposições incorretas), variância (sensibilidade às flutuações do conjunto de treinamento) e ruído irredutível. Reduzir o viés tende a aumentar a variância, e vice-versa. Entender esse equilíbrio orienta toda decisão sobre a complexidade do modelo, a regularização e a coleta de dados.
A decomposição viés-variância
Seja \(y = f(x) + \varepsilon\), em que \(f\) é a função verdadeira e \(\varepsilon \sim (0, \sigma^2)\) é ruído irredutível. Para um modelo \(\hat{f}\) treinado com o conjunto de dados \(\mathcal{D}\), o erro de previsão esperado em um ponto \(x\) é:
\[E\left[(y - \hat{f}(x))^2\right] = \underbrace{\left[f(x) - E[\hat{f}(x)]\right]^2}_{\text{Viés}^2} + \underbrace{E\left[\left(\hat{f}(x) - E[\hat{f}(x)]\right)^2\right]}_{\text{Variância}} + \underbrace{\sigma^2}_{\text{Ruído irredutível}}\]
A esperança é tomada sobre todos os possíveis conjuntos de treinamento \(\mathcal{D}\) do mesmo tamanho:
- Viés: o quanto a previsão média se afasta do valor verdadeiro. Erro decorrente de suposições incorretas incorporadas ao modelo (por exemplo, ajustar uma reta a dados não lineares).
- Variância: o quanto a previsão flutua entre diferentes conjuntos de treinamento. Um modelo com alta variância memoriza os dados de treinamento e não generaliza.
- Ruído irredutível \(\sigma^2\): a aleatoriedade inerente a \(y\) que nenhum modelo pode eliminar. Um limite inferior do erro de previsão, independentemente da complexidade do modelo.
O erro total esperado é a soma dos três. Viés e variância não podem ser minimizados simultaneamente com uma quantidade fixa de dados: esse é o equilíbrio.
Intuição: a analogia do alvo
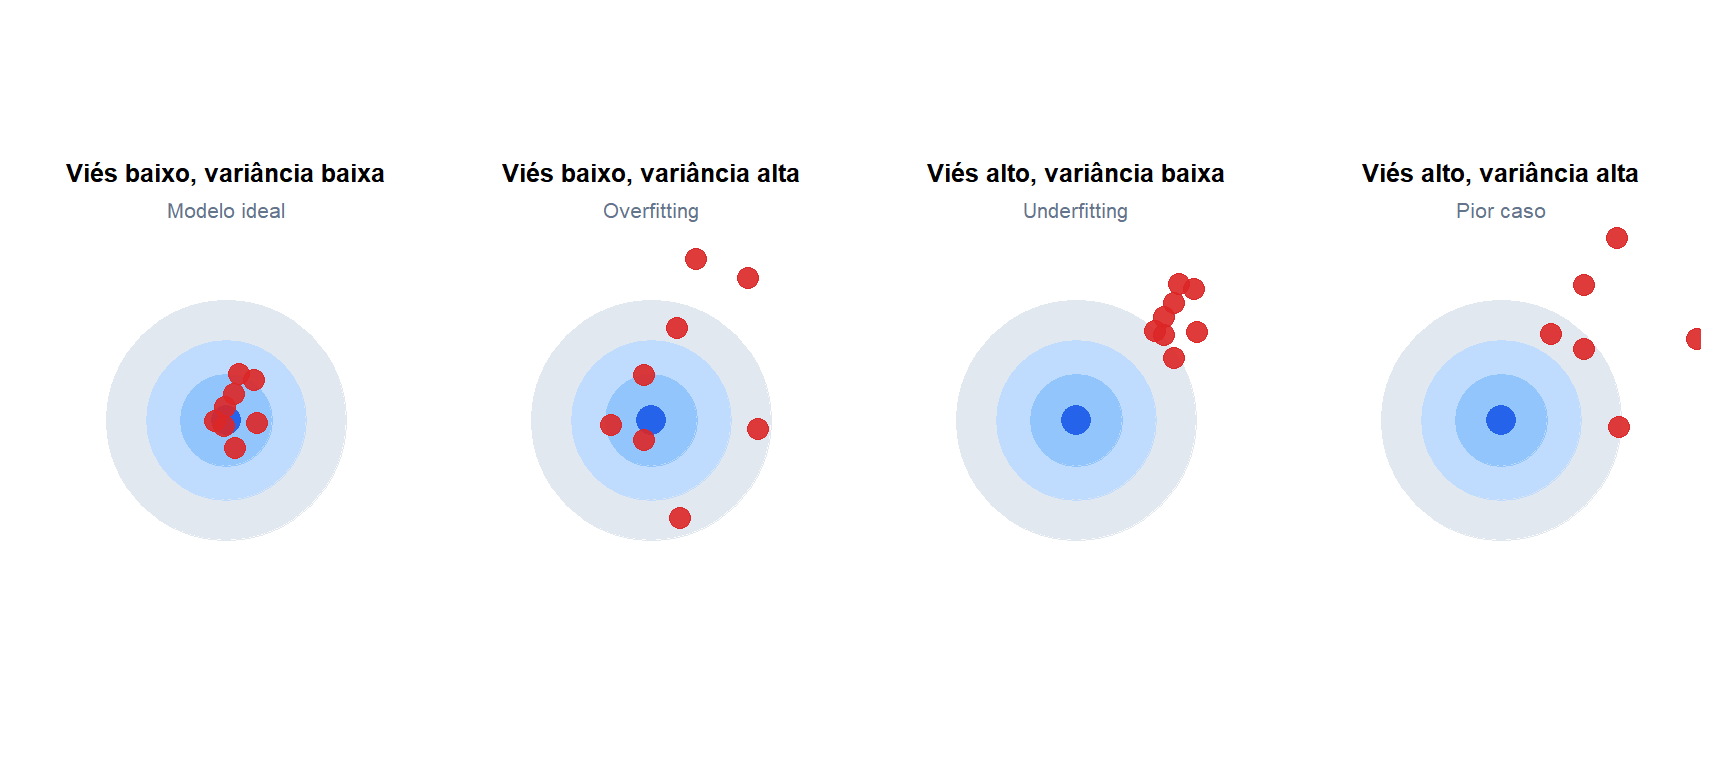
Tiros em um alvo: cada tiro é uma previsão de um modelo treinado com um conjunto de dados diferente. Viés baixo significa que os tiros estão centrados na mosca. Variância baixa significa que os tiros estão bem agrupados. O modelo ideal (acima à esquerda) alcança ambos.
Complexidade do modelo e o equilíbrio
À medida que a complexidade do modelo aumenta (mais parâmetros, grau polinomial maior, menos restrições de regularização):
- O viés diminui: o modelo é flexível o suficiente para capturar o padrão real.
- A variância aumenta: o modelo é sensível ao conjunto de treinamento específico e ajusta o ruído.
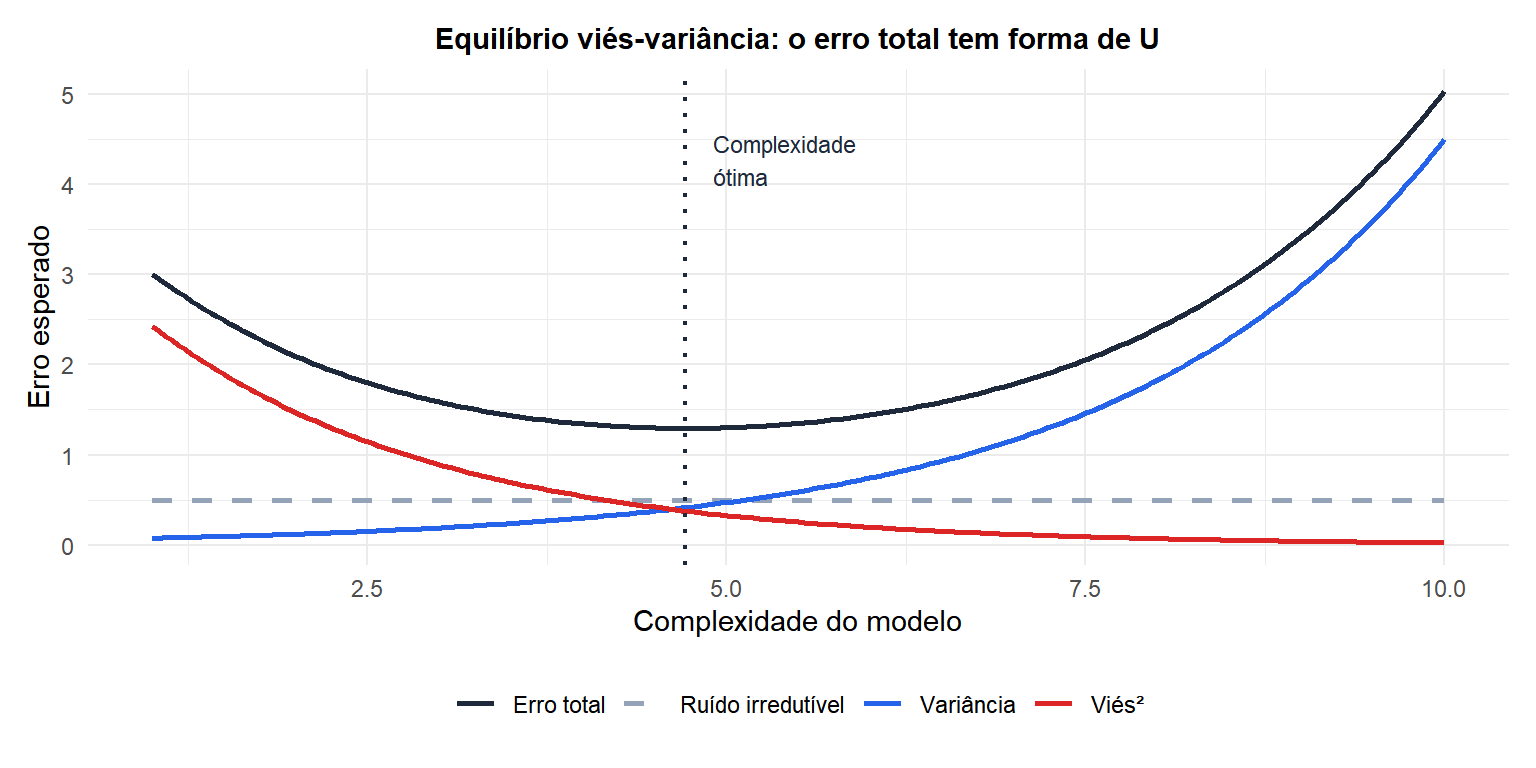
O erro total (preto) tem forma de U. A complexidade ótima minimiza a soma de viés e variância. Muito simples (esquerda): o alto viés domina. Muito complexo (direita): a alta variância domina. O ruído irredutível (cinza tracejado) estabelece o piso.
Exemplo concreto: regressão polinomial
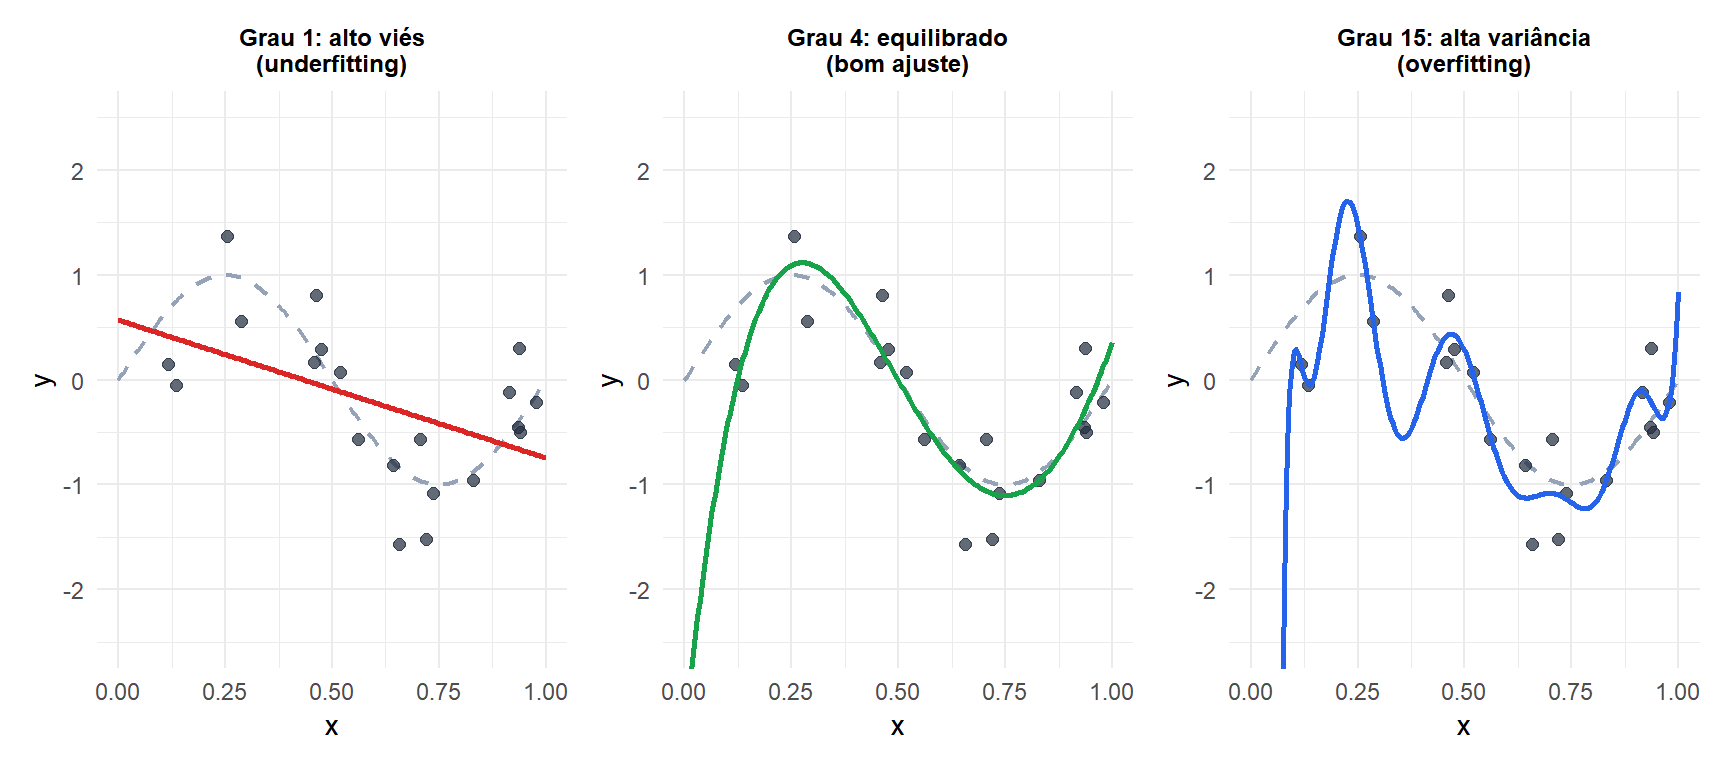
Cinza tracejado: função verdadeira \(\sin(2\pi x)\). Pontos pretos: dados de treinamento com ruído. Vermelho (grau 1) não capta o padrão: alto viés. Verde (grau 4) se aproxima bem da função real. Azul (grau 15) passa por todos os pontos de treinamento, mas oscila violentamente: alta variância.
Gerenciando o equilíbrio na prática
Várias estratégias abordam diretamente o equilíbrio viés-variância:
Reduzindo a variância (a algum custo de viés):
- Regularização (Ridge, Lasso): penaliza a complexidade do modelo, encolhendo os coeficientes em direção a zero. Aumenta levemente o viés, reduz substancialmente a variância.
- Métodos de ensemble (random forests, bagging): calcula a média das previsões de muitos modelos de alta variância para reduzi-la sem aumentar o viés.
- Mais dados de treinamento: a variância diminui como \(O(1/n)\); o viés não é afetado. A solução mais confiável quando há dados disponíveis.
- Dropout (redes neurais): desativa neurônios aleatoriamente durante o treinamento, atuando como um ensemble implícito.
Reduzindo o viés (a algum custo de variância):
- Modelos mais complexos: mais parâmetros, polinômios de grau mais alto, redes mais profundas.
- Engenharia de atributos: adicionar variáveis relevantes que o modelo não estava considerando.
- Boosting: constrói modelos sequencialmente que corrigem o viés dos anteriores (XGBoost, AdaBoost).
⚠️ A validação cruzada estima o erro total, não viés e variância separadamente
O erro de teste (estimado por validação cruzada) é a soma de viés, variância e ruído. Um modelo com baixo erro de teste pode alcançá-lo por baixo viés, baixa variância, ou ambos. Não é possível observar os componentes individuais a partir apenas do erro de teste.
Para decompor empiricamente viés e variância, são necessários múltiplos conjuntos de treinamento da mesma distribuição: treinar o modelo em cada um, calcular as previsões nos mesmos pontos de teste e, então, estimar o viés como a diferença ao quadrado entre a previsão média e a verdade, e a variância como a dispersão das previsões entre os conjuntos de treinamento. Na prática, isso raramente é viável; a decomposição é principalmente um guia teórico.
💡 O equilíbrio viés-variância e a seleção de modelos
Use o seguinte esquema mental ao escolher entre modelos:
- Erro alto no treinamento e no teste: alto viés. O modelo é muito simples. Experimente mais complexidade, mais variáveis ou uma classe de modelo diferente.
- Erro baixo no treinamento, erro alto no teste: alta variância. O modelo sofre overfitting. Experimente regularização, mais dados ou um modelo mais simples.
- Ambos os erros são semelhantes e aceitáveis: o modelo generaliza bem. O equilíbrio está bem gerenciado.
A diferença entre o erro de treinamento e o de teste é um indicador direto da variância. O nível do erro de treinamento é um indicador do viés (em relação ao piso de ruído irredutível).

