Gradient boosting e XGBoost
O gradient boosting constrói um modelo aditivo ajustando sequencialmente árvores de decisão superficiais ao gradiente negativo da função de perda. Cada árvore corrige os erros do ensemble atual. O XGBoost refina isso com uma expansão de Taylor de segunda ordem da perda, regularização explícita sobre os pesos das folhas, e uma subamostragem de colunas que reduz ainda mais o overfitting. Juntos, são o algoritmo dominante em competições de dados tabulares.
A ideia central: gradiente descendente funcional
Em vez de minimizar a perda atualizando parâmetros (como no gradiente descendente), o boosting minimiza a perda adicionando funções. A previsão no passo \(m\) é:
\[F_m(\mathbf{x}) = F_{m-1}(\mathbf{x}) + \eta \cdot h_m(\mathbf{x})\]
em que \(h_m\) é a nova árvore e \(\eta\) é a taxa de aprendizado (shrinkage). A árvore \(h_m\) é ajustada ao gradiente negativo da perda avaliado nas previsões atuais:
\[r_i^{(m)} = -\left[\frac{\partial \mathcal{L}(y_i, F(\mathbf{x}_i))}{\partial F(\mathbf{x}_i)}\right]_{F=F_{m-1}}\]
Para a perda de erro quadrático \(\mathcal{L} = (y_i - F(\mathbf{x}_i))^2/2\): \(r_i^{(m)} = y_i - F_{m-1}(\mathbf{x}_i)\). As árvores são ajustadas aos resíduos, por isso as primeiras descrições do boosting falavam de “ajustar resíduos”. A visão do gradiente generaliza isso para qualquer perda diferenciável: log-loss para classificação, erro absoluto para regressão robusta, e assim por diante.
A analogia com o gradiente descendente: o gradiente descendente se move na direção do gradiente negativo no espaço de parâmetros; o gradiente descendente funcional se move na direção do gradiente negativo no espaço de funções, adicionando uma árvore que aponta nessa direção.
O algoritmo de gradient boosting
Transformando a ideia do gradiente descendente funcional em um laço concreto, cada iteração ajusta uma nova árvore aos pseudo-resíduos atuais e a adiciona ao ensemble:
- Inicialize \(F_0(\mathbf{x}) = \arg\min_\gamma \sum_i \mathcal{L}(y_i, \gamma)\) (por exemplo, a média de \(y\) para regressão).
- Para \(m = 1, \ldots, M\):
- Calcule os pseudo-resíduos \(r_i^{(m)} = -\partial\mathcal{L}/\partial F(\mathbf{x}_i)|_{F_{m-1}}\).
- Ajuste uma árvore superficial \(h_m\) a \(\{(\mathbf{x}_i, r_i^{(m)})\}\).
- Atualize \(F_m = F_{m-1} + \eta \cdot h_m\).
- Retorne \(F_M\).
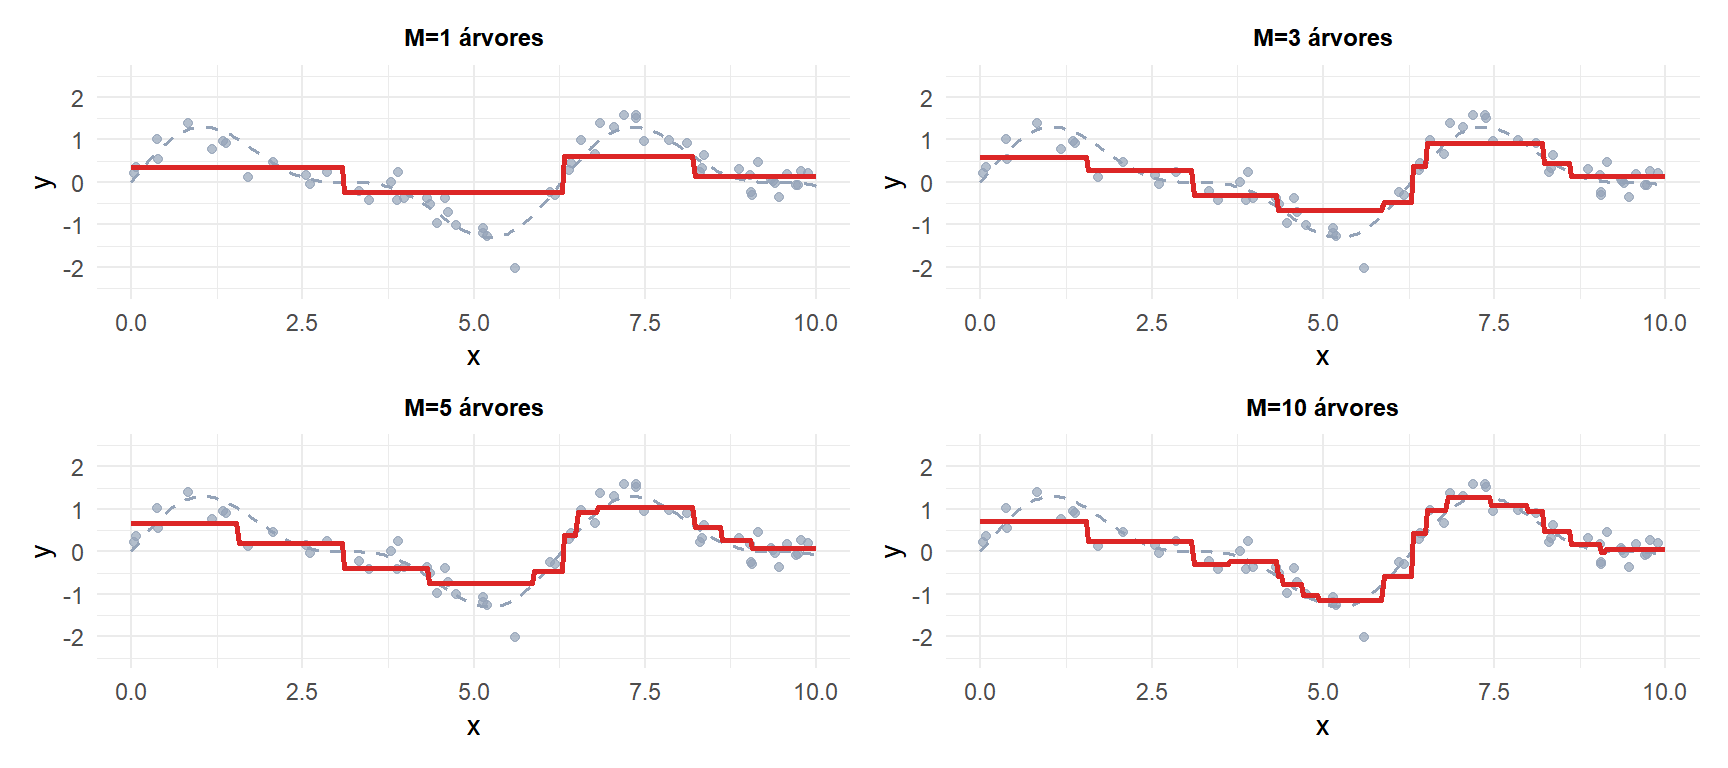
Com apenas 1 árvore (superior esquerdo) o ajuste é muito tosco. Conforme mais árvores são adicionadas, o ensemble acompanha progressivamente a função verdadeira (cinza tracejado). A curva vermelha é a previsão atual do ensemble.
Regularização: os três controles
O gradient boosting pode sofrer overfitting severamente sem regularização. Três controles-chave:
Taxa de aprendizado \(\eta\) (shrinkage)
Cada árvore contribui com \(\eta \cdot h_m\) em vez de \(h_m\). \(\eta\) menor exige mais árvores, mas produz melhor generalização. A combinação ótima é \(\eta\) pequeno + \(M\) grande com parada antecipada. Valores típicos: 0,01 a 0,3.
Gradient boosting estocástico (subamostragem de linhas)
Em cada iteração, apenas uma fração aleatória \(s\) das observações de treinamento (sem reposição) é usada para ajustar a árvore. Isso introduz aleatoriedade que reduz o overfitting e acelera o treinamento. Valores típicos: \(s = 0,5\) a \(0,8\).
Profundidade da árvore
Árvores superficiais (profundidade 1-6) são o padrão. Uma árvore de profundidade 1 (stump) ajusta apenas efeitos principais; árvores de profundidade 2 ajustam interações de pares; árvores mais profundas ajustam interações de ordem mais alta. O boosting tipicamente tem melhor desempenho com árvores superficiais: a maior parte da complexidade vem de combinar muitas árvores, não de árvores individuais profundas.
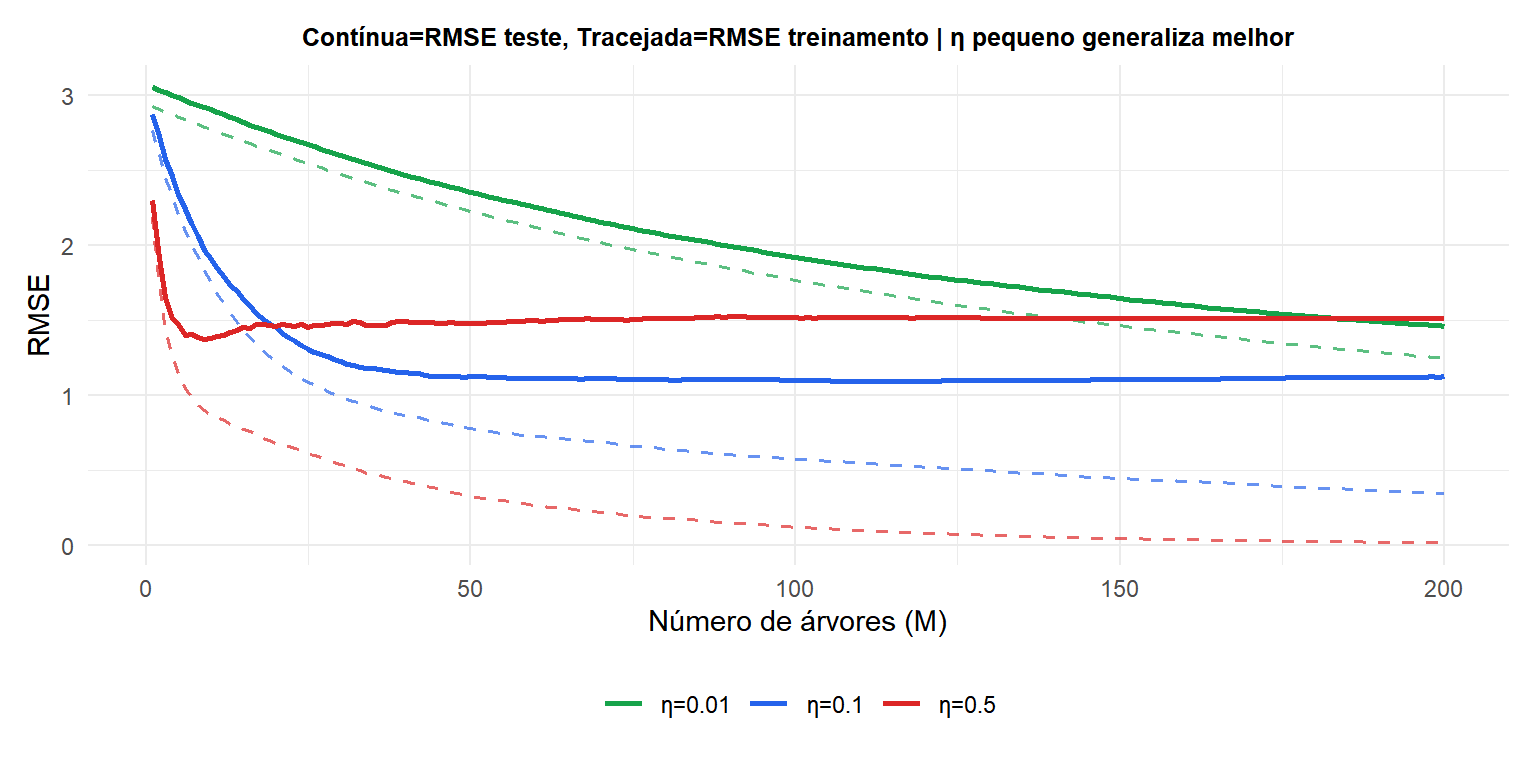
\(\eta=0{,}5\) grande (vermelho) ajusta os dados de treinamento rapidamente, mas o erro de teste sobe rápido: overfitting. \(\eta=0{,}01\) pequeno (verde) desce lentamente, mas alcança um piso de erro de teste menor com mais árvores. \(\eta=0{,}1\) médio (azul) equilibra ambos.
XGBoost: otimização de segunda ordem
O gradient boosting padrão usa apenas a primeira derivada (gradiente) para ajustar cada árvore. O XGBoost usa uma expansão de Taylor de segunda ordem da perda:
\[\mathcal{L}^{(m)} \approx \sum_i \left[g_i f_m(\mathbf{x}_i) + \frac{1}{2}h_i f_m(\mathbf{x}_i)^2\right] + \Omega(f_m)\]
em que \(g_i = \partial\mathcal{L}/\partial \hat{y}_i\) e \(h_i = \partial^2\mathcal{L}/\partial \hat{y}_i^2\) são a primeira e a segunda derivadas da perda na previsão atual, e:
\[\Omega(f_m) = \gamma T + \frac{1}{2}\lambda\sum_{j=1}^T w_j^2\]
penaliza o número de folhas \(T\) e os pesos ao quadrado das folhas \(w_j\) com os parâmetros \(\gamma\) e \(\lambda\).
Essa formulação dá um peso ótimo em forma fechada para cada folha \(j\):
\[w_j^* = -\frac{\sum_{i \in \text{folha}_j} g_i}{\sum_{i \in \text{folha}_j} h_i + \lambda}\]
e um ganho exato para cada divisão candidata, tornando a construção da árvore mais rápida e melhor calibrada do que os métodos de primeira ordem.
Melhorias adicionais do XGBoost sobre o GBDT clássico:
- Subamostragem de colunas (atributos) no nível da árvore e da divisão (como a random forest).
- Busca de divisão com consciência de esparsidade: trata valores ausentes e dados esparsos nativamente.
- Busca de divisão aproximada com sketches de quantis: mais rápida do que a busca exata para \(n\) grande.
- Validação cruzada e parada antecipada embutidas.
Random forest vs gradient boosting
| Random forest | Gradient boosting | |
|---|---|---|
| Construção da árvore | Paralela (independente) | Sequencial (dependente) |
| Profundidade da árvore | Profunda (completa) | Superficial (profundidade 3-6) |
| Viés | Baixo | Diminui com \(M\) |
| Variância | Reduzida pela média | Controlada por \(\eta\), profundidade, subamostragem |
| Risco de overfitting | Baixo (regularizada naturalmente) | Alto sem ajuste cuidadoso |
| Complexidade de ajuste | Baixa (principalmente mtry) |
Maior (muitos hiperparâmetros) |
| Velocidade de treinamento | Rápida (paralelizável) | Mais lenta (sequencial) |
| Acurácia típica | Muito boa | Melhor em dados tabulares |
A random forest é uma escolha padrão mais segura: menos ajuste, mais difícil de sofrer overfitting. O gradient boosting com XGBoost tipicamente alcança maior acurácia, mas exige seleção cuidadosa de hiperparâmetros.
⚠️ Sempre use parada antecipada com gradient boosting
Sem parada antecipada, o gradient boosting eventualmente sofrerá overfitting conforme \(M\) aumenta: o erro de treinamento continua caindo enquanto o erro de teste sobe. Sempre reserve um conjunto de validação ou use validação cruzada com parada antecipada:
- Monitore a métrica de validação em cada rodada.
- Pare quando o erro de validação não tiver melhorado por \(k\) rodadas consecutivas (tipicamente \(k=10\) a \(50\)).
- Use o modelo da melhor rodada de validação, não o da última.
Com \(\eta\) pequeno (por exemplo, 0,01), você pode precisar de milhares de árvores antes que a parada antecipada seja acionada: esse é o comportamento esperado.
💡 Gradient boosting em R
library(xgboost)

dtrain <- xgb.DMatrix(X_train, label=y_train)
dval   <- xgb.DMatrix(X_val,   label=y_val)

params <- list(
  eta           = 0.05,
  max_depth     = 5,
  subsample     = 0.8,
  colsample_bytree = 0.8,
  lambda        = 1,       # L2 on leaf weights
  gamma         = 0,       # min gain to split
  objective     = "binary:logistic",
  eval_metric   = "auc"
)

fit <- xgb.train(
  params    = params,
  data      = dtrain,
  nrounds   = 1000,
  watchlist = list(train=dtrain, val=dval),
  early_stopping_rounds = 30,
  verbose   = 1
)

# Feature importance
xgb.importance(model=fit)
xgb.plot.importance(xgb.importance(model=fit), top_n=15)

# Cross-validation (no separate val set needed)
cv <- xgb.cv(params=params, data=dtrain, nfold=5,
              nrounds=1000, early_stopping_rounds=30)
best_nrounds <- cv$best_iteration
