Random forest
A random forest constrói um grande número de árvores de decisão profundas em amostras bootstrap dos dados, usando um subconjunto aleatório de atributos em cada divisão. A previsão final é o voto majoritário (classificação) ou a média (regressão) entre todas as árvores. Calcular a média de muitas árvores descorrelacionadas reduz drasticamente a variância, deixando o viés essencialmente inalterado, o que torna a random forest um dos algoritmos prontos para uso mais confiáveis em machine learning.
De uma única árvore ao bagging
Uma única árvore de decisão tem viés baixo, mas variância alta: pequenas mudanças nos dados de treinamento podem produzir uma árvore completamente diferente. A percepção-chave por trás do bagging (bootstrap aggregating): se calcularmos a média de muitos estimadores independentes e não viesados, a variância da média é \(\sigma^2/B\), em que \(B\) é o número de estimadores.
Para \(B\) árvores, cada uma com variância \(\sigma^2\) e correlação par a par \(\rho\), a variância da média é:
\[\text{Var}\!\left(\frac{1}{B}\sum_{b=1}^B \hat{f}_b(\mathbf{x})\right) = \rho\sigma^2 + \frac{1-\rho}{B}\sigma^2\]
Conforme \(B \to \infty\), o segundo termo desaparece. A variância restante é \(\rho\sigma^2\): a correlação entre as árvores estabelece um piso para o quanto o bagging pode ajudar. Árvores treinadas em amostras bootstrap dos mesmos dados são correlacionadas (todas usam os mesmos preditores fortes), então o bagging por si só deixa uma variância substancial.
A inovação da random forest: em cada divisão, apenas um subconjunto aleatório de \(m\) atributos é considerado (em vez de todos os \(p\)). Isso impede que preditores fortes dominem toda árvore, descorrelacionando o ensemble e reduzindo \(\rho\).
- Classificação: \(m = \lfloor\sqrt{p}\rfloor\) (padrão)
- Regressão: \(m = \lfloor p/3 \rfloor\) (padrão)
O algoritmo
Para \(b = 1, \ldots, B\):
- Extraia uma amostra bootstrap \(\mathcal{D}^*_b\) de tamanho \(n\) dos dados de treinamento (com reposição).
- Cresça uma árvore de decisão profunda em \(\mathcal{D}^*_b\). Em cada nó, selecione \(m\) atributos aleatoriamente e divida pelo melhor entre esses \(m\).
- Não faça pruning.
Para um novo ponto \(\mathbf{x}\):
\[\hat{f}^{RF}(\mathbf{x}) = \frac{1}{B}\sum_{b=1}^B \hat{f}_b(\mathbf{x}) \quad \text{(regressão)}\]
\[\hat{c}^{RF}(\mathbf{x}) = \text{voto majoritário}\{c_b(\mathbf{x})\}_{b=1}^B \quad \text{(classificação)}\]
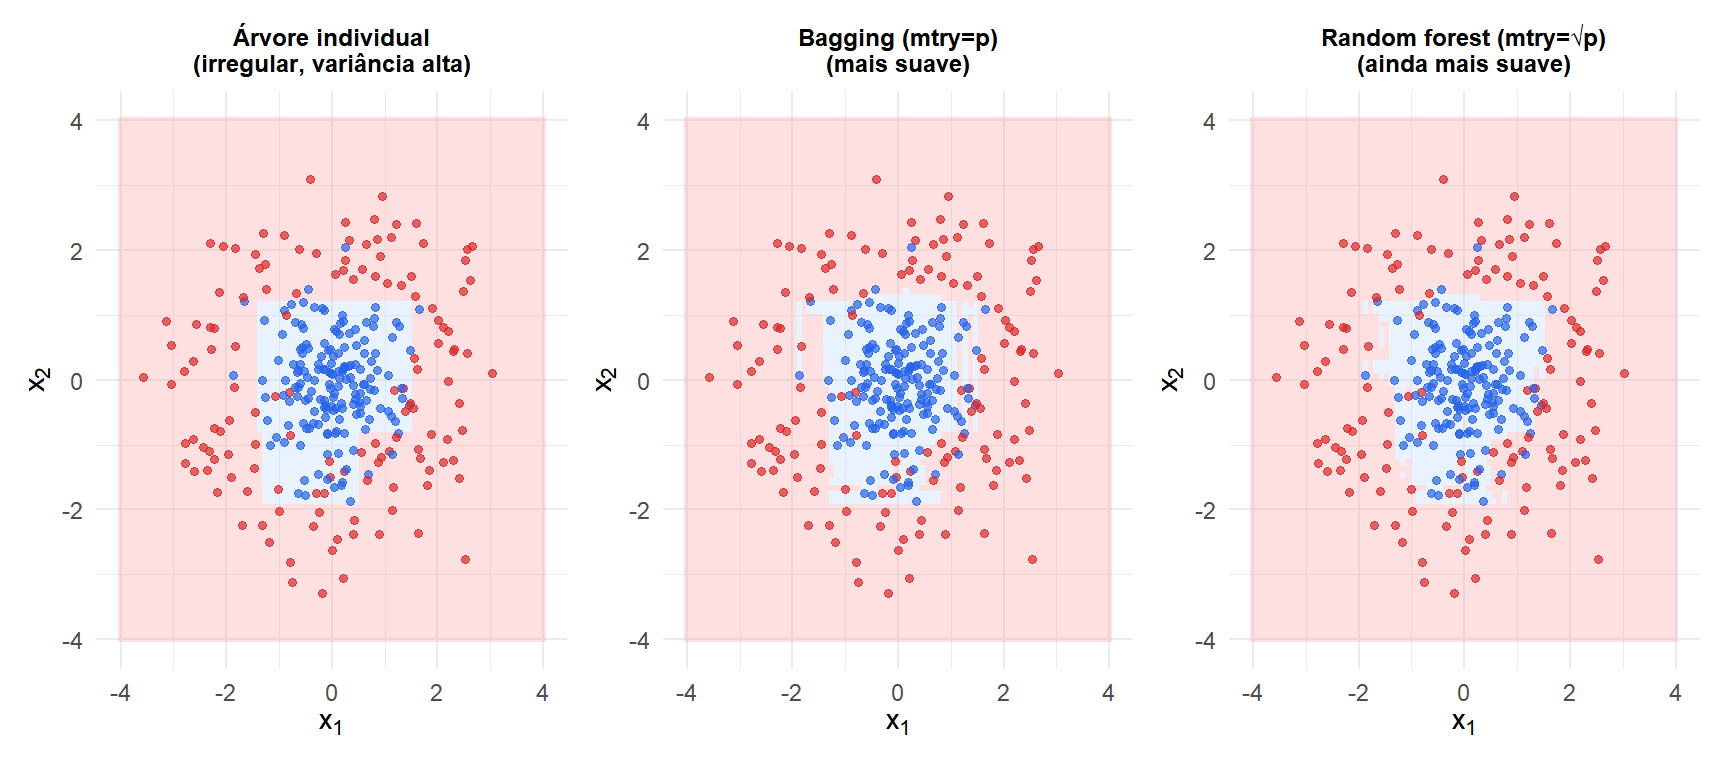
A árvore individual (esquerda) tem uma fronteira irregular que segue o ruído. O bagging (centro) a suaviza, mas árvores correlacionadas limitam a melhoria. A random forest (direita) produz a fronteira mais suave ao descorrelacionar as árvores por meio da subamostragem de atributos.
Erro out-of-bag
Cada amostra bootstrap omite aproximadamente \(1/e \approx 37\%\) das observações de treinamento (as observações out-of-bag). A árvore \(b\) não foi treinada em suas observações OOB, então elas podem ser usadas como um conjunto de validação:
\[\hat{f}^{OOB}(\mathbf{x}_i) = \frac{1}{|\{b: i \in \text{OOB}_b\}|} \sum_{b: i \in \text{OOB}_b} \hat{f}_b(\mathbf{x}_i)\]
O erro OOB calcula a média dos erros de previsão em todos os pontos de treinamento usando apenas as árvores que não viram aquele ponto. É uma estimativa quase não viesada do erro de teste, sem exigir um conjunto de validação separado.
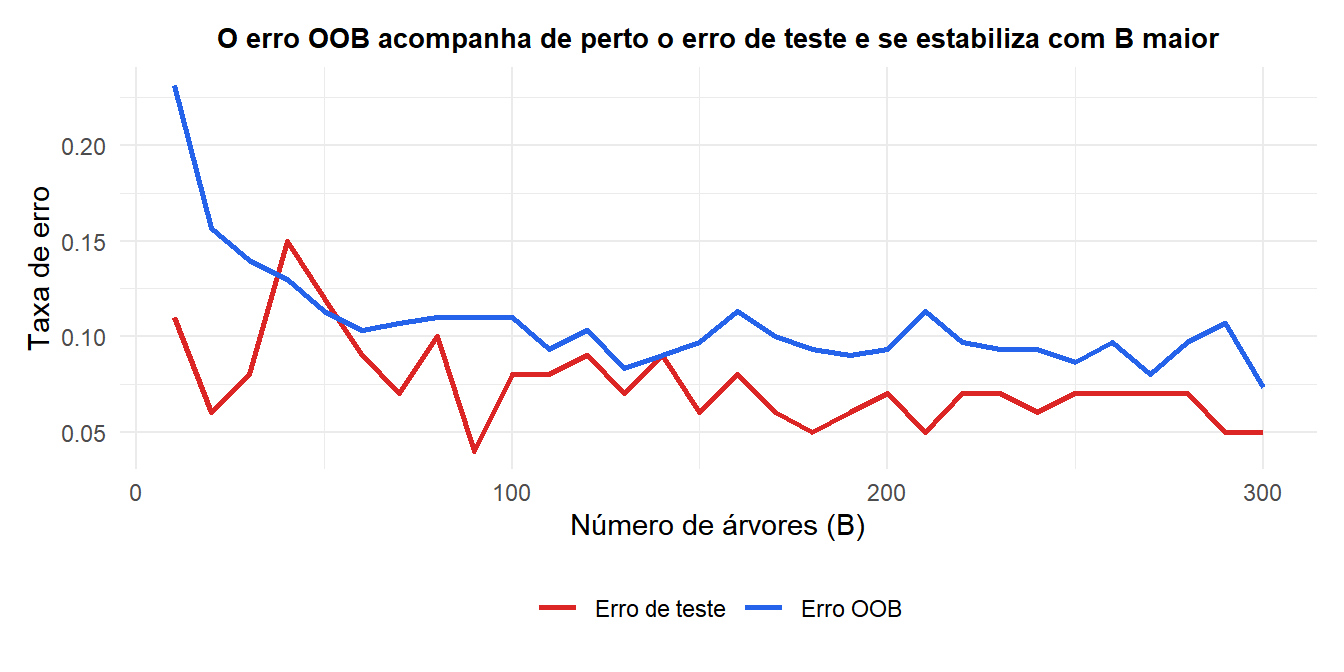
O erro OOB (azul) acompanha de perto o verdadeiro erro de teste (vermelho) sem exigir um conjunto de validação separado. Ambos se estabilizam depois de aproximadamente 100-200 árvores: adicionar mais árvores além desse ponto não melhora a acurácia, mas aumenta o tempo de computação.
Importância de atributos
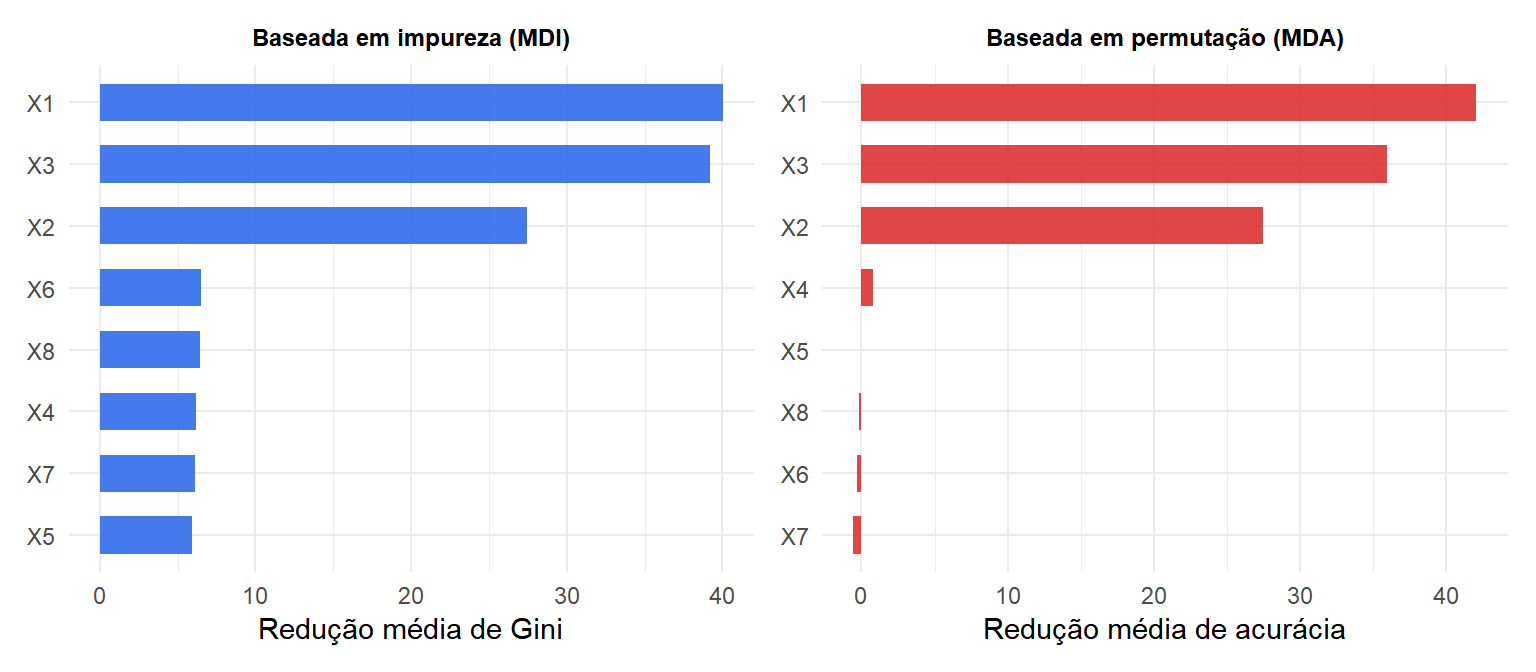
Importância baseada em impureza (redução média de impureza)
A importância do atributo \(j\) é a redução total na impureza do nó, ponderada pela proporção de amostras que chegam a cada nó, calculada em média sobre todas as árvores:
\[\text{MDI}(j) = \frac{1}{B}\sum_{b=1}^B \sum_{\text{nós em } j \text{ na árvore } b} \frac{n_\text{nó}}{n} \cdot \Delta G\]
Rápida de calcular. Tendenciosa em favor de atributos de alta cardinalidade: atributos com muitos valores únicos têm mais oportunidades de divisão e tendem a pontuar mais alto mesmo sem serem verdadeiramente importantes.
Importância por permutação (redução média de acurácia)
Para cada atributo \(j\): permute seus valores nas amostras OOB (rompendo a associação com a resposta), reclassifique, e meça o aumento no erro OOB. Atributos que importam causarão grandes aumentos de erro quando permutados:
\[\text{MDA}(j) = \frac{1}{B}\sum_{b=1}^B \left[\text{erro OOB após permutar } j \text{ na árvore } b\right] - \text{erro OOB}\]
Mais confiável do que a importância baseada em impureza: não é tendenciosa pela cardinalidade, mede a contribuição preditiva real em vez da estrutura da árvore.
Hiperparâmetros-chave
| Parâmetro | Padrão | Efeito |
|---|---|---|
ntree (\(B\)) |
500 | Mais árvores = menor variância, retornos decrescentes após ~200 |
mtry (\(m\)) |
\(\sqrt{p}\) / \(p/3\) | \(m\) menor = árvores mais descorrelacionadas, maior viés individual |
maxdepth |
Nenhum (completo) | Árvores mais superficiais = maior viés, menor variância |
nodesize |
1 (class.) / 5 (reg.) | Tamanho mínimo do nó antes de dividir |
mtry é o hiperparâmetro mais importante. Ajuste-o com o erro OOB: teste valores de 1 a \(p\) e escolha o que tiver o menor erro OOB.
⚠️ A importância de atributos da random forest pode ser enganosa com atributos correlacionados
Quando dois atributos são altamente correlacionados, permutar um não elimina sua informação (o outro atributo a carrega). Ambos os atributos podem parecer pouco importantes mesmo que o par tenha, em conjunto, alto poder preditivo. Por outro lado, a importância baseada em impureza divide o crédito arbitrariamente entre eles.
Para estimativas de importância confiáveis com atributos correlacionados: use a importância por permutação condicional (pacote permimp), que condiciona nos valores dos atributos correlacionados ao permutar. Ou use os valores SHAP (pacote treeshap), que fornecem atribuições consistentes e fundamentadas teoricamente.
💡 Random forest em R
library(randomForest)

# Classification
fit <- randomForest(y ~ ., data=df_train,
                    ntree=500, mtry=floor(sqrt(ncol(df_train)-1)),
                    importance=TRUE)

# OOB error evolution
plot(fit)   # error rate vs number of trees

# Feature importance
importance(fit)
varImpPlot(fit)

# Tune mtry with OOB error
library(caret)
ctrl <- trainControl(method="oob")
fit_cv <- train(y ~ ., data=df_train, method="rf",
                trControl=ctrl,
                tuneGrid=data.frame(mtry=c(1,2,3,5,8)))
fit_cv$bestTune

# Regression forest
fit_reg <- randomForest(y ~ ., data=df_train, ntree=500)
fit_reg$mse   # OOB MSE per tree
