K vizinhos mais próximos (KNN)
O K vizinhos mais próximos (KNN) é o algoritmo de classificação mais simples: para classificar um novo ponto, encontre os \(k\) pontos de treinamento mais próximos e faça uma votação majoritária. Sem fase de treinamento, sem parâmetros a estimar, sem suposições distribucionais. O modelo inteiro são os próprios dados de treinamento. Sua simplicidade o torna uma excelente linha de base e uma lente útil para entender o equilíbrio viés-variância, em contraste com um método como as máquinas de vetores de suporte, que em vez disso ajustam uma fronteira explícita de margem máxima.
O algoritmo
Classificação: dado um novo ponto \(\mathbf{x}\), encontre os \(k\) pontos de treinamento mais próximos de \(\mathbf{x}\) sob alguma métrica de distância. Atribua a classe que aparece com mais frequência entre esses \(k\) vizinhos.
Regressão: a mesma busca por vizinhança, mas preveja a média (ou média ponderada) dos valores de resposta dos \(k\) vizinhos.
Regra de previsão formal para classificação:
\[\hat{y} = \arg\max_{c} \sum_{i \in \mathcal{N}_k(\mathbf{x})} \mathbf{1}[y_i = c]\]
em que \(\mathcal{N}_k(\mathbf{x})\) é o conjunto dos \(k\) vizinhos mais próximos de \(\mathbf{x}\).
O KNN é um aprendiz tardio (lazy learner): não faz nenhum trabalho no momento do treinamento e posterga todo o cálculo para o momento da previsão. Isso torna o treinamento instantâneo, mas a previsão lenta para conjuntos de dados grandes.
O efeito de k: o equilíbrio viés-variância
\(k\) é o único hiperparâmetro e controla diretamente a complexidade do modelo:
- \(k\) pequeno (por exemplo, \(k=1\)): cada ponto é sua própria vizinhança. A fronteira de decisão é altamente irregular, adaptando-se a cada ponto de treinamento, incluindo o ruído. Viés baixo, variância alta. Com \(k=1\), o erro de treinamento é sempre zero.
- \(k\) grande (por exemplo, \(k=n\)): todo ponto é classificado como a classe majoritária geral, independentemente da localização. Fronteira muito suave. Viés alto, variância baixa.
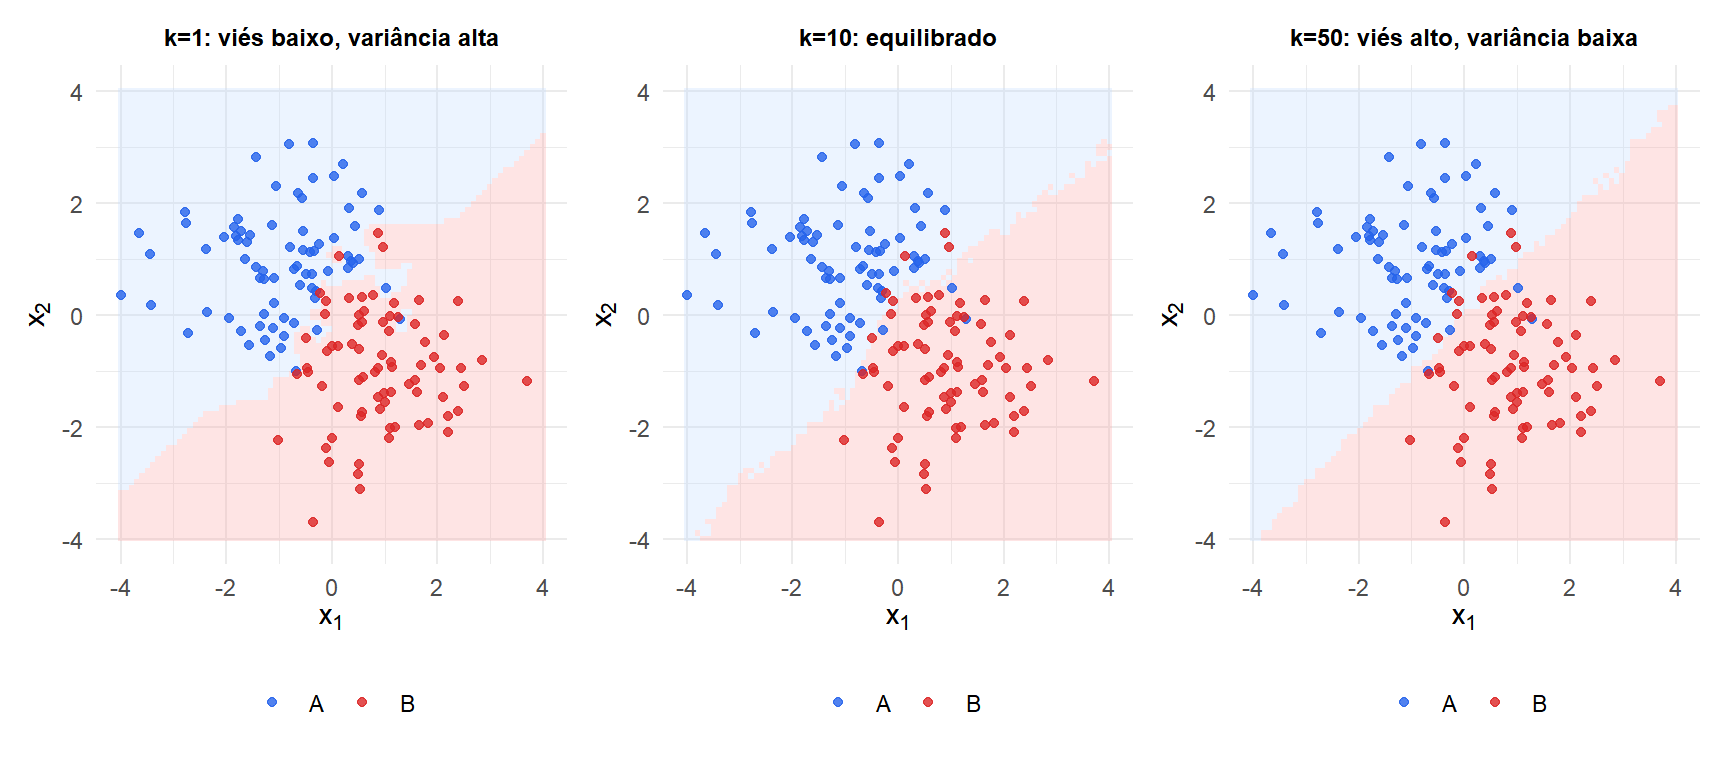
O \(k\) ótimo é selecionado por validação cruzada. Um ponto de partida comum: \(k = \sqrt{n}\), embora a CV quase sempre encontre um valor melhor.
Métricas de distância
O KNN é inteiramente definido pela métrica de distância escolhida. O resultado muda substancialmente com a métrica.
Distância de Minkowski (família geral):
\[d_p(\mathbf{x}, \mathbf{x}') = \left(\sum_{j=1}^p |x_j - x_j'|^p\right)^{1/p}\]
Casos especiais:
- \(p=1\): Distância de Manhattan (L1). Soma das diferenças absolutas. Menos sensível a outliers em atributos individuais.
- \(p=2\): Distância euclidiana (L2). Padrão mais comum. Sensível à escala.
- \(p \to \infty\): Distância de Chebyshev. Diferença absoluta máxima entre as dimensões.
Para atributos categóricos: distância de Hamming (proporção de atributos não correspondentes). Para tipos mistos: distância de Gower.
⚠️ Sempre padronize os atributos antes de aplicar o KNN
A distância euclidiana é dominada por atributos com escalas grandes. Se um atributo varia de 0 a 10.000 e outro de 0 a 1, o primeiro atributo controlará totalmente o cálculo da distância e o segundo será efetivamente ignorado.
Sempre padronize os atributos para média zero e variância unitária (ou reescale para [0,1]) antes de ajustar o KNN. Isso não é opcional: sem padronização, a escolha das unidades determina o modelo.
A maldição da dimensionalidade
O KNN depende da suposição de que pontos próximos no espaço de atributos são semelhantes. Em altas dimensões, essa suposição se rompe severamente.
Considere um hipercubo \([0,1]^d\) com \(n\) pontos de treinamento uniformemente distribuídos. Para capturar uma fração \(r\) do volume de dados para uma vizinhança, o comprimento esperado do lado da vizinhança hipercúbica é \(r^{1/d}\). Para \(r=0,01\) (1% dos dados):
- \(d=2\): comprimento do lado \(\approx 0,1\) (10% do intervalo por dimensão)
- \(d=10\): comprimento do lado \(\approx 0,63\) (63% do intervalo por dimensão)
- \(d=100\): comprimento do lado \(\approx 0,955\) (95,5% do intervalo por dimensão)
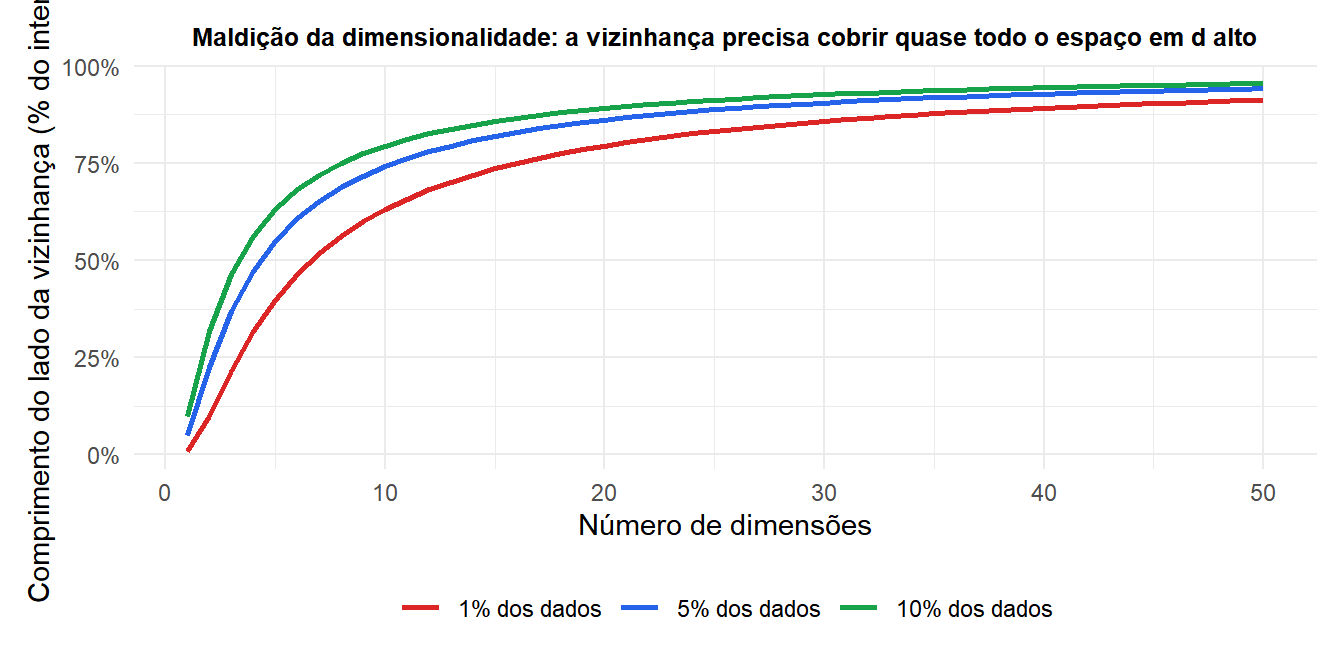
Em altas dimensões, os vizinhos mais próximos estão apenas marginalmente mais próximos do que os pontos mais distantes. Todos os pontos se tornam aproximadamente equidistantes, e o conceito de “proximidade” perde sentido. O desempenho do KNN se degrada rapidamente acima de \(d \approx 10\)-20 atributos.
KNN ponderado
O KNN padrão dá peso igual a todos os \(k\) vizinhos. O KNN ponderado dá mais peso aos vizinhos mais próximos:
\[\hat{y} = \arg\max_c \sum_{i \in \mathcal{N}_k(\mathbf{x})} w_i \cdot \mathbf{1}[y_i = c], \qquad w_i = \frac{1}{d(\mathbf{x}, \mathbf{x}_i)^2}\]
A ponderação pelo inverso da distância reduz a influência dos vizinhos mais distantes na vizinhança, frequentemente melhorando a acurácia sem alterar \(k\).
Complexidade computacional e estruturas de aceleração
O KNN ingênuo tem complexidade de previsão \(O(nd)\) por consulta: calcula a distância para todos os \(n\) pontos de treinamento em \(d\) dimensões. Para \(n\) ou \(d\) grandes, isso é lento.
Duas estruturas de dados reduzem esse custo:
kd-tree: uma árvore binária que particiona o espaço de atributos recursivamente, dividindo ao longo de uma dimensão por vez. Para \(d \leq 20\) e \(n\) grande, o tempo de consulta cai para \(O(d\log n)\) em média. O desempenho se degrada em altas dimensões.
Ball tree: particiona os pontos em hiperesferas aninhadas. Mais eficaz do que kd-trees em dimensões moderadas a altas.
Ambas as estruturas são construídas no momento do treinamento (\(O(nd\log n)\)) e consultadas no momento da previsão. Os pacotes FNN e class em R, e sklearn em Python, usam essas estruturas automaticamente.
💡 KNN em R
library(class)

# Standardize features
X_train_s <- scale(X_train)
X_test_s  <- scale(X_test,
                   center=attr(X_train_s,"scaled:center"),
                   scale =attr(X_train_s,"scaled:scale"))

# Classify with k=10
pred <- knn(train=X_train_s, test=X_test_s, cl=y_train, k=10)

# Select k by cross-validation
library(caret)
ctrl <- trainControl(method="cv", number=10)
fit  <- train(y ~ ., data=df, method="knn",
              trControl=ctrl,
              tuneGrid=data.frame(k=c(1,3,5,10,20,50)))
fit$bestTune

# Weighted KNN
library(kknn)
fit_w <- kknn(y ~ ., train=df_train, test=df_test, k=10,
              kernel="triangular")  # distance-weighted
