Máquinas de vetores de suporte (SVM)
As Máquinas de Vetores de Suporte encontram o hiperplano que separa duas classes com a maior margem possível. Os pontos mais próximos do hiperplano (os vetores de suporte) são os únicos que determinam sua posição: todos os outros pontos de treinamento são irrelevantes. O kernel trick estende as SVMs para fronteiras não lineares mapeando implicitamente os dados para um espaço de alta dimensão.
SVM de margem rígida
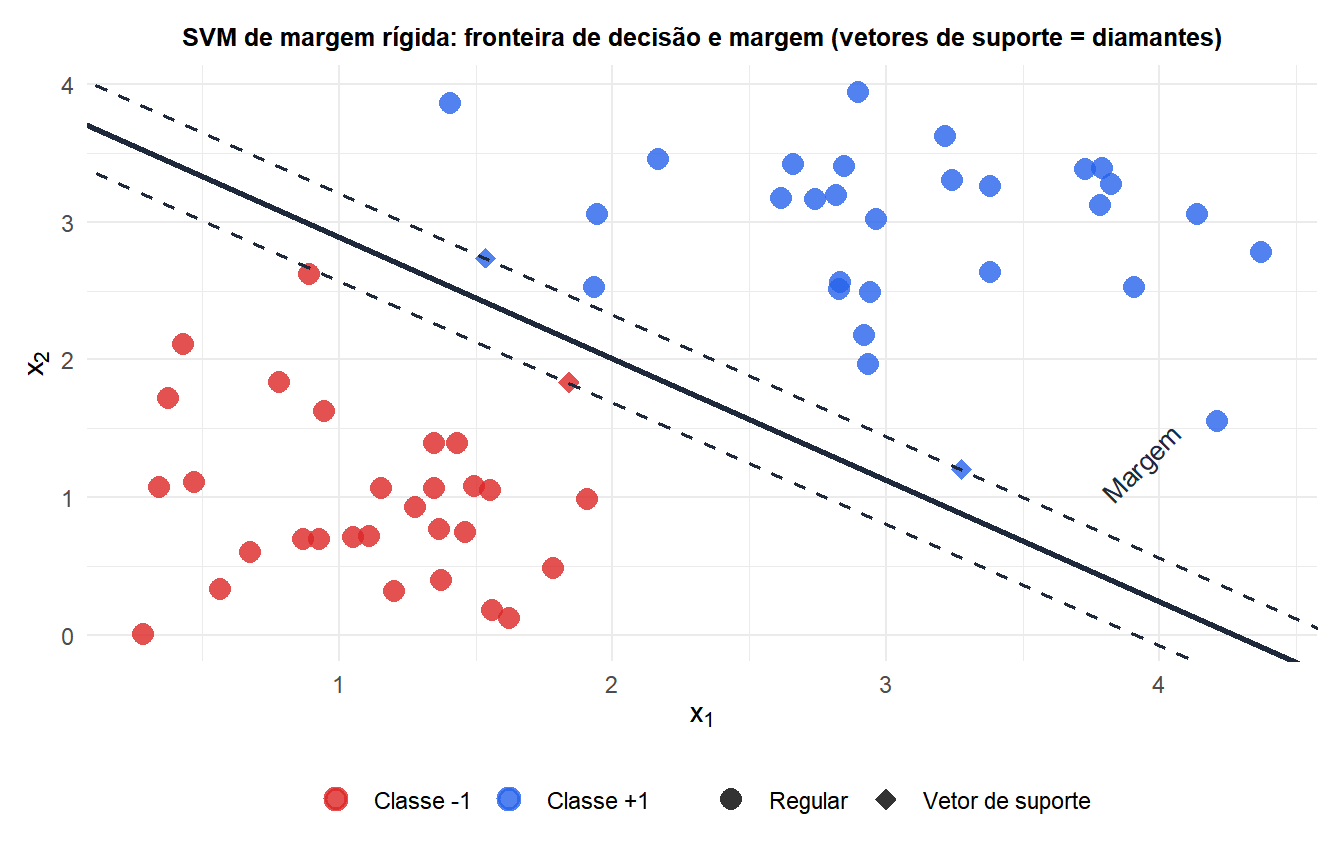
Para dados linearmente separáveis com rótulos \(y_i \in \{-1, +1\}\), a fronteira de decisão é um hiperplano \(\mathbf{w}^T\mathbf{x} + b = 0\). Pontos com \(y_i = +1\) devem satisfazer \(\mathbf{w}^T\mathbf{x}_i + b \geq +1\) e pontos com \(y_i = -1\) devem satisfazer \(\mathbf{w}^T\mathbf{x}_i + b \leq -1\). Combinando: \(y_i(\mathbf{w}^T\mathbf{x}_i + b) \geq 1\) para todo \(i\).
A largura da margem é \(2/\|\mathbf{w}\|\). Maximizar a margem é equivalente a minimizar \(\|\mathbf{w}\|^2\):
\[\min_{\mathbf{w},b} \frac{1}{2}\|\mathbf{w}\|^2 \quad \text{sujeito a} \quad y_i(\mathbf{w}^T\mathbf{x}_i + b) \geq 1 \quad \forall i\]
Esse é um programa quadrático convexo. As condições KKT dão o problema dual, e apenas os pontos de treinamento em que \(y_i(\mathbf{w}^T\mathbf{x}_i + b) = 1\) (sobre a fronteira da margem) têm variáveis duais não nulas \(\alpha_i > 0\): estes são os vetores de suporte. Todos os outros pontos são irrelevantes para a solução. Essa esparsidade é uma propriedade-chave: as previsões usam apenas os vetores de suporte.
SVM de margem suave
Dados reais raramente são linearmente separáveis. A SVM de margem suave introduz variáveis de folga \(\xi_i \geq 0\) que permitem que os pontos violem a restrição da margem:
\[\min_{\mathbf{w},b,\boldsymbol{\xi}} \frac{1}{2}\|\mathbf{w}\|^2 + C\sum_{i=1}^n \xi_i \quad \text{sujeito a} \quad y_i(\mathbf{w}^T\mathbf{x}_i + b) \geq 1 - \xi_i,\quad \xi_i \geq 0\]
O parâmetro \(C > 0\) controla a compensação:
- \(C\) grande: penaliza fortemente as violações da margem. Margem menor, mas menos classificações erradas nos dados de treinamento. Propenso a overfitting.
- \(C\) pequeno: tolera mais violações. Margem mais larga, mais regularizada. Propenso a underfitting.
\(C\) é o hiperparâmetro mais importante e deve ser selecionado por validação cruzada. Os vetores de suporte agora são pontos que estão na fronteira da margem (\(\xi_i = 0\), \(\alpha_i > 0\)) ou a violam (\(\xi_i > 0\)): a fração de vetores de suporte tipicamente aumenta conforme \(C\) diminui.
O problema dual e os kernels
O dual lagrangiano do problema de margem suave é:
\[\max_{\boldsymbol{\alpha}} \sum_i \alpha_i - \frac{1}{2}\sum_{i,j}\alpha_i\alpha_j y_i y_j \mathbf{x}_i^T\mathbf{x}_j \quad \text{sujeito a} \quad 0 \leq \alpha_i \leq C,\quad \sum_i \alpha_i y_i = 0\]
A observação-chave: o objetivo depende dos dados apenas por meio de produtos internos \(\mathbf{x}_i^T\mathbf{x}_j\). A previsão para um novo ponto também usa apenas produtos internos:
\[\hat{y}(\mathbf{x}) = \text{sinal}\!\left(\sum_{i \in SV} \alpha_i y_i \mathbf{x}_i^T\mathbf{x} + b\right)\]
O kernel trick: substitua cada produto interno \(\mathbf{x}_i^T\mathbf{x}_j\) por uma função kernel \(K(\mathbf{x}_i, \mathbf{x}_j) = \phi(\mathbf{x}_i)^T\phi(\mathbf{x}_j)\), em que \(\phi\) é um mapeamento de atributos implícito. Isso permite que a SVM opere em um espaço de atributos muito alto (ou infinito) sem nunca calcular \(\phi(\mathbf{x})\) explicitamente.
Kernels comuns
| Kernel | Fórmula | Quando usar |
|---|---|---|
| Linear | \(K(\mathbf{x},\mathbf{x}') = \mathbf{x}^T\mathbf{x}'\) | Linearmente separável, \(p\) alto |
| Polinomial | \(K(\mathbf{x},\mathbf{x}') = (\mathbf{x}^T\mathbf{x}' + c)^d\) | Interações polinomiais |
| RBF/Gaussiano | \(K(\mathbf{x},\mathbf{x}') = e^{-\gamma\|\mathbf{x}-\mathbf{x}'\|^2}\) | Não linear geral, o mais comum |
| Sigmoide | \(K(\mathbf{x},\mathbf{x}') = \tanh(\kappa\mathbf{x}^T\mathbf{x}' + c)\) | Semelhante a rede neural |
O kernel RBF com largura de banda \(\gamma\) é o mais usado. \(\gamma\) menor: fronteira mais suave (pontos mais distantes se influenciam). \(\gamma\) maior: cada ponto de treinamento influencia apenas sua vizinhança imediata, levando a overfitting.
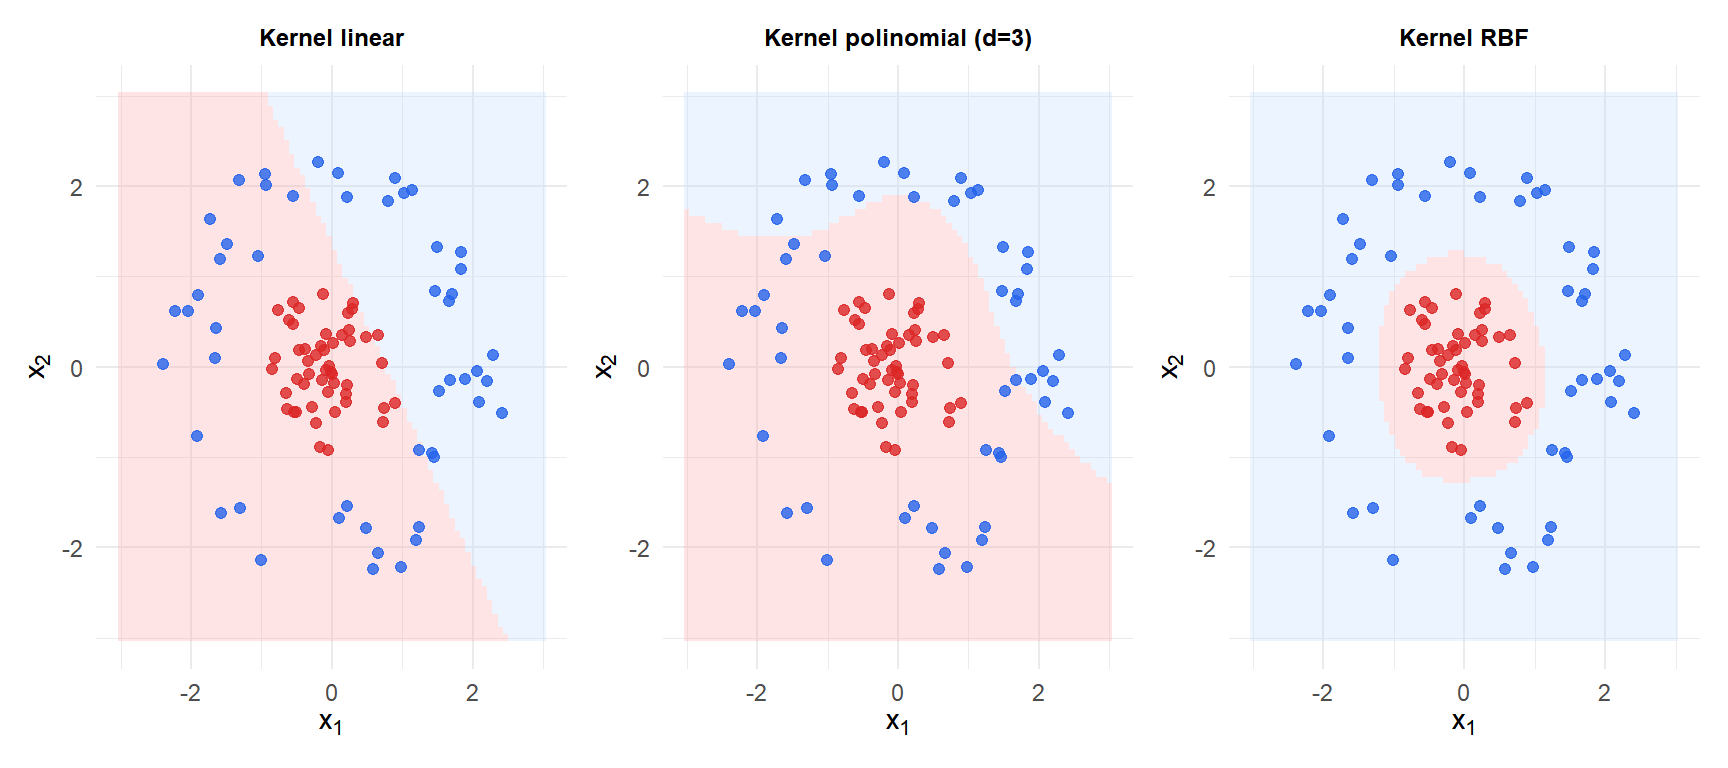
Em dados circulares (não separáveis linearmente), o kernel linear falha completamente. O kernel polinomial captura alguma não linearidade. O kernel RBF aprende corretamente a fronteira circular.
Ajuste de hiperparâmetros
Dois hiperparâmetros-chave para a SVM-RBF: \(C\) e \(\gamma\). Eles interagem: \(\gamma\) grande com \(C\) grande causa overfitting; \(\gamma\) pequeno com \(C\) pequeno causa underfitting. A abordagem padrão é uma busca em grade 2D com validação cruzada:
- Grade de \(C\): \(\{0,01;\, 0,1;\, 1;\, 10;\, 100;\, 1000\}\)
- Grade de \(\gamma\): \(\{0,001;\, 0,01;\, 0,1;\, 1;\, 10\}\)
Um ponto de partida heurístico para \(\gamma\): \(1/(p \cdot \text{Var}(\mathbf{X}))\), em que \(p\) é o número de atributos.
⚠️ A SVM escala mal com n grande
Treinar uma SVM exige resolver um programa quadrático com \(n\) variáveis. Solucionadores QP ingênuos têm complexidade \(O(n^3)\). A Otimização Mínima Sequencial (SMO), o algoritmo padrão no libsvm, reduz isso para aproximadamente \(O(n^2)\), mas ainda pode ser lento para \(n > 100.000\).
Para conjuntos de dados grandes: use uma SVM linear (muito mais rápida, \(O(n)\) com métodos de gradiente estocástico) ou mude para gradient boosting / redes neurais, que escalam melhor. O kernel trick é poderoso, mas também computacionalmente caro no momento da previsão: as previsões exigem avaliar \(K(\mathbf{x}, \mathbf{x}_i)\) para todos os vetores de suporte.
💡 SVM em R
library(e1071)

# Linear SVM
fit_lin <- svm(y ~ ., data=df_train, kernel="linear", cost=1)

# RBF SVM
fit_rbf <- svm(y ~ ., data=df_train, kernel="radial",
               cost=10, gamma=0.1)

# Grid search for C and gamma
tune_result <- tune(svm, y ~ ., data=df_train,
                    kernel="radial",
                    ranges=list(cost=10^(-1:3), gamma=10^(-3:1)))
best_model <- tune_result$best.model
summary(tune_result)

# Predictions and probabilities
predict(fit_rbf, newdata=df_test)
predict(fit_rbf, newdata=df_test, decision.values=TRUE)

# Support vector regression (SVR)
fit_svr <- svm(y ~ ., data=df_train, type="eps-regression",
               kernel="radial", epsilon=0.1)
