Modelo aditivo generalizado (GAM)
Um Modelo Aditivo Generalizado (GAM) substitui cada termo linear \(\beta_j x_j\) de um GLM por uma função suave \(f_j(x_j)\). Cada suavização é estimada a partir dos dados com seleção automática de sua complexidade. O resultado é um modelo tão flexível quanto necessário para cada preditor, permanecendo interpretável: você pode plotar e examinar o efeito de cada variável separadamente.
Formulação
Um GAM mantém a estrutura aditiva, com função de ligação, de um GLM, mas troca o termo linear fixo de cada preditor por uma função suave estimada a partir dos dados:
\[g(E[y]) = \beta_0 + f_1(x_1) + f_2(x_2) + \cdots + f_k(x_k)\]
em que \(g\) é a função de ligação (identidade para gaussiana, logit para binária, log para contagens) e cada \(f_j\) é uma função suave estimada a partir dos dados, tipicamente um spline de regressão penalizado.
A estrutura aditiva significa que o efeito de \(x_j\) em \(g(E[y])\) é capturado por \(f_j\), mantendo todos os outros preditores constantes, assim como na regressão linear. A diferença: \(f_j\) pode ser qualquer curva suave, não apenas uma reta.
Interações não lineares entre dois preditores podem ser incluídas com suavizações de produto tensorial: \(f(x_1, x_2)\), uma superfície suave sobre duas variáveis.
Seleção automática de suavização: REML
Cada suavização \(f_j\) é estimada minimizando um critério penalizado:
\[\text{Deviance penalizada} = -2\ell(\boldsymbol{\beta}) + \sum_j \lambda_j \int [f_j''(x)]^2 dx\]
A penalidade \(\lambda_j\) controla a ondulação de \(f_j\). Muito pequena: sofre overfitting. Muito grande: degenera para uma linha reta. O pacote mgcv seleciona todos os \(\lambda_j\) automaticamente por REML (Máxima Verossimilhança Restrita), que dá uma estimação de variância melhor do que o GCV para a maioria dos casos práticos.
A complexidade de cada suavização é resumida por seus graus de liberdade efetivos (edf):
- edf = 1: a suavização foi penalizada até se tornar uma linha reta.
- edf = 2: aproximadamente quadrática.
- edf próximo de \(k\) (o máximo): muito ondulada, pouca penalização.
Edf grande significa não linearidade forte; edf próximo de 1 significa que o preditor poderia ser incluído de forma linear.
Exemplo: modelagem da qualidade do ar
Modele a concentração diária de ozônio em função da radiação solar, da velocidade do vento e da temperatura. Um modelo linear assume taxas de variação constantes; um GAM permite que cada relação seja não linear.
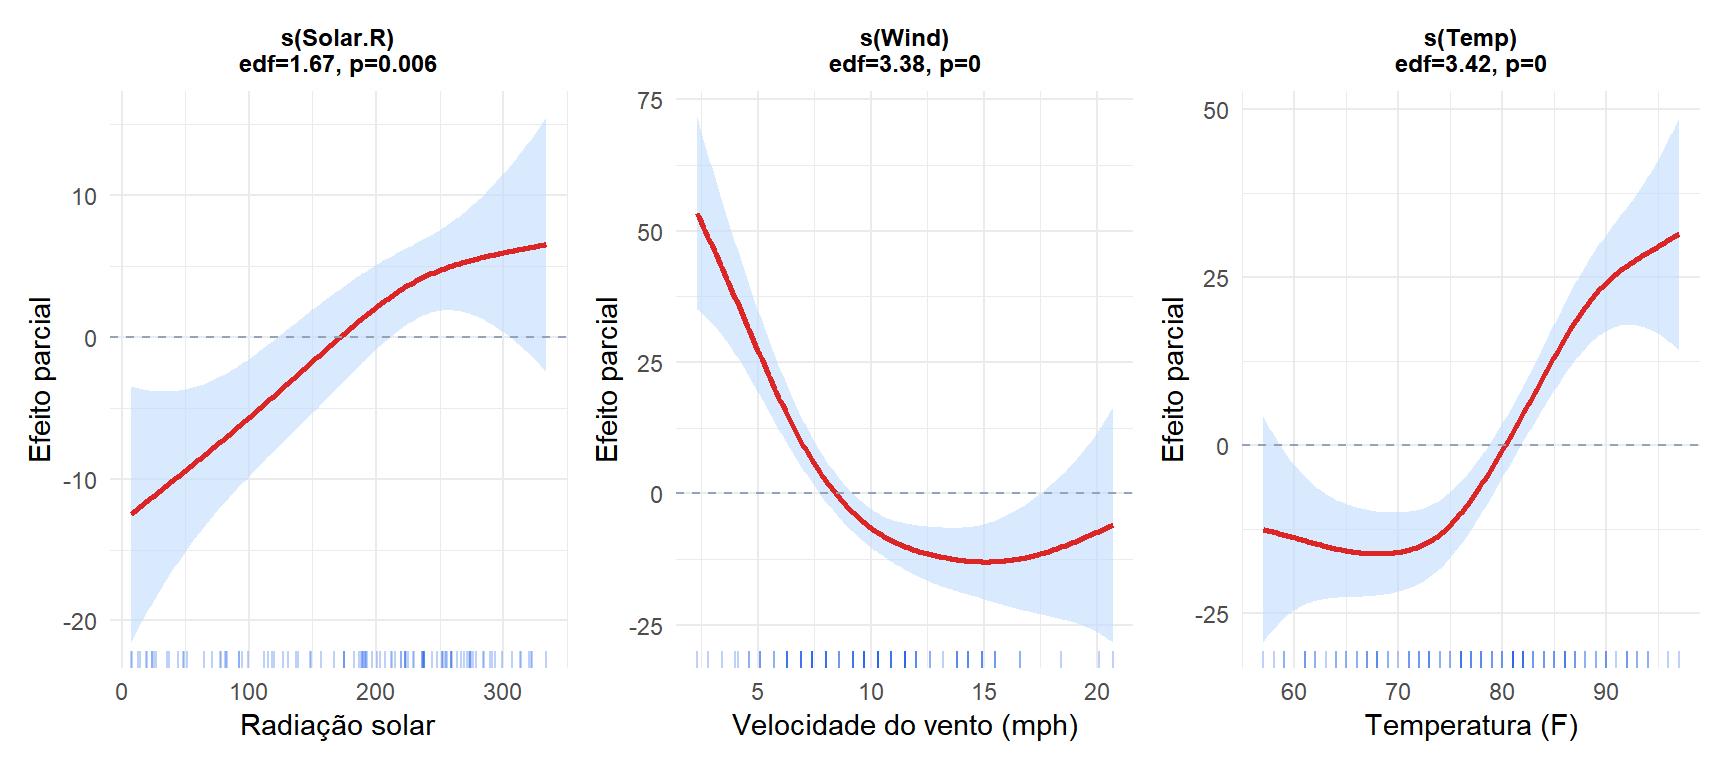
Cada painel mostra o efeito parcial de um preditor: o quanto ele contribui para o ozônio previsto depois de contabilizar os outros dois. A faixa sombreada é o intervalo de confiança pontual de 95%. O “rug” na base mostra a densidade dos dados.
A temperatura tem um efeito positivo fortemente não linear (edf >> 1). O vento tem um efeito negativo monótono, quase linear. A radiação solar tem um efeito positivo moderado com alguma curvatura.
GAM vs modelo linear: quando isso importa?
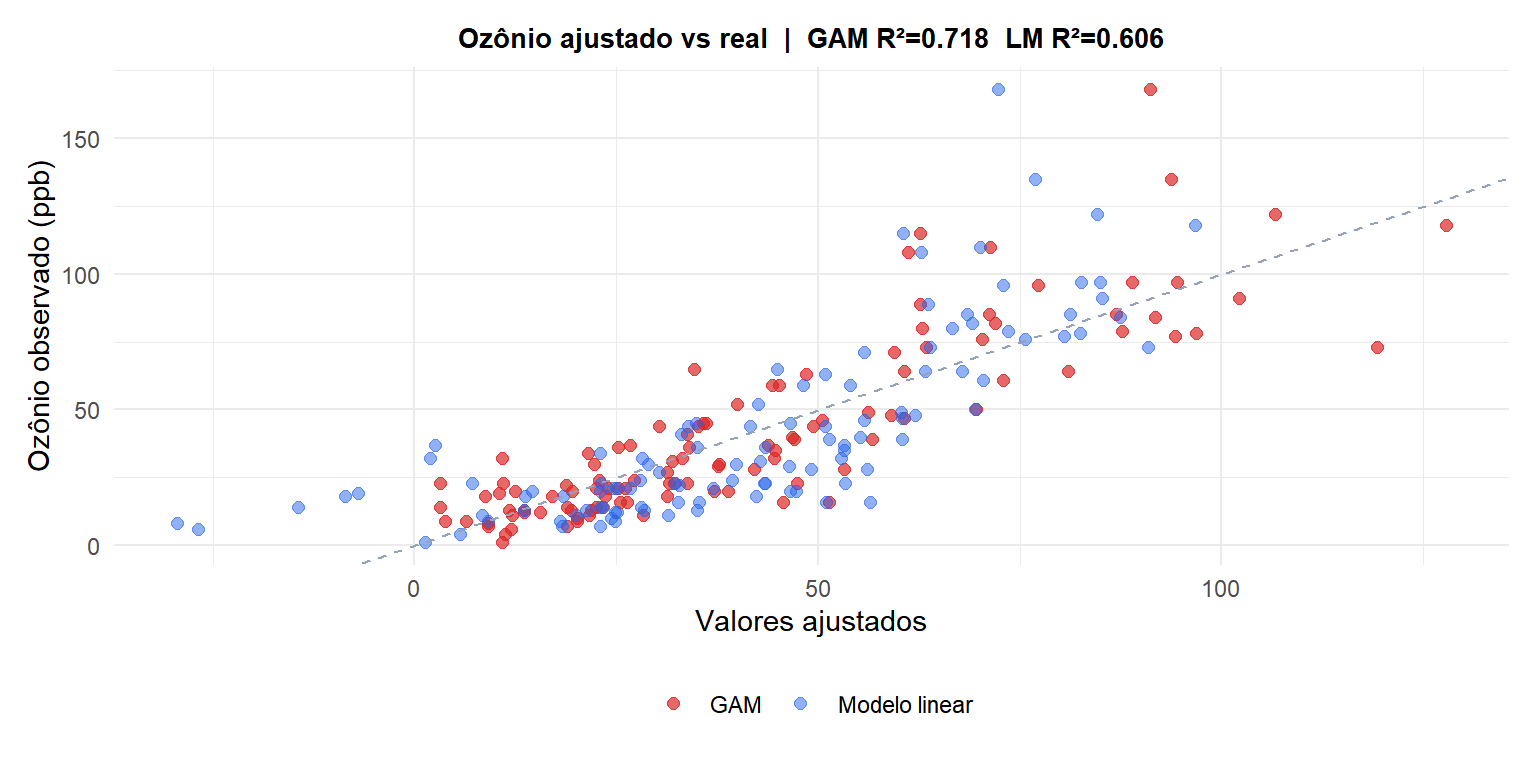
O GAM ajusta os dados substancialmente melhor do que o modelo linear (\(R^2\) maior) porque captura os efeitos não lineares da temperatura e do vento sobre a concentração de ozônio.
Diagnósticos do modelo
Depois de ajustar, verifique:
- Resíduos vs ajustados: não deve mostrar padrão (o mesmo que na regressão linear).
gam.check(): plota quatro painéis diagnósticos e testa se a dimensão da base \(k\) é grande o suficiente para cada suavização. Se o valor-p do teste de índice \(k\) for significativo, aumente \(k\).concurvity(): o equivalente do GAM à multicolinearidade. Mede o quanto uma suavização pode ser aproximada por uma combinação de outras suavizações. Concorvidade alta infla os erros padrão.
⚠️ Termos suaves podem se absorver mutuamente se os preditores forem correlacionados
Se dois preditores são fortemente correlacionados (por exemplo, temperatura e mês), seus termos suaves competem para explicar a mesma variação. Os gráficos de suavização individuais podem parecer planos ou implausíveis, mesmo que o modelo geral se ajuste bem. Verifique concurvity(fit) e considere se ambas as suavizações são cientificamente justificadas ou se uma delas deveria ser descartada ou substituída por uma interação de produto tensorial.
Extensões
Os GAMs se generalizam naturalmente:
- GAMM (GAM com efeitos aleatórios): adiciona efeitos aleatórios para dados agrupados. Ajustado com
gamm()ougamm4. - Respostas não gaussianas: binária (
family=binomial), contagens (family=poisson), dados de sobrevivência. - GAMLSS: modela também a escala e a forma da distribuição da resposta, não apenas sua média, útil quando a dispersão ou a assimetria em si mudam com os preditores.
- Suavizações de produto tensorial:
te(x1, x2)para interações não lineares entre dois preditores contínuos. - Suavizações por fator:
s(x, by=group)ajusta uma suavização separada para cada nível de um fator, permitindo que a forma da relação varie por grupo.
💡 GAMs em R com mgcv
library(mgcv)

# Gaussian GAM (default)
fit <- gam(y ~ s(x1) + s(x2) + x3, data=df, method="REML")
summary(fit)   # edf, p-values for each smooth, R², deviance explained

# Binary outcome
fit_bin <- gam(y ~ s(x1) + s(x2), data=df,
               family=binomial, method="REML")

# Count data
fit_pois <- gam(count ~ s(x), family=poisson, method="REML", data=df)

# Diagnostics
gam.check(fit)       # residual plots + basis dimension test
concurvity(fit)      # correlation between smooths
plot(fit, pages=1)   # all smooth term plots

# Tensor product interaction
fit_te <- gam(y ~ te(x1, x2), data=df, method="REML")
