GAMLSS (Modelos Aditivos Generalizados para Localização, Escala e Forma)
Um GAM permite que a média da resposta dependa suavemente dos preditores, mas ainda assume uma única relação fixa para a dispersão e a forma da distribuição em torno dessa média. O GAMLSS (Generalized Additive Models for Location, Scale and Shape) remove essa suposição: a média, a variância, e até a assimetria e a curtose da resposta podem, cada uma, depender dos preditores, por meio de seu próprio preditor linear ou suave, para quase qualquer família de distribuição.
Modelando cada parâmetro, não apenas a média
Um GLM ou GAM liga um parâmetro (normalmente a média \(\mu\)) aos preditores. O GAMLSS liga até quatro parâmetros da distribuição de uma vez, cada um através de seu próprio preditor linear e função de ligação:
\[g_1(\mu) = X_\mu \boldsymbol{\beta}_\mu, \quad g_2(\sigma) = X_\sigma \boldsymbol{\beta}_\sigma, \quad g_3(\nu) = X_\nu \boldsymbol{\beta}_\nu, \quad g_4(\tau) = X_\tau \boldsymbol{\beta}_\tau\]
em que \(\mu\) é a localização (tipicamente a média ou a mediana), \(\sigma\) é a escala (dispersão), e \(\nu\), \(\tau\) controlam a assimetria e a curtose para famílias de distribuição flexíveis o suficiente para tê-las. Cada matriz de preditores \(X\) pode ser diferente, então as variáveis que determinam a dispersão não precisam ser as mesmas que determinam a média. Qualquer um dos quatro também pode ser apenas uma constante, que é o que um GLM simples faz para \(\sigma\), \(\nu\) e \(\tau\).
Isso importa sempre que a dispersão ou a forma da resposta mudam sistematicamente com um preditor, um padrão que uma regressão comum força a se encaixar em uma única variância residual fixa, errando silenciosamente.
Exemplo resolvido: dados de custo com variabilidade crescente
Um conjunto de dados simulado de \(n=150\) valores de sinistro com distribuição Gamma, em que tanto a média quanto a dispersão relativa aumentam com um preditor \(x\) (pense no tamanho do sinistro crescendo, e se tornando proporcionalmente menos previsível, com o valor da apólice). Dois modelos são ajustados: um modelo Gamma com um único \(\sigma\) constante, e um modelo GAMLSS em que \(\sigma\) também pode depender de \(x\).
Coeficientes ajustados (ligação logarítmica em \(\mu\) e em \(\sigma\)):
| Parâmetro | Intercepto | Inclinação em \(x\) |
|---|---|---|
| \(\mu\) (média) | 3,505 | 0,178 |
| \(\sigma\) (escala) | -1,594 | 0,122 (\(p < 0{,}001\)) |
A inclinação em \(\sigma\) é claramente diferente de zero: um teste de razão de verossimilhança comparando o modelo de \(\sigma\) constante contra este dá \(LRT = 24{,}07\) com 1 grau de liberdade, \(p < 0{,}001\). O modelo de \(\sigma\) constante estima uma única dispersão de \(\sigma \approx 0{,}450\) para qualquer valor de \(x\); o modelo GAMLSS mostra que \(\sigma\) na verdade varia de cerca de \(0{,}26\) em \(x=2\) a \(0{,}61\) em \(x=9\), mais do que dobrando.
O ajuste confirma que vale a pena a complexidade extra: \(\text{AIC} = 1529{,}6\) para o modelo de \(\sigma\) constante contra \(\text{AIC} = 1507{,}5\) para o GAMLSS, uma melhora clara ao permitir que \(\sigma\) varie.
Traduzir o \(\mu\) e o \(\sigma\) ajustados em quantis em dois valores de \(x\) mostra o que isso significa na prática:
| \(x\) | Mediana | Percentil 10 | Percentil 90 | Percentil 90 \(-\) 10 |
|---|---|---|---|---|
| 2 | 46,5 | 32,6 | 63,8 | 31,3 |
| 9 | 145,4 | 56,1 | 301,0 | 244,8 |
A mediana sobe cerca de 3,1 vezes de \(x=2\) para \(x=9\), mas a dispersão entre o percentil 10 e o 90 sobe cerca de 7,8 vezes no mesmo intervalo. Um modelo que só permite que a média se mova preveria corretamente o centro em \(x=9\), mas subestimaria drasticamente o quão amplo é, na realidade, o intervalo plausível de resultados.

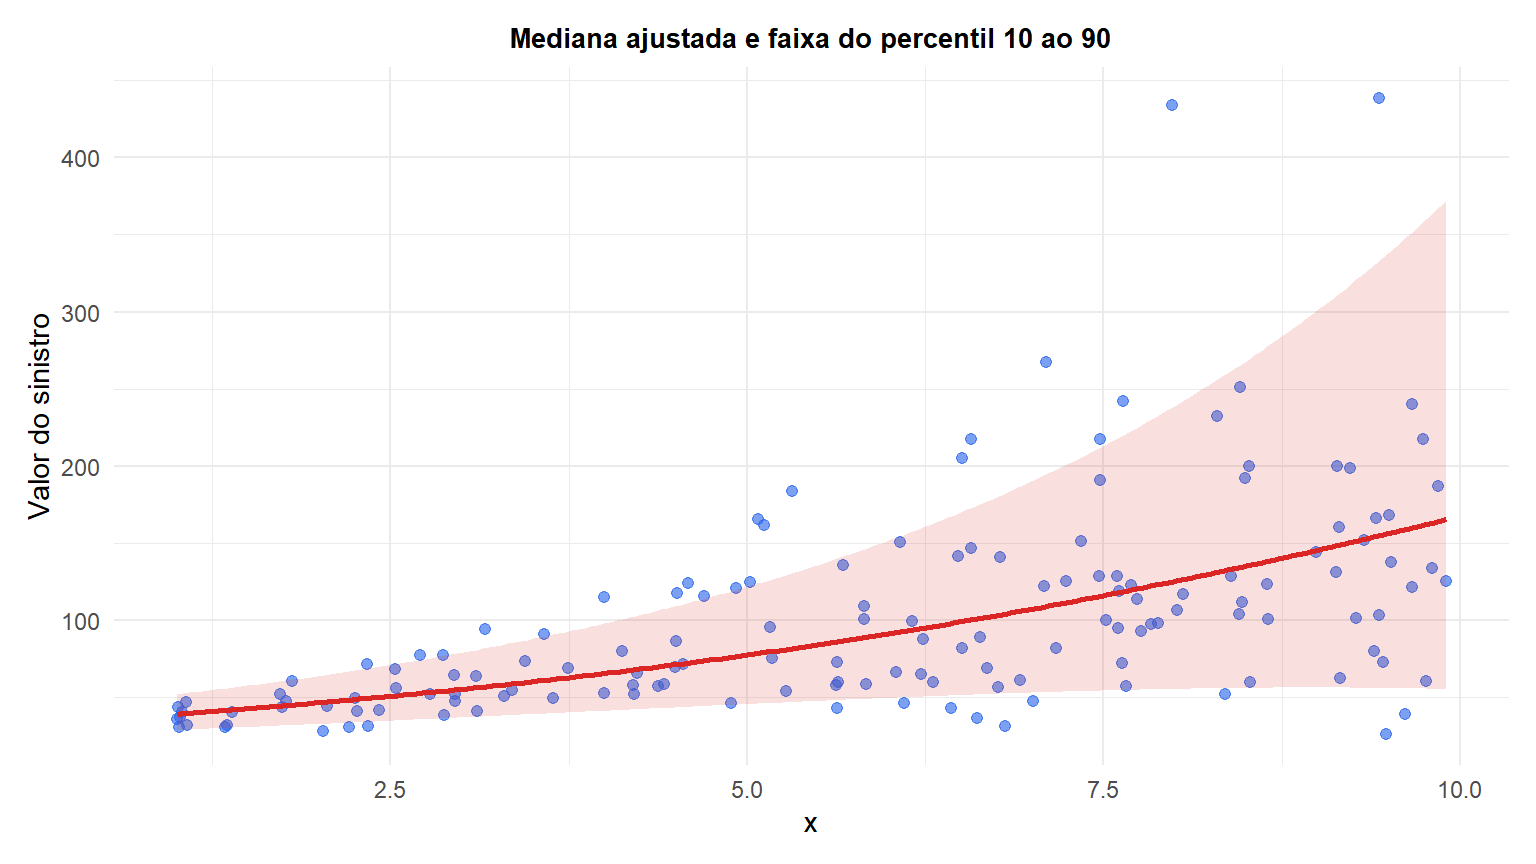
A faixa sombreada não é um intervalo de confiança em torno da média, é o intervalo ajustado do percentil 10 ao 90 da própria resposta, e ela se amplia visivelmente conforme \(x\) aumenta, exatamente o padrão que um modelo de \(\sigma\) constante não consegue representar.
GAMLSS vs regressão quantílica
Ambas as abordagens tratam de uma resposta cuja dispersão muda com os preditores, veja regressão quantílica, mas funcionam de forma diferente. A regressão quantílica ajusta cada quantil solicitado separadamente, sem assumir nenhuma distribuição, o que a torna robusta a errar a família de distribuição, mas só fornece os quantis específicos que você escolheu ajustar, sem garantia de que sejam mutuamente consistentes (uma reta ajustada do percentil 10 pode, em princípio, cruzar uma reta ajustada do percentil 50). O GAMLSS ajusta uma distribuição coerente por observação, então qualquer quantil pode ser obtido posteriormente, como no gráfico acima, e os quantis são garantidamente consistentes por construção, mas o resultado é tão bom quanto a família de distribuição escolhida.
⚠️ A família de distribuição é uma escolha real de modelagem
Diferentemente da regressão quantílica, o GAMLSS se compromete com uma família paramétrica (Gamma, log-normal, uma skew-t, e dezenas de outras estão disponíveis). Se a família escolhida se ajustar mal aos dados, os quantis ajustados podem estar sistematicamente errados mesmo que o modelo convirja sem erros. Sempre verifique os diagnósticos de resíduos; o próprio worm plot do GAMLSS (wp()) é a ferramenta padrão, antes de confiar em previsões das caudas da distribuição ajustada.
Executando em R
O pacote gamlss ajusta o modelo e permite compará-lo com uma versão de escala constante por meio de um teste de razão de verossimilhança:
library(gamlss)

# Constant sigma: equivalent to an ordinary Gamma GLM
fit_const <- gamlss(y ~ x, sigma.formula = ~1, family = GA, data = df)

# GAMLSS: sigma also depends on x
fit_gamlss <- gamlss(y ~ x, sigma.formula = ~x, family = GA, data = df)

GAIC(fit_const, fit_gamlss)     # lower AIC wins
LR.test(fit_const, fit_gamlss)  # formal test of the extra sigma term

# Diagnostics
wp(fit_gamlss)                 # worm plot, checks distribution adequacy
plot(fit_gamlss)               # residual summary

# Coefficients on each parameter, and predicted quantiles
coef(fit_gamlss, what = "mu")
coef(fit_gamlss, what = "sigma")
centiles(fit_gamlss, xvar = df$x)
💡 De onde veio o GAMLSS
O GAMLSS foi introduzido por Rigby e Stasinopoulos em 2005, estendendo trabalhos anteriores sobre o método LMS usado para construir as curvas de referência de crescimento infantil, em que o peso ou a altura de uma criança não é julgado contra uma única curva média, mas contra curvas da mediana, da dispersão e da assimetria que mudam todas com a idade. Essa mesma ideia, modelar toda a forma da distribuição conforme ela muda com um preditor, em vez de apenas seu centro, é o que torna o GAMLSS útil muito além das curvas de crescimento: sinistros de seguros, dados de renda, e qualquer resposta em que “o quanto se dispersa” ou “o quanto é assimétrica” seja, em si, parte da história.

