Regressão linear simples
A regressão linear simples modela a relação linear entre uma variável resposta \(y\) e um único preditor \(x\) ajustando uma reta aos dados. É a base da análise de regressão: toda regressão múltipla, regressão logística e modelo regularizado se constrói sobre esses conceitos.
O modelo
O modelo assume que cada observação é gerada por uma reta mais um erro aleatório:
\[y_i = \beta_0 + \beta_1 x_i + \varepsilon_i, \qquad \varepsilon_i \sim N(0, \sigma^2)\]
- \(\beta_0\): intercepto. O valor esperado de \(y\) quando \(x = 0\).
- \(\beta_1\): inclinação. A mudança esperada em \(y\) para um aumento de uma unidade em \(x\).
- \(\varepsilon_i\): termo de erro. Captura tudo o que afeta \(y\) além de \(x\): erro de medição, variáveis omitidas, aleatoriedade inerente.
O modelo estabelece quatro suposições (LINE, do inglês): Linearidade, Independência dos erros, Normalidade dos erros, Equal variância (homocedasticidade). Elas são testadas no post de diagnósticos.
Estimação por MQO
Os Mínimos Quadrados Ordinários (MQO) encontram \(\hat{\beta}_0\) e \(\hat{\beta}_1\) que minimizam a soma dos quadrados dos resíduos:
\[\text{SQR} = \sum_{i=1}^n (y_i - \hat{\beta}_0 - \hat{\beta}_1 x_i)^2\]
Derivando e igualando a zero, obtêm-se os estimadores em forma fechada:
\[\hat{\beta}_1 = \frac{\sum_{i=1}^n (x_i - \bar{x})(y_i - \bar{y})}{\sum_{i=1}^n (x_i - \bar{x})^2} = r_{xy} \cdot \frac{S_y}{S_x}\]
\[\hat{\beta}_0 = \bar{y} - \hat{\beta}_1 \bar{x}\]
em que \(r_{xy}\) é a correlação de Pearson, \(S_y\) e \(S_x\) são os desvios padrão amostrais. A reta de regressão sempre passa pelo ponto das médias \((\bar{x}, \bar{y})\).
A conexão com a correlação: \(\hat{\beta}_1 = 0\) se e somente se \(r_{xy} = 0\). Testar \(H_0: \beta_1 = 0\) equivale a testar \(H_0: \rho = 0\).
Exemplo: gasto em publicidade e vendas
Uma empresa registra o gasto semanal em publicidade na TV (milhares de €) e as vendas semanais (milhares de unidades) durante 50 semanas.
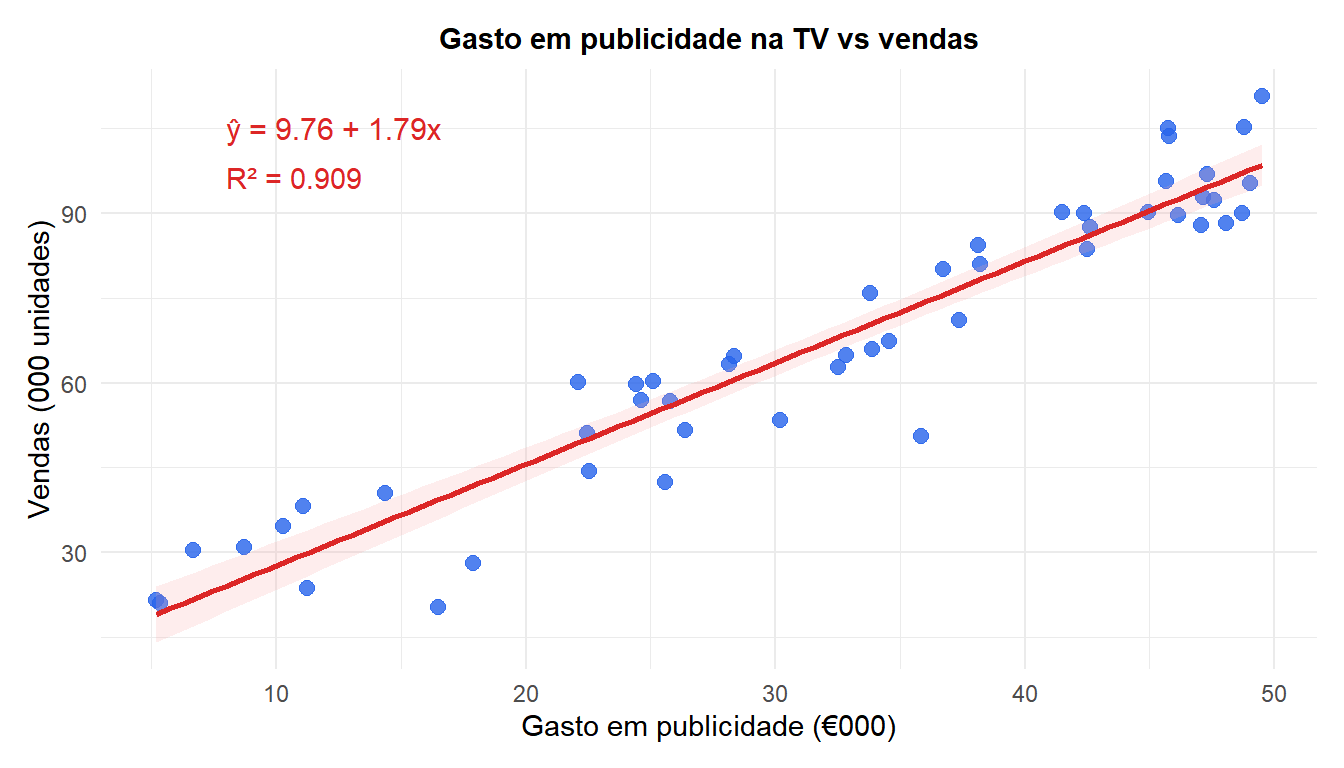
Cada €1.000 adicionais de publicidade na TV estão associados a aproximadamente 1.79 mil unidades extras vendidas. O intercepto (9.76) representa as vendas básicas com publicidade zero. $R^2 = $ 0.909 significa que 90.9% da variação nas vendas é explicada pelo gasto em publicidade.
Qualidade do ajuste: R²
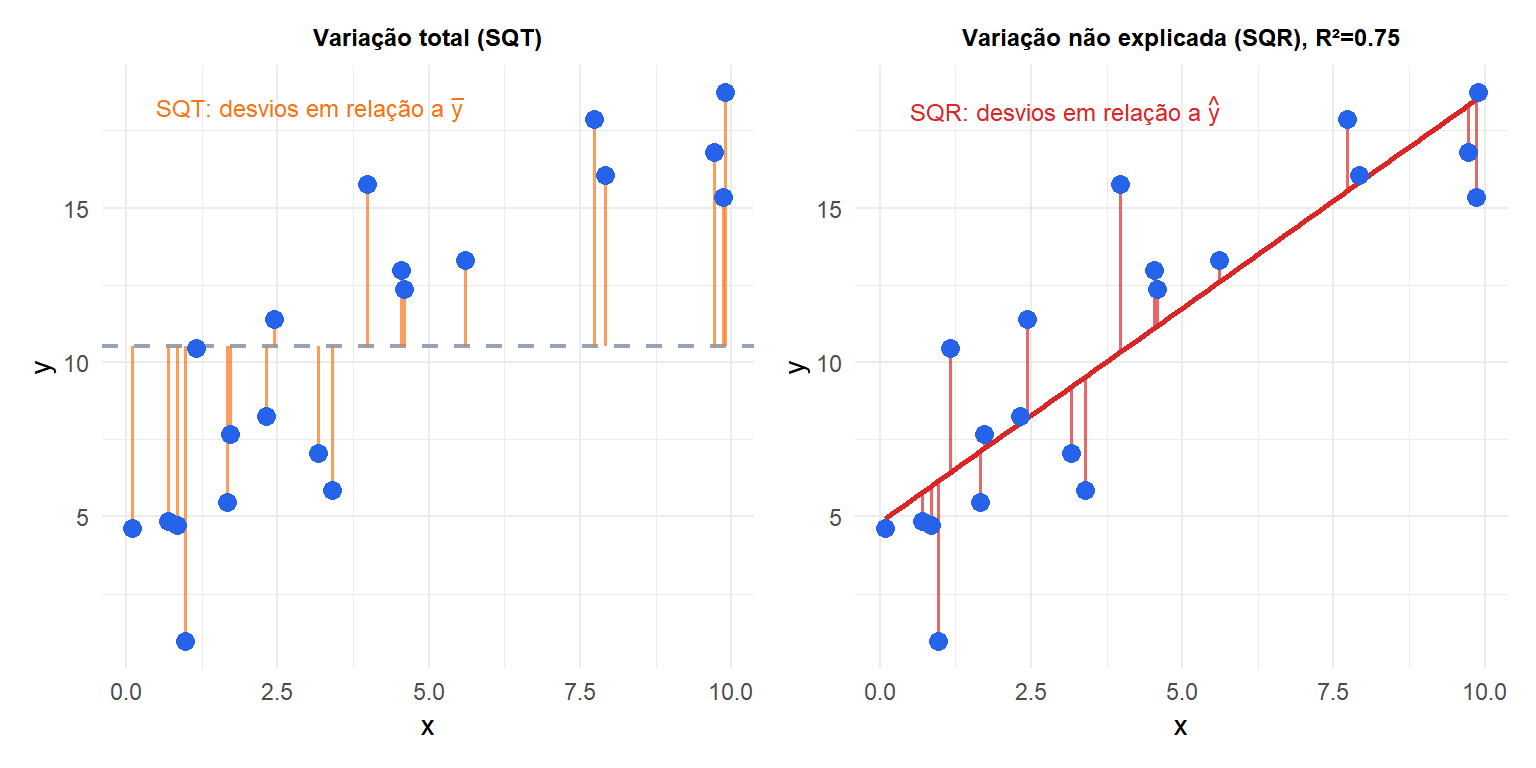
O \(R^2\) mede a proporção da variância em \(y\) explicada pelo modelo:
\[R^2 = 1 - \frac{\text{SQR}}{\text{SQT}} = 1 - \frac{\sum(y_i - \hat{y}_i)^2}{\sum(y_i - \bar{y})^2}\]
\(R^2 \in [0,1]\). Um \(R^2\) de 0,70 significa que 70% da variância em \(y\) é explicada por \(x\); os 30% restantes são ruído não explicado. Na regressão linear simples, \(R^2 = r_{xy}^2\).
Inferência sobre a inclinação
Sob as suposições do modelo, \(\hat{\beta}_1\) é normalmente distribuído:
\[\hat{\beta}_1 \sim N\!\left(\beta_1,\; \frac{\sigma^2}{\sum(x_i-\bar{x})^2}\right)\]
Como \(\sigma^2\) é desconhecida, estima-se com \(\hat{\sigma}^2 = \text{SQR}/(n-2)\) e usa-se a distribuição \(t\):
\[t = \frac{\hat{\beta}_1 - 0}{\widehat{\text{EP}}(\hat{\beta}_1)} \sim t(n-2) \quad \text{sob } H_0: \beta_1 = 0\]
Um intervalo de confiança de \((1-\alpha)\) para \(\beta_1\):
\[\hat{\beta}_1 \pm t_{\alpha/2, n-2} \cdot \widehat{\text{EP}}(\hat{\beta}_1)\]
Um teste \(t\) significativo (\(p < 0{,}05\)) significa que \(x\) é um preditor estatisticamente significativo de \(y\): é improvável que a inclinação observada surja por acaso se \(\beta_1 = 0\).
⚠️ Significância estatística não implica importância prática
Uma amostra muito grande pode produzir uma inclinação estatisticamente significativa, mas praticamente desprezível. Um aumento de \(\hat{\beta}_1 = 0{,}001\) unidades por cada €1.000 de publicidade pode ser significativo com \(p < 0{,}001\) para \(n = 10.000\) observações, mas é comercialmente irrelevante.
Sempre reporte o tamanho do efeito (a própria inclinação e seu intervalo de confiança) junto com o valor-p. O intervalo de confiança transmite tanto a direção quanto a magnitude plausível do efeito.
Previsão
Para uma nova observação em \(x_\text{novo}\), o modelo produz dois tipos de intervalos:
Intervalo de confiança para a resposta média: incerteza sobre o \(y\) médio em \(x_\text{novo}\) na população.
Intervalo de predição para uma nova observação: mais amplo, porque adiciona o erro individual \(\varepsilon\) à incerteza sobre a média.
\[\hat{y}_\text{novo} \pm t_{\alpha/2, n-2} \cdot \hat{\sigma}\sqrt{1 + \frac{1}{n} + \frac{(x_\text{novo}-\bar{x})^2}{\sum(x_i-\bar{x})^2}}\]
Ambos os intervalos se alargam conforme \(x_\text{novo}\) se afasta de \(\bar{x}\): a extrapolação se torna cada vez menos confiável.
💡 Regressão linear simples em R
fit <- lm(sales ~ spend, data = df)
summary(fit)         # coefficients, t-tests, R²
confint(fit)         # 95% CIs for beta0 and beta1
predict(fit, newdata = data.frame(spend = 30),
        interval = "confidence")   # CI for mean response
predict(fit, newdata = data.frame(spend = 30),
        interval = "prediction")   # PI for new observation
