Regressão não linear
A regressão não linear ajusta modelos em que pelo menos um parâmetro aparece de forma não linear na função de previsão. Diferentemente da regressão polinomial (que é linear em seus parâmetros e resolvida por MQO), modelos não lineares exigem algoritmos iterativos. O ganho é a capacidade de ajustar formas funcionais com significado científico: curvas de crescimento, relações dose-resposta, cinética enzimática.
Linear nos parâmetros vs linear nas variáveis
A distinção crítica não é se a curva é reta, mas se o modelo é linear nos parâmetros:
- \(y = \beta_0 + \beta_1 x + \beta_2 x^2\): polinomial, mas linear em \(\beta\). O MQO se aplica diretamente.
- \(y = \beta_0 e^{\beta_1 x}\): exponencial, não linear em \(\beta_1\). O MQO não se aplica; são necessários métodos iterativos.
- \(y = \beta_0 + \beta_1 \log x\): preditor log-transformado, mas linear em \(\beta\). O MQO se aplica.
Um modelo é linear se o gradiente \(\partial f / \partial \beta_j\) não depende de nenhum \(\beta\). Se depender, o modelo é não linear e exige nls() ou similar.
O modelo não linear geral:
\[y_i = f(x_i, \boldsymbol{\beta}) + \varepsilon_i, \qquad \varepsilon_i \sim N(0, \sigma^2)\]
em que \(f\) é qualquer função suave, não necessariamente linear em \(\boldsymbol{\beta}\). Os parâmetros \(\hat{\boldsymbol{\beta}}\) minimizam a soma dos quadrados dos resíduos \(\sum_i (y_i - f(x_i, \boldsymbol{\beta}))^2\), mas não existe solução em forma fechada.
Algoritmos de ajuste
Algoritmo de Gauss-Newton
Lineariza \(f\) em torno da estimativa atual \(\boldsymbol{\beta}^{(t)}\) usando uma expansão de Taylor de primeira ordem:
\[f(x_i, \boldsymbol{\beta}) \approx f(x_i, \boldsymbol{\beta}^{(t)}) + \mathbf{J}_i^T (\boldsymbol{\beta} - \boldsymbol{\beta}^{(t)})\]
em que \(\mathbf{J}_i = \partial f / \partial \boldsymbol{\beta}|_{\boldsymbol{\beta}^{(t)}}\) é o jacobiano. A atualização é:
\[\boldsymbol{\beta}^{(t+1)} = \boldsymbol{\beta}^{(t)} + (\mathbf{J}^T\mathbf{J})^{-1}\mathbf{J}^T \mathbf{r}^{(t)}\]
em que \(\mathbf{r}^{(t)} = \mathbf{y} - f(\mathbf{x}, \boldsymbol{\beta}^{(t)})\) é o vetor de resíduos. Converge quadraticamente perto da solução, mas pode divergir se os valores iniciais estiverem longe do ótimo.
Algoritmo de Levenberg-Marquardt
Uma extensão robusta de Gauss-Newton que interpola entre Gauss-Newton (\(\lambda=0\)) e o gradiente descendente (\(\lambda\) grande):
\[\boldsymbol{\beta}^{(t+1)} = \boldsymbol{\beta}^{(t)} + (\mathbf{J}^T\mathbf{J} + \lambda \mathbf{I})^{-1}\mathbf{J}^T \mathbf{r}^{(t)}\]
O parâmetro de amortecimento \(\lambda\) é ajustado automaticamente: aumenta quando um passo falha (tornando-se mais parecido com o gradiente descendente, estável mas lento) e diminui quando um passo tem sucesso (mais parecido com Gauss-Newton, rápido perto da solução). Isso o torna muito mais robusto a valores iniciais ruins. É o algoritmo padrão em nls().
Modelos não lineares comuns
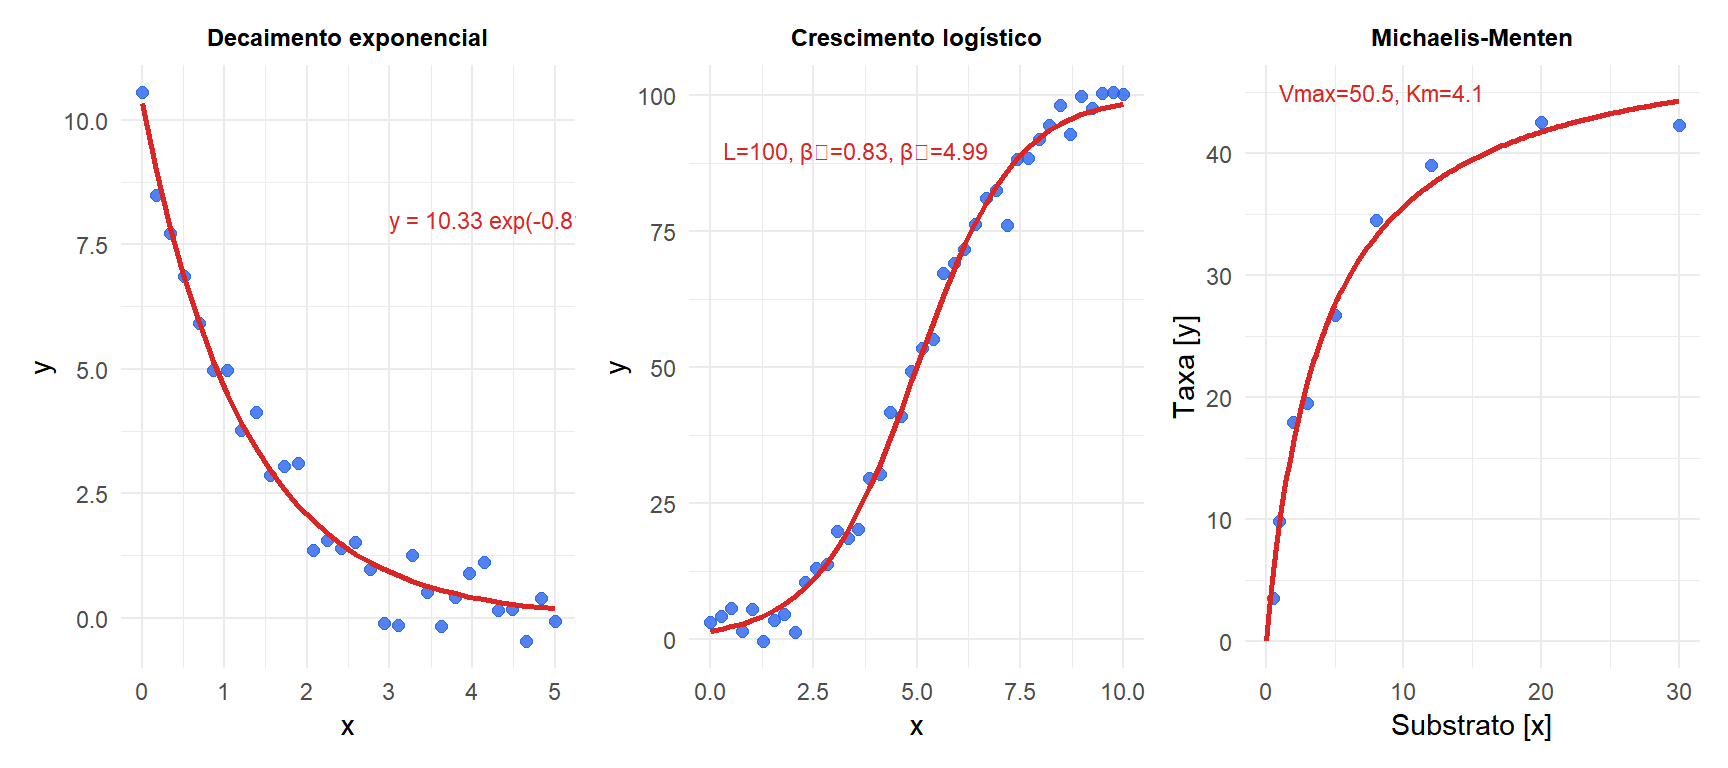
1. Modelo exponencial
\[y = \beta_0 e^{\beta_1 x}\]
\(\beta_0 > 0\): valor inicial (\(y\) quando \(x=0\)). \(\beta_1 > 0\): crescimento exponencial; \(\beta_1 < 0\): decaimento exponencial. Aplicações: decaimento radioativo, crescimento populacional, juros compostos.
Linearização: \(\log y = \log \beta_0 + \beta_1 x\) é linear, então o MQO sobre a resposta log-transformada é frequentemente usado como uma aproximação rápida. No entanto, isso minimiza os resíduos na escala logarítmica, não os resíduos na escala original, e dá estimativas diferentes (viesadas) quando \(\varepsilon\) é aditivo na escala original.
2. Modelo de crescimento logístico
\[y = \frac{L}{1 + e^{-\beta_1(x - \beta_2)}}\]
\(L\): capacidade de suporte (assíntota superior). \(\beta_1\): taxa de crescimento. \(\beta_2\): ponto de inflexão (\(x\) no qual \(y = L/2\)). Curva em forma de S. Aplicações: crescimento populacional, adoção de tecnologia, propagação de epidemias, dose-resposta.
3. Modelo de Michaelis-Menten
\[y = \frac{V_\text{max} \cdot x}{K_m + x}\]
\(V_\text{max}\): taxa máxima (assíntota superior quando \(x \to \infty\)). \(K_m\): constante de meia-saturação (\(x\) no qual \(y = V_\text{max}/2\)). Aplicações: cinética enzimática, absorção de nutrientes, farmacocinética.
Escolhendo valores iniciais
A regressão não linear pode falhar ou convergir para um mínimo local se os valores iniciais dos parâmetros estiverem longe da solução verdadeira. Estratégias para escolher boas valores iniciais:
- Use conhecimento do domínio: para o modelo logístico, \(L\) é a assíntota superior observável; \(\beta_2\) fica aproximadamente onde a curva é mais inclinada.
- Lineariza e use o MQO: faça a transformação logarítmica do modelo exponencial e use a inclinação e o intercepto do MQO como valores iniciais.
- Busca em grade: avalie a função objetivo em uma grade de valores iniciais e use o melhor como ponto de partida.
- Use modelos de autoinicialização: o R fornece
SSlogis,SSasymp,SSmicmenetc., que estimam seus próprios valores iniciais automaticamente.
⚠️ Falha de convergência geralmente significa valores iniciais ruins ou modelo errado
Quando nls() lança “singular gradient” ou “step factor reduced below minimum”, as causas usuais são:
- Valores iniciais longe do ótimo.
- O modelo não é identificável a partir dos dados (parâmetros confundidos).
- A forma funcional está errada para os dados.
Sempre plote os dados primeiro e sobreponha o modelo com seus valores iniciais antes de ajustar. Se a curva inicial parecer razoável, o algoritmo tem boa chance de convergir. Se parecer completamente errada, nenhum algoritmo conseguirá recuperar.
💡 Regressão não linear em R
# Manual starting values
fit <- nls(y ~ b0 * exp(b1 * x), data=df,
           start=list(b0=10, b1=-0.5))
summary(fit)
confint(fit)

# Self-starting models (no starting values needed)
fit_logis <- nls(y ~ SSlogis(x, Asym, xmid, scal), data=df)
fit_mm    <- nls(y ~ SSmicmen(x, Vm, K), data=df)
fit_exp   <- nls(y ~ SSasymp(x, Asym, R0, lrc), data=df)

# Predictions and residual plot
plot(fitted(fit), residuals(fit))
abline(h=0, lty=2)

# More robust fitting with minpack.lm (Levenberg-Marquardt)
library(minpack.lm)
fit_lm <- nlsLM(y ~ b0*exp(b1*x), data=df,
                start=list(b0=10, b1=-0.5))
