Regressão polinomial
A regressão polinomial ajusta uma relação curva entre um preditor e uma resposta adicionando potências de \(x\), \(x^2\), \(x^3\) e assim por diante, como preditores extras no modelo. A curva ajustada se dobra, mas o modelo por trás dela ainda é estimado por mínimos quadrados ordinários. Este post mostra por que isso acontece, como identificar problemas de overfitting e extrapolação, e como as potências de \(x\) criam sua própria versão de multicolinearidade.
Ainda é um modelo linear
O modelo de regressão polinomial de grau \(d\):
\[y_i = \beta_0 + \beta_1 x_i + \beta_2 x_i^2 + \dots + \beta_d x_i^d + \varepsilon_i\]
O ponto crítico, abordado em mais profundidade em regressão não linear, é que um modelo é linear ou não linear de acordo com o fato de ser linear nos parâmetros \(\beta_j\), e não com o fato de a curva ajustada ser uma linha reta. Aqui, \(x^2\) e \(x^3\) são apenas colunas adicionais de preditores: o modelo continua sendo \(y = \mathbf{X}\boldsymbol{\beta} + \varepsilon\) com uma \(\mathbf{X}\) maior, então os mínimos quadrados ordinários se aplicam diretamente e existe uma solução em forma fechada, diferentemente de modelos genuinamente não lineares como \(y = \beta_0 e^{\beta_1 x}\), que exigem um algoritmo iterativo.
Exemplo resolvido: fertilizante e produtividade agrícola
Ajustar uma linha reta, uma quadrática e um grau desnecessariamente alto aos mesmos dados curvos mostra exatamente onde cada um falha.
Um conjunto de dados simulado de \(n=45\) parcelas registra o fertilizante aplicado (kg/ha, de 0 a cerca de 20) e a produtividade agrícola resultante. A relação real sobe com o fertilizante até certo ponto, depois cai conforme o excesso de fertilizante começa a prejudicar a cultura, um padrão agronômico real e bem conhecido que uma linha reta não consegue capturar.
Ajustando três modelos aos mesmos dados:
| Grau | R quadrado | R quadrado ajustado |
|---|---|---|
| 1 (linha reta) | 0,166 | 0,147 |
| 2 (quadrático) | 0,833 | 0,825 |
| 9 | 0,859 | 0,823 |
O salto do grau 1 para o grau 2 é real e grande: um teste F comparando os dois modelos encaixados dá \(F(1,42) = 168{,}24\), \(p < 0{,}001\), o grau 2 ajusta dramaticamente melhor. Mas ir do grau 2 para o grau 9 praticamente não altera o R quadrado (0,833 para 0,859), enquanto o R quadrado ajustado, que penaliza preditores extras, na verdade cai um pouco (0,825 para 0,823): os sete termos adicionais não trazem nenhum poder explicativo real, apenas ajustam o ruído.
O próprio ajuste quadrático: \(\widehat{\text{produtividade}} = 16{,}53 + 9{,}84 \cdot \text{fertilizante} - 0{,}42 \cdot \text{fertilizante}^2\), uma curva que sobe e depois desce, exatamente a forma que o processo real tem.

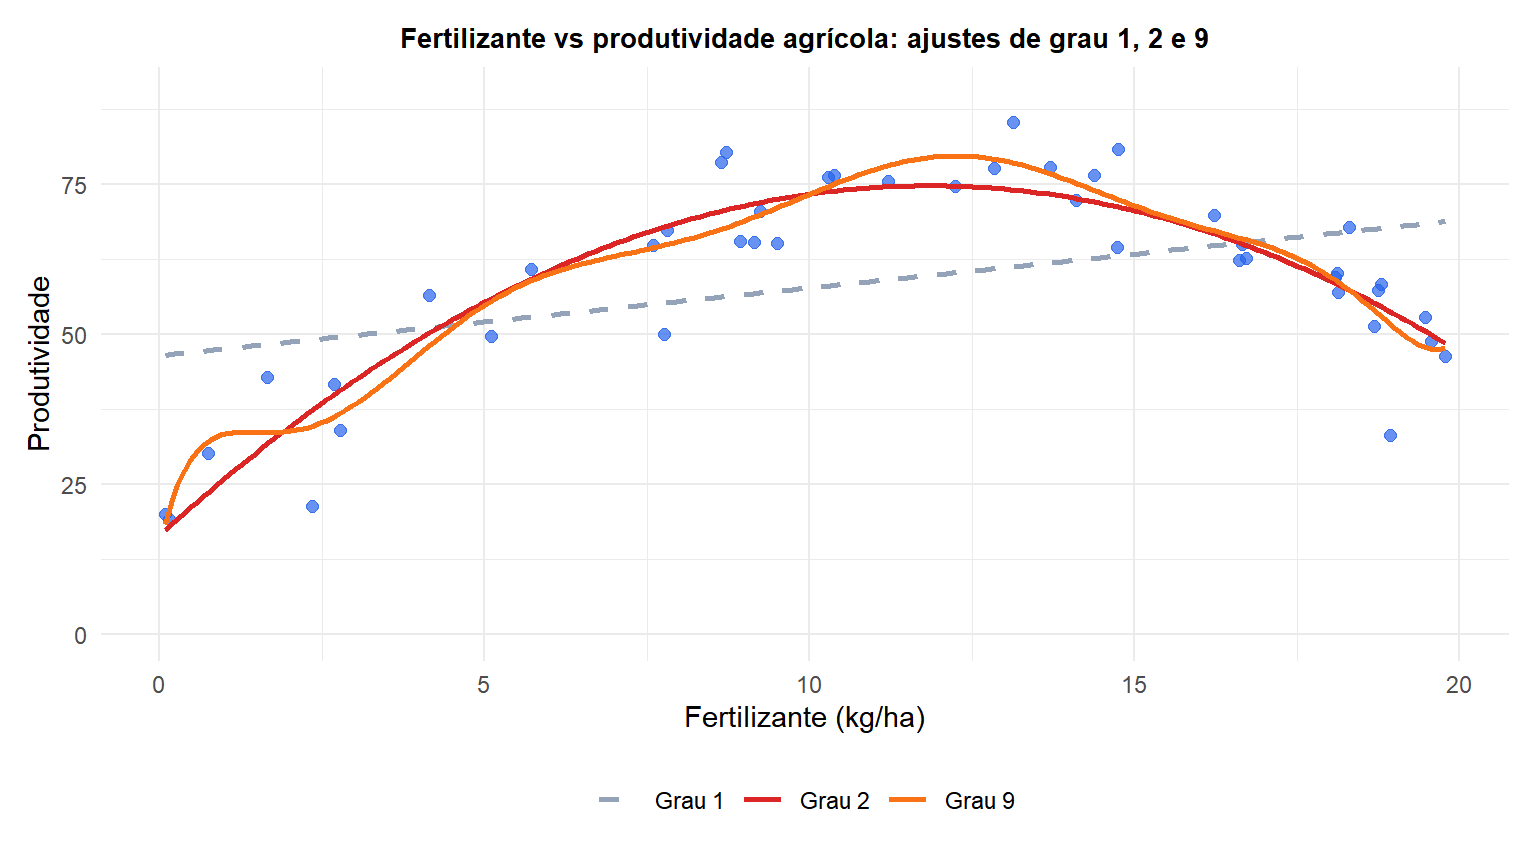
A reta de grau 1 (cinza, tracejada) não consegue se curvar, então sofre underfitting: ela não capta nem a subida inicial nem a queda final. A curva de grau 2 (vermelha) acompanha de perto a verdadeira forma de subida e depois queda. A curva de grau 9 (laranja) oscila entre os pontos de dados, perseguindo o ruído em vez do padrão subjacente, o que é especialmente visível perto das bordas dos dados.
Dois perigos reais: overfitting e extrapolação
O ajuste de grau 9 acima já sugeria os dois problemas, perseguindo o ruído dentro do intervalo de dados e disparando logo fora dele.
⚠️ Um grau alto causa overfitting e extrapola pior do que uma linha reta
Overfitting. Um grau muito alto ajusta o ruído da amostra, não a relação real, e seu R quadrado ajustado pode até cair enquanto o R quadrado bruto continua subindo, exatamente o que aconteceu acima ao passar do grau 2 para o grau 9. Verificar o erro de um modelo em dados aos quais ele não foi ajustado, veja validação cruzada, detecta isso de forma muito mais confiável do que observar apenas o R quadrado dentro da amostra.
Extrapolação. Os valores de fertilizante observados vão de cerca de 0,1 a 19,8. Prevendo apenas três unidades além do topo desse intervalo (fertilizante = 22,8), em que a curva real ainda é um modesto 27,8:
| Modelo | Previsão em fertilizante = 22,8 |
|---|---|
| Grau 1 | 72,1 |
| Grau 2 | 24,9 |
| Grau 9 | 820,4 |
O modelo de grau 2, que corresponde à forma real, fica próximo do valor verdadeiro. A reta de grau 1, nunca tendo visto a queda, dispara muito além. O modelo de grau 9 explode para um valor absurdamente implausível de 820,4: polinômios de grau alto se curvam abruptamente logo nas bordas dos dados de treinamento, e essa curvatura dispara para valores extremos quase imediatamente fora dela, um modo de falha muito mais perigoso do que qualquer linha reta produziria.
Termos polinomiais criam sua própria multicolinearidade
\(x\) e \(x^2\) são construídos a partir da mesma variável, então são altamente correlacionados por construção: aqui, \(\text{cor}(\text{fertilizante}, \text{fertilizante}^2) = 0{,}968\). Ajustar fert + I(fert^2) diretamente dá a ambos os termos um VIF de 15,8, bem acima do limiar de alerta comum de 5 a 10.
Isso não prejudica a curva ajustada ou suas previsões, exatamente como qualquer outra multicolinearidade, mas torna os coeficientes linear e quadrático individuais mais difíceis de interpretar e menos estáveis. Centralizar \(x\) primeiro (subtraindo sua média antes de elevar ao quadrado) reduz substancialmente a correlação; usar polinômios ortogonais, o que a função poly() do R faz por padrão, a remove quase completamente por construção, sem alterar em nada a curva ajustada.
Executando em R
Ajustar as versões ortogonal e bruta, comparar graus e verificar o VIF cabe tudo em poucas linhas:
💡 Ajustando e comparando graus polinomiais em R
# Orthogonal polynomial (recommended, avoids the collinearity above)
fit2 <- lm(yield ~ poly(fert, 2), data = df)

# Equivalent raw polynomial (same fitted curve, correlated coefficients)
fit2_raw <- lm(yield ~ fert + I(fert^2), data = df)

# Compare nested degrees with an F-test
fit1 <- lm(yield ~ fert, data = df)
anova(fit1, fit2_raw)

# Or compare adjusted R-squared directly, see:
# /machine-learning/r-squared-adjusted-r-squared/
summary(fit1)$adj.r.squared
summary(fit2_raw)$adj.r.squared

# Multicollinearity between the polynomial terms
library(car)
vif(fit2_raw)
