t-SNE e UMAP
O t-SNE e o UMAP são métodos de redução de dimensionalidade não linear projetados para visualização. Diferentemente do PCA, que encontra uma projeção linear que maximiza a variância, eles preservam a estrutura de vizinhança local dos dados: pontos que estão próximos no espaço de alta dimensão permanecem próximos em 2D. O resultado é um mapa que revela clusters, estrutura de variedades (manifolds) e subpopulações invisíveis em um gráfico de PCA.
Por que o PCA não é suficiente para visualização
O PCA é uma projeção linear: encontra o melhor plano 2D plano através dos dados de alta dimensão. Se os dados estão em uma variedade curva (por exemplo, um rolo suíço, uma esfera, ou uma coleção de clusters conectados por pontes finas), a projeção linear esmaga a estrutura e sobrepõe regiões distantes.
O t-SNE e o UMAP aprendem um mapeamento não linear que “desdobra” a variedade, separando regiões que são genuinamente diferentes em alta dimensão, mesmo que se projetem na mesma região sob o PCA.
t-SNE: t-distributed Stochastic Neighbor Embedding
O t-SNE (van der Maaten e Hinton, 2008) converte distâncias em probabilidades separadamente nos espaços de alta e baixa dimensão, depois minimiza a divergência KL entre elas.
No espaço de alta dimensão: defina uma similaridade Gaussiana entre os pontos \(i\) e \(j\):
\[p_{j|i} = \frac{\exp(-\|x_i - x_j\|^2 / 2\sigma_i^2)}{\sum_{k \neq i} \exp(-\|x_i - x_k\|^2 / 2\sigma_i^2)}, \quad p_{ij} = \frac{p_{j|i} + p_{i|j}}{2n}\]
A largura de banda \(\sigma_i\) é ajustada de forma que o número efetivo de vizinhos (perplexidade) seja aproximadamente o parâmetro perplexity especificado pelo usuário.
No espaço de baixa dimensão: use uma distribuição t de Student com 1 grau de liberdade (caudas mais pesadas do que a Gaussiana):
\[q_{ij} = \frac{(1 + \|y_i - y_j\|^2)^{-1}}{\sum_{k \neq l}(1 + \|y_k - y_l\|^2)^{-1}}\]
Objetivo: minimizar a divergência KL \(\text{KL}(P \| Q) = \sum_{ij} p_{ij} \log(p_{ij}/q_{ij})\) via gradiente descendente.
Por que a distribuição t? Uma Gaussiana em baixa dimensão é muito concentrada: pontos moderadamente distantes em alta dimensão precisariam todos ficar amontoados em 2D (o problema do amontoamento). As caudas pesadas da distribuição t permitem que pontos moderadamente semelhantes sejam colocados mais distantes, dando espaço para os clusters “respirarem”.
UMAP: Uniform Manifold Approximation and Projection
O UMAP (McInnes et al., 2018) é construído sobre uma base matemática diferente (conjuntos simpliciais difusos e geometria Riemanniana), mas compartilha a mesma ideia de alto nível: preservar a estrutura de vizinhança. Principais diferenças em relação ao t-SNE:
- Mais rápido: \(O(n \log n)\) vs o \(O(n^2)\) do t-SNE (aproximação Barnes-Hut).
- Melhor estrutura global: o UMAP tenta preservar tanto relações locais quanto globais, não apenas as locais.
- Mais estável: menos sensível à inicialização aleatória; múltiplas execuções dão resultados mais semelhantes.
- Uso geral: pode projetar para dimensões arbitrárias, não apenas 2D.
O UMAP constrói uma representação topológica difusa dos dados, encontra uma representação de baixa dimensão com uma estrutura topológica semelhante, e otimiza a entropia cruzada entre os dois conjuntos difusos.
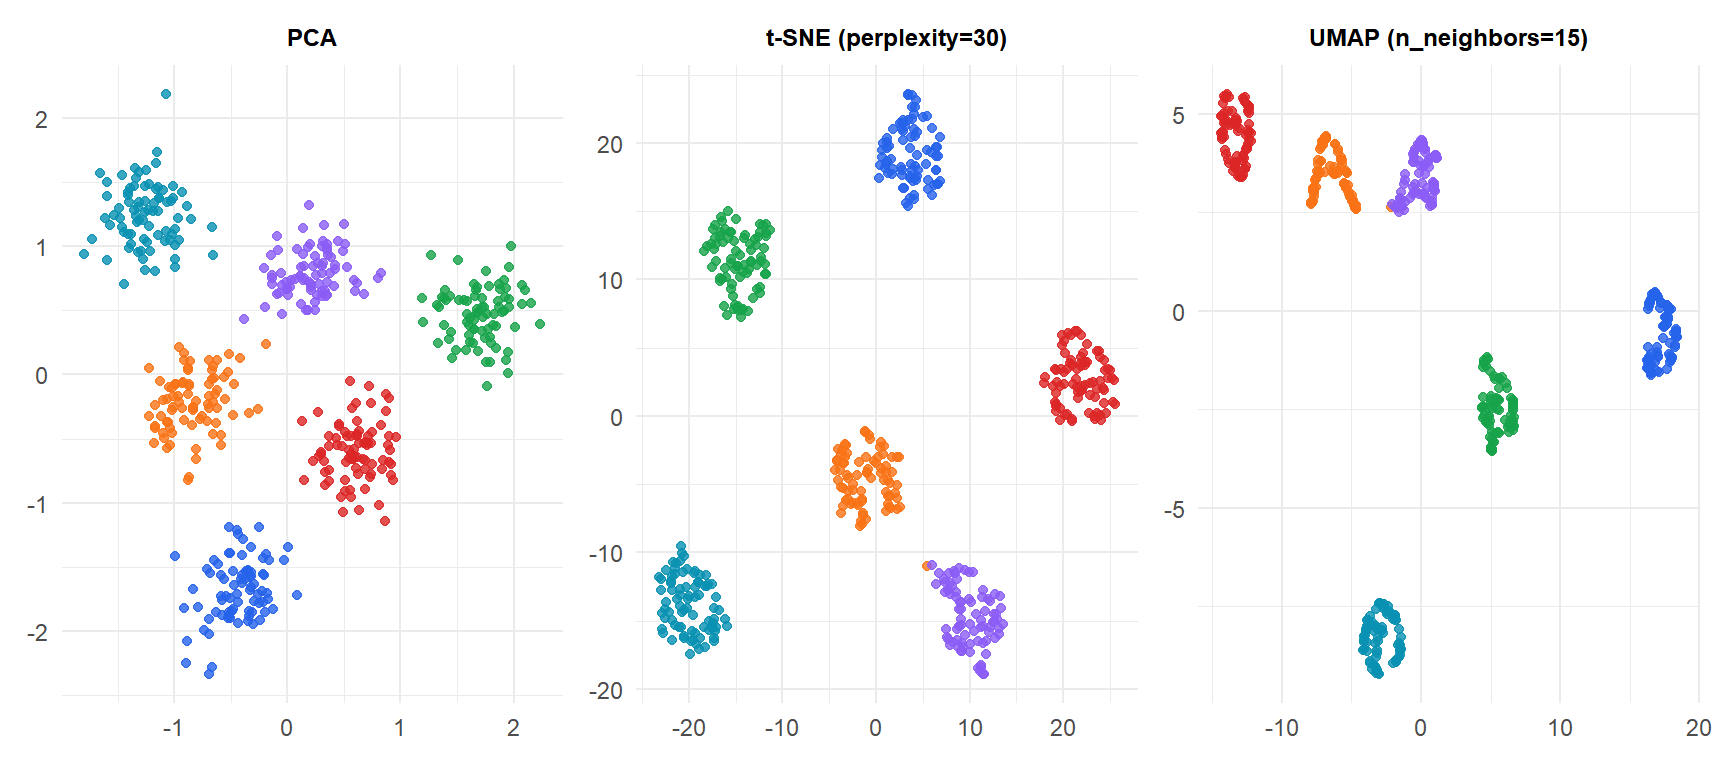
Os três métodos separam corretamente os seis clusters neste conjunto de dados 2D simples. A vantagem do t-SNE e do UMAP se torna clara com dados de alta dimensão (por exemplo, imagens, genômica, RNA-seq de célula única), em que o PCA sobrepõe subpopulações distintas.
Hiperparâmetros-chave
t-SNE: perplexidade
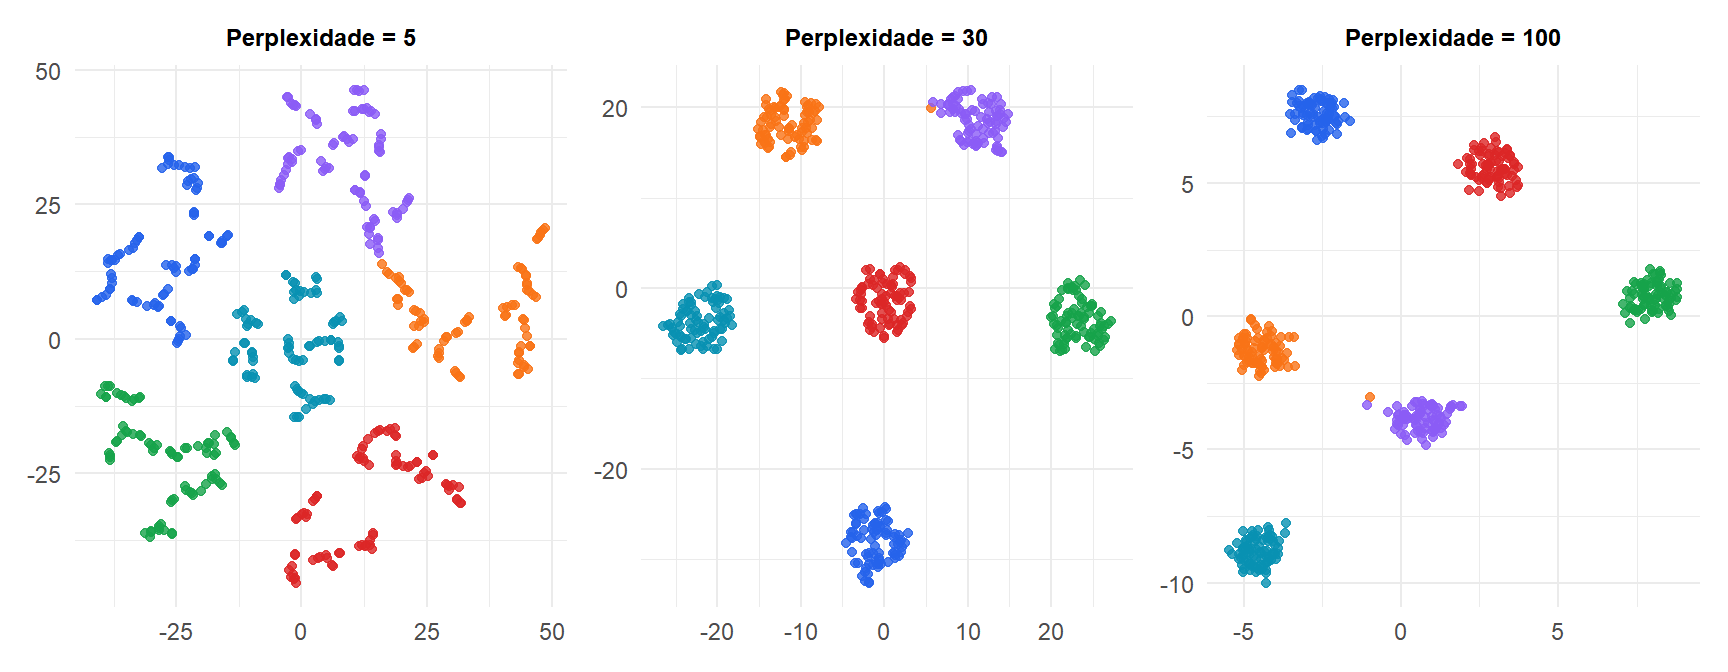
A perplexidade controla o número efetivo de vizinhos que cada ponto considera. Ela equilibra aproximadamente a atenção entre a estrutura local e global:
- Perplexidade baixa (5-10): muito local, clusters compactos, pode fragmentar clusters grandes em subclusters.
- Perplexidade alta (50-100): mais global, clusters podem se fundir.
- Faixa típica: 5 a 50. Padrão: 30.
Regra prática: a perplexidade deve ser menor do que \(n/3\).
UMAP: n_neighbors e min_dist
n_neighbors controla o tamanho da vizinhança local (como a perplexidade): valores maiores capturam mais estrutura global. min_dist controla o quão apertados os pontos ficam na representação: valores pequenos produzem clusters compactos; valores grandes espalham mais os pontos.
Armadilhas críticas na interpretação
Ambos os métodos produzem gráficos que parecem diagramas de dispersão comuns, o que tenta as pessoas a lê-los da mesma forma que leriam a saída de um PCA. Esse instinto está errado em várias formas específicas e evitáveis.
⚠️ Quatro coisas que os gráficos de t-SNE e UMAP NÃO dizem
1. Os tamanhos dos clusters não têm significado. O t-SNE expande clusters pequenos e densos e comprime os grandes e esparsos. O tamanho visual de um cluster não reflete o número de pontos ou a dispersão dos dados originais.
2. As distâncias entre clusters não são interpretáveis. O t-SNE otimiza a estrutura local; a distância entre dois clusters bem separados no gráfico 2D não tem significado quantitativo. O cluster A estar duas vezes mais distante do cluster B do que do cluster C não significa que ele seja duas vezes mais diferente.
3. O número de clusters não é confiável. Ambos os métodos podem dividir uma única população contínua em subclusters aparentes (especialmente o t-SNE com baixa perplexidade) ou fundir clusters distintos (com alta perplexidade). Sempre valide clusters aparentes com um algoritmo de clustering nos dados originais de alta dimensão.
4. Os resultados mudam com a semente aleatória. O t-SNE não é determinístico; cada execução com uma semente diferente produz um layout diferente. O UMAP é mais estável, mas ainda varia. Nunca baseie conclusões em uma única execução. Para o t-SNE, inicialize com PCA (pca_init=TRUE) e use múltiplas sementes.
t-SNE vs UMAP: quando usar cada um
| t-SNE | UMAP | |
|---|---|---|
| Velocidade | Lento (\(O(n^2)\), Barnes-Hut \(O(n \log n)\)) | Rápido (\(O(n \log n)\)) |
| Estrutura global | Fraca | Melhor |
| Estabilidade | Baixa (varia com a semente) | Maior |
| Escalabilidade | \(n < 100.000\) | \(n > 100.000\) viável |
| Interpretabilidade | Muito limitada | Ligeiramente melhor |
| Uso típico | Biologia, RNA-seq de célula única | Uso geral, grandes conjuntos de dados |
Para a maioria dos novos projetos: comece com o UMAP. Ele é mais rápido, mais estável, e preserva mais estrutura. Use o t-SNE ao comparar com trabalhos publicados que o usam, ou em genômica, onde é o padrão da área.
💡 t-SNE e UMAP em R
library(Rtsne)

# t-SNE (remove duplicates first, PCA init for stability)
set.seed(42)
tsne_res <- Rtsne(X, dims=2, perplexity=30, max_iter=1000,
                  pca=TRUE, pca_center=TRUE, normalize=TRUE,
                  check_duplicates=FALSE)
df_tsne <- data.frame(D1=tsne_res$Y[,1], D2=tsne_res$Y[,2])

# UMAP
library(umap)
set.seed(42)
umap_res <- umap(X, n_neighbors=15, min_dist=0.1, n_components=2)
df_umap  <- data.frame(D1=umap_res$layout[,1], D2=umap_res$layout[,2])

# uwot package (faster UMAP, more control)
library(uwot)
embedding <- uwot::umap(X, n_neighbors=15, min_dist=0.1,
                         metric="euclidean", n_epochs=200)
