Validação cruzada
A validação cruzada estima o quão bem um modelo terá desempenho em dados novos e não vistos, particionando repetidamente os dados disponíveis em conjuntos de treinamento e validação. É a ferramenta padrão para avaliação de modelos, seleção de hiperparâmetros, e comparação de modelos concorrentes. Usá-la incorretamente produz estimativas otimistas que não generalizam.
Por que uma única divisão treino/teste não é suficiente
Dividir os dados uma única vez em conjuntos de treinamento e teste é simples, mas ruidoso: o desempenho estimado depende fortemente de quais observações acabam em cada conjunto. Com \(n=200\) e uma divisão 80/20, o conjunto de teste tem apenas 40 observações: o erro estimado tem alta variância entre diferentes divisões aleatórias.
A validação cruzada resolve isso usando múltiplas divisões e calculando a média dos resultados. A estimativa fica mais estável, e obtemos uma medida de sua incerteza (desvio padrão entre os folds).
Validação cruzada k-fold
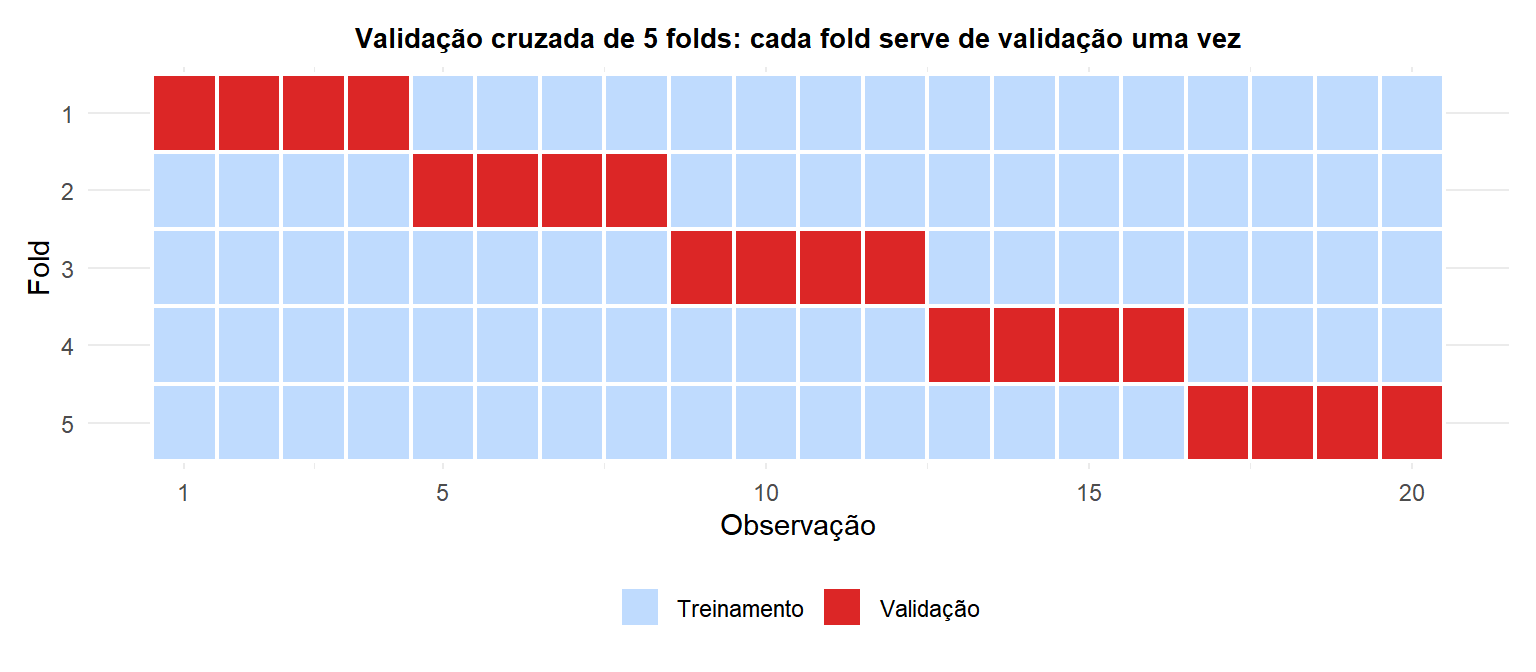
Particione os dados aleatoriamente em \(k\) folds de tamanho aproximadamente igual. Para cada fold \(i = 1, \ldots, k\):
- Treine o modelo nos outros \(k-1\) folds.
- Avalie no fold \(i\), registrando a métrica (por exemplo, EQM, acurácia).
A estimativa de VC é a média entre todos os \(k\) folds:
\[\widehat{\text{VC}}_k = \frac{1}{k}\sum_{i=1}^k \text{erro}_i\]
\[\widehat{\text{EP}} = \sqrt{\frac{1}{k(k-1)}\sum_{i=1}^k(\text{erro}_i - \widehat{\text{VC}}_k)^2}\]
O erro padrão \(\widehat{\text{EP}}\) quantifica a incerteza da estimativa de VC. A regra de um erro padrão: ao comparar modelos, escolha o modelo mais simples cujo erro de VC esteja dentro de um EP do mínimo. Isso favorece a parcimônia sem sacrificar muita precisão.
Escolhendo k: o equilíbrio viés-variância
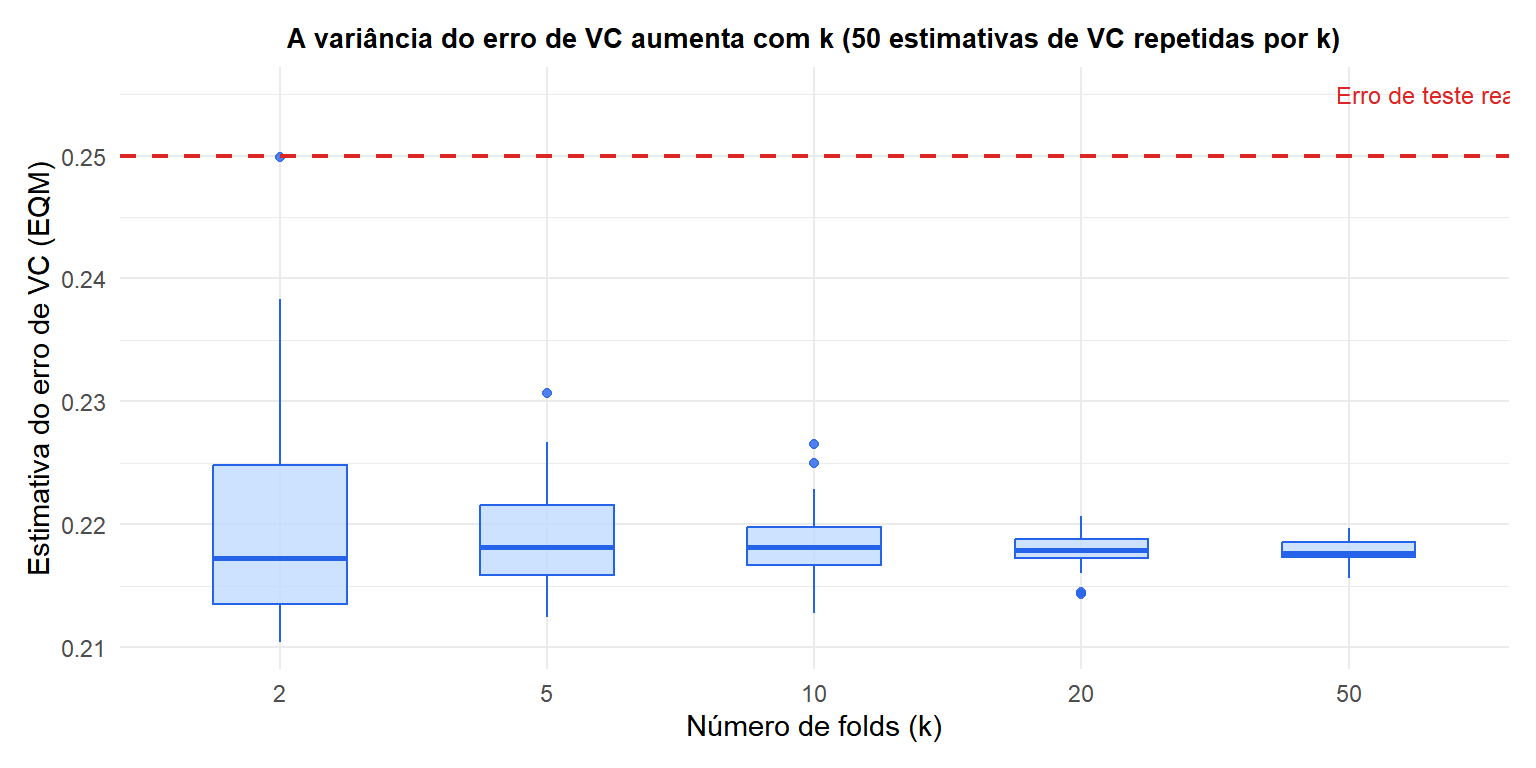
A escolha de \(k\) controla um equilíbrio viés-variância na própria estimativa de VC:
- \(k\) grande (por exemplo, LOOCV): os conjuntos de treinamento ficam próximos do tamanho \(n\) (viés baixo). Mas os \(k\) conjuntos de validação são quase idênticos (os modelos treinados neles são altamente correlacionados), então a variância da estimativa de VC é alta.
- \(k\) pequeno (por exemplo, \(k=2\)): os conjuntos de treinamento têm apenas \(n/2\) observações (viés alto: o modelo é mais fraco do que seria com os dados completos). Variância baixa.
- \(k=5\) ou \(k=10\): demonstrado empiricamente que dão um bom equilíbrio viés-variância. A escolha padrão.
O LOOCV (\(k=n\)) tem uma propriedade especial: para modelos lineares, existe uma fórmula de atalho que calcula o LOOCV sem reajustar \(n\) vezes:
\[\text{LOOCV} = \frac{1}{n}\sum_{i=1}^n \left(\frac{y_i - \hat{y}_i}{1 - h_{ii}}\right)^2\]
em que \(h_{ii}\) é o leverage da observação \(i\). Isso torna o LOOCV prático para modelos lineares, mas ele ainda tem alta variância como estimador.
Variantes da validação cruzada
K-fold estratificado
Para classificação com classes desbalanceadas, garanta que cada fold tenha as mesmas proporções de classes do conjunto de dados completo. Sem estratificação, um fold pode conter muito poucos exemplos da classe minoritária, tornando a estimativa do erro ruidosa e não representativa. Sempre use VC estratificada para classificação.
K-fold repetido
Repita a VC k-fold \(r\) vezes com partições aleatórias diferentes. Calcule a média sobre todos os \(r \times k\) folds. Dá estimativas mais estáveis ao custo de \(r\) vezes mais computação. Útil quando \(n\) é pequeno.
VC para séries temporais (validação walk-forward)
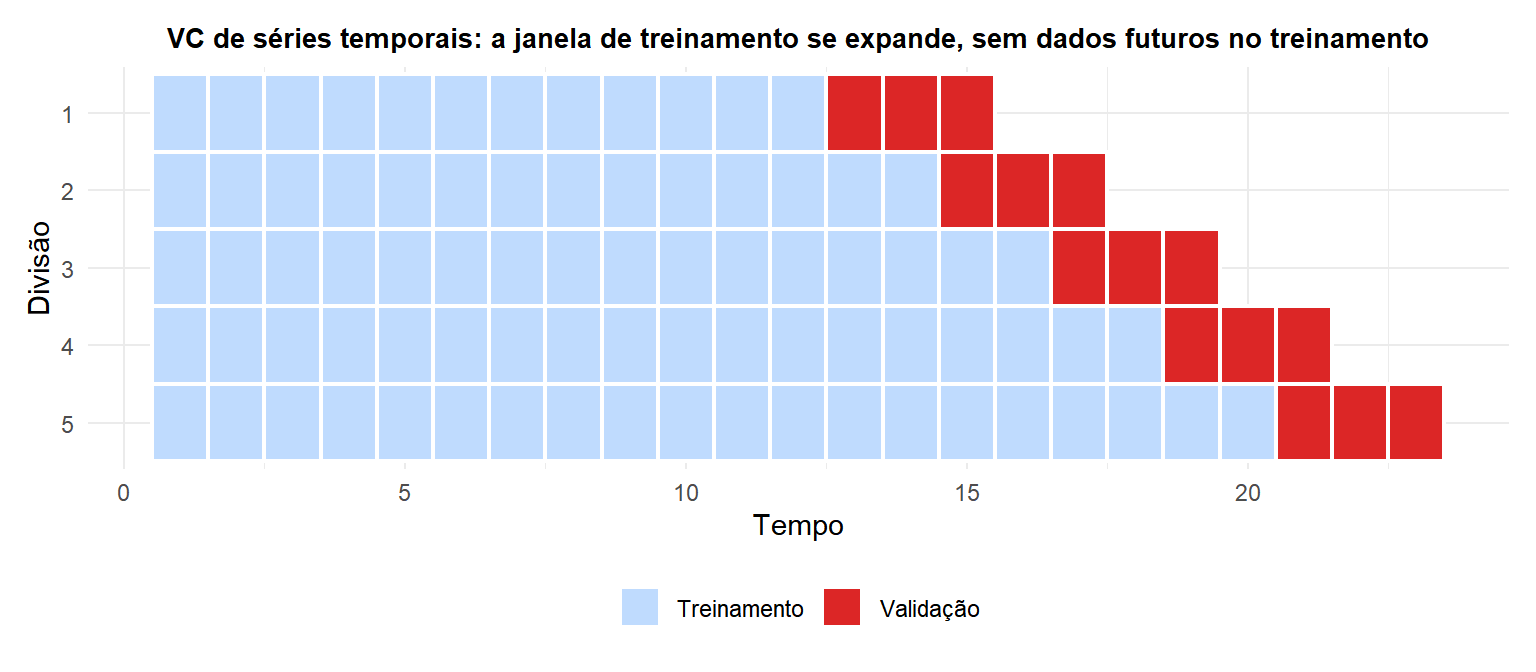
A VC k-fold padrão embaralha aleatoriamente os dados, criando folds de treinamento que contêm observações futuras. Para séries temporais, isso é vazamento de dados: o modelo “vê o futuro” durante o treinamento.
A VC para séries temporais usa janelas expansivas ou deslizantes: treina nas observações \(1, \ldots, t\) e avalia em \(t+1, \ldots, t+h\) para valores crescentes de \(t\).
Validação cruzada aninhada: evitando o vazamento de dados
Um erro comum: usar VC para selecionar hiperparâmetros e depois reportar esse mesmo erro de VC como a estimativa de desempenho do modelo. Isso é otimista porque os folds de teste influenciaram a seleção de hiperparâmetros.
A VC aninhada usa dois laços:
- Laço externo: \(k_\text{externo}\) folds para estimação de desempenho sem viés.
- Laço interno: para cada conjunto de treinamento externo, executa VC k-fold interna para selecionar hiperparâmetros.
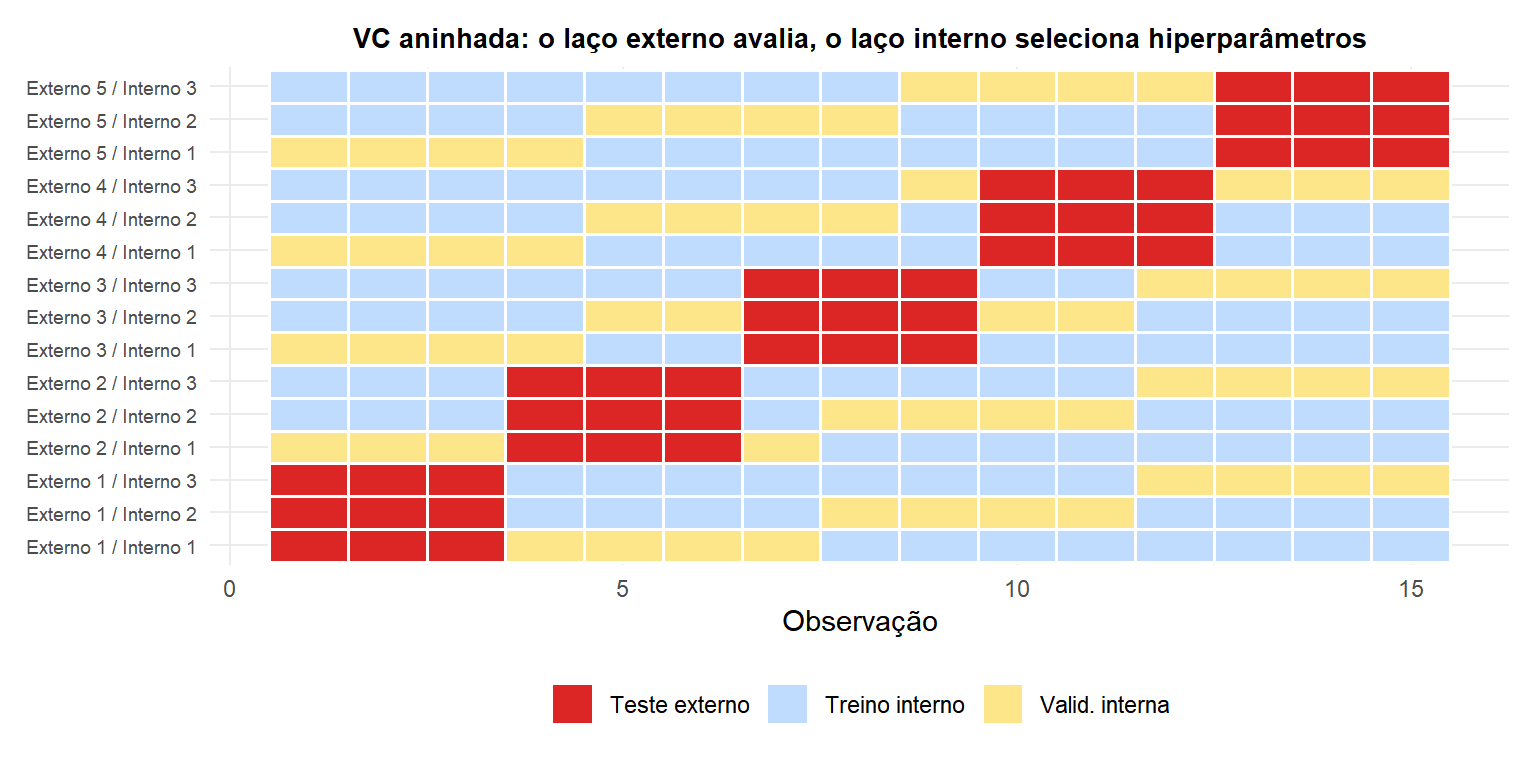
Os folds de teste externos (vermelho) nunca são vistos durante a seleção de hiperparâmetros. Os folds de validação internos (amarelo) são usados para selecionar os melhores hiperparâmetros para o conjunto de treinamento de cada fold externo. O erro de VC externo é uma estimativa sem viés do desempenho do modelo final.
⚠️ Usar o erro de VC para seleção de modelos e para reportar é usar os dados duas vezes
Se você usar VC para selecionar entre 50 modelos e reportar o erro de VC do vencedor, o erro reportado é otimista: você buscou entre 50 modelos e escolheu o mais sortudo. Quanto mais modelos você compara, maior é o otimismo.
Procedimento correto: use VC aninhada, ou reserve um conjunto de teste final que nunca é usado para nenhuma decisão de seleção de modelo (sem ajuste de hiperparâmetros, sem seleção de atributos, sem comparação de modelos). O conjunto de teste final é usado exatamente uma vez, no final, para reportar o desempenho definitivo.
💡 Validação cruzada em R
library(caret)

# 10-fold CV
ctrl <- trainControl(method="cv", number=10)
fit  <- train(y ~ ., data=df, method="glm", trControl=ctrl)
fit$results   # CV metrics per fold
fit$resample  # individual fold results

# Stratified k-fold for classification
ctrl_strat <- trainControl(method="cv", number=10,
                            classProbs=TRUE, summaryFunction=twoClassSummary)

# Repeated 10-fold
ctrl_rep <- trainControl(method="repeatedcv", number=10, repeats=5)

# Nested CV
library(mlr3)
library(mlr3tuning)
task    <- as_task_classif(df, target="y")
learner <- lrn("classif.ranger", predict_type="prob")
resampling_outer <- rsmp("cv", folds=5)
resampling_inner <- rsmp("cv", folds=3)
measure  <- msr("classif.auc")
tuner    <- tnr("grid_search")
at <- AutoTuner$new(learner, resampling_inner, measure, tuner=tuner,
                    terminator=trm("evals", n_evals=20))
rr <- resample(task, at, resampling_outer)
rr$aggregate(measure)   # unbiased performance estimate
