Distribuição binomial negativa
A distribuição binomial negativa modela o número de fracassos antes de um número-alvo de sucessos em uma sequência de ensaios de Bernoulli independentes. Também é amplamente usada como um modelo flexível para dados de contagem com sobredispersão, em que a variância supera a média.
Definição
Uma variável aleatória \(X\) segue uma distribuição binomial negativa com parâmetros \(r > 0\) (número de sucessos) e \(p \in (0,1)\) (probabilidade de sucesso por ensaio), escrita \(X \sim \text{NegBin}(r, p)\), se:
\[P(X = k) = \binom{k + r - 1}{k} p^r (1-p)^k, \quad k = 0, 1, 2, \ldots\]
em que \(k\) é o número de fracassos antes do \(r\)-ésimo sucesso.
A binomial negativa generaliza a distribuição geométrica: quando \(r = 1\), ela se reduz ao número de fracassos antes do primeiro sucesso.
⚠️ Duas parametrizações: saiba qual o seu software usa
A binomial negativa tem duas parametrizações comuns:
1. Contando fracassos (usada acima): \(X\) = número de fracassos antes de \(r\) sucessos. Parâmetros: \(r\) (sucessos) e \(p\) (probabilidade de sucesso). É a versão dos livros didáticos.
2. Modelo de sobredispersão (usado em R, Python e na maioria dos softwares de regressão): \(X\) = contagem de eventos, parametrizada pela média \(\mu\) e pelo parâmetro de dispersão \(r\) (também chamado de size). A PMF é:
\[P(X = k) = \binom{k + r - 1}{k} \left(\frac{r}{r + \mu}\right)^r \left(\frac{\mu}{r + \mu}\right)^k\]
com \(\text{Var}(X) = \mu + \mu^2/r > \mu\). Quando \(r \to \infty\), a variância se aproxima da média e a distribuição converge para Poisson.
Em R: dnbinom(x, size = r, prob = p) usa a parametrização 1; dnbinom(x, size = r, mu = mu) usa a parametrização 2.
Função de massa de probabilidade e CDF
A CDF acumula a PMF:
\[F(k) = P(X \leq k) = \sum_{i=0}^{k} \binom{i+r-1}{i} p^r (1-p)^i\]
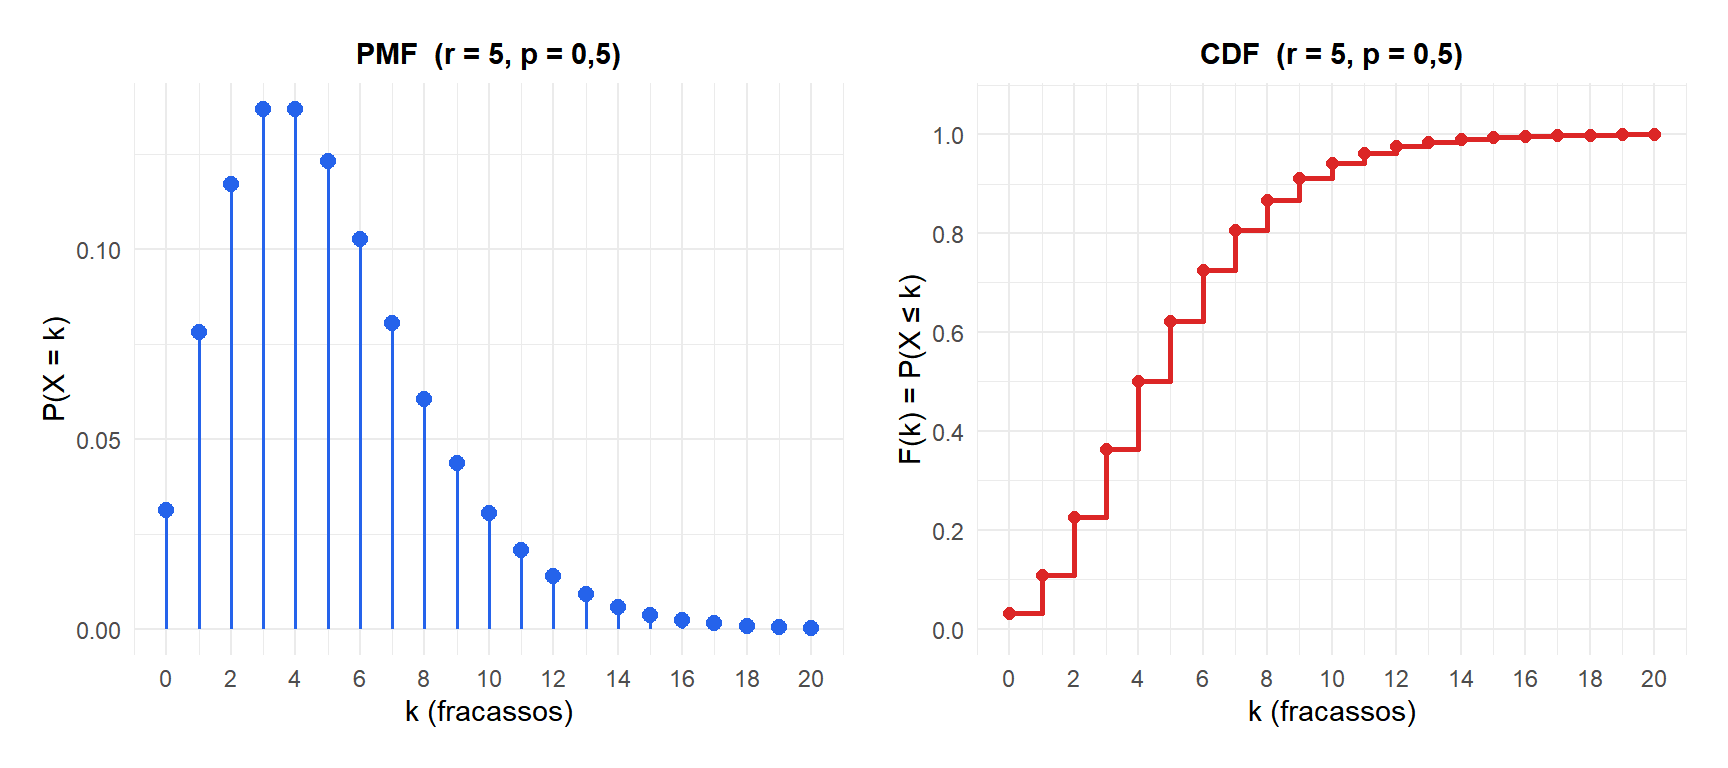
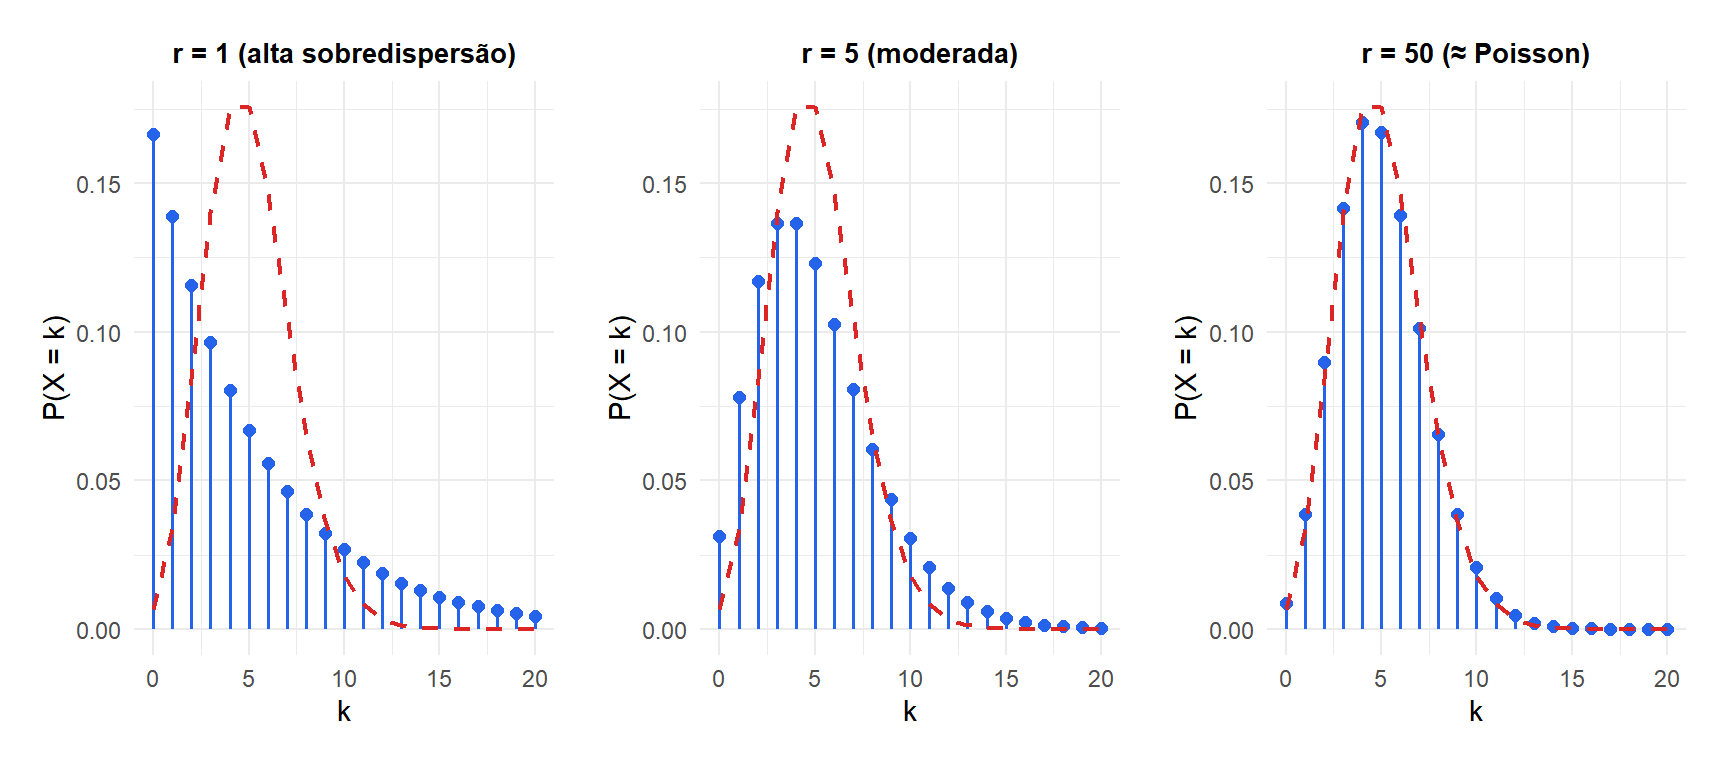
Figure 1: À medida que o parâmetro de dispersão r aumenta, a binomial negativa converge para Poisson (mesma média, menos sobredispersão)
Propriedades
Para \(X \sim \text{NegBin}(r, p)\) na parametrização de fracassos antes de sucessos:
- Valor esperado (média)
\[E(X) = \frac{r(1-p)}{p}\]
- Variância
\[\text{Var}(X) = \frac{r(1-p)}{p^2}\]
Como \(\text{Var}(X) = E(X)/p > E(X)\) para \(p < 1\), a binomial negativa sempre tem variância maior que sua média: isso é sobredispersão por construção.
- Assimetria
\[\text{Assimetria} = \frac{2 - p}{\sqrt{r(1-p)}}\]
- Curtose
\[g_2 = \frac{6}{r} + \frac{p^2}{r(1-p)}\]
- Moda
\[\text{Moda} = \left\lfloor \frac{(r-1)(1-p)}{p} \right\rfloor \quad \text{para } r > 1\]
Quando \(r = 1\) (geométrica), a moda é 0.
- Função quantil
Não tem forma fechada; é calculada numericamente.
Exemplo passo a passo
Um representante de vendas farmacêutico precisa fechar 3 negócios (\(r = 3\)). Cada ligação de vendas tem sucesso com probabilidade \(p = 0{,}2\). Seja \(X\) = número de ligações sem sucesso antes do 3º sucesso, \(X \sim \text{NegBin}(3, 0{,}2)\).
Probabilidade de exatamente 7 fracassos antes do 3º sucesso:
\[P(X = 7) = \binom{7+3-1}{7}(0{,}2)^3(0{,}8)^7 = \binom{9}{7}(0{,}008)(0{,}2097) \approx 36 \times 0{,}001678 \approx 0{,}0604\]
Número esperado de ligações sem sucesso:
\[E(X) = \frac{3 \times 0{,}8}{0{,}2} = 12 \text{ fracassos}\]
Variância:
\[\text{Var}(X) = \frac{3 \times 0{,}8}{0{,}04} = 60\]
O desvio padrão é \(\sqrt{60} \approx 7{,}75\), refletindo a grande dispersão: alguns representantes fecharão rapidamente, outros precisarão de muito mais ligações.
Um pesquisador de saúde conta o número de consultas médicas por ano de 500 pacientes. A média amostral é 3,2 consultas e a variância amostral é 8,7. Como a variância (8,7) é muito maior que a média (3,2), um modelo de Poisson é inadequado.
Ajustando uma binomial negativa com \(\mu = 3{,}2\) e \(r\) estimado em 2,1:
\[\text{Var}(X) = \mu + \frac{\mu^2}{r} = 3{,}2 + \frac{10{,}24}{2{,}1} \approx 3{,}2 + 4{,}9 = 8{,}1\]
A binomial negativa captura a sobredispersão que a Poisson não consegue modelar.

Sobredispersão e a conexão com a Poisson
A binomial negativa é a alternativa padrão à Poisson quando dados de contagem apresentam sobredispersão. Quando \(r \to \infty\) com \(\mu = r(1-p)/p\) fixo, a binomial negativa converge para \(\text{Poisson}(\mu)\). O parâmetro \(r\) controla quanta variância extra existe além da Poisson: \(r\) pequeno significa sobredispersão forte, \(r\) grande significa próximo de Poisson.
Na prática, um modelo de regressão binomial negativa é ajustado sempre que uma regressão de Poisson mostra sinais de sobredispersão (deviance residual muito maior que os graus de liberdade, ou um teste de dispersão significativo).
💡 Relação com outras distribuições
- Geométrica: NegBin\((1, p)\) = Geométrica\((p)\) (fracassos antes do primeiro sucesso).
- Poisson: caso limite quando \(r \to \infty\) com a média fixa.
- Binomial: a binomial negativa conta fracassos em uma sequência ilimitada; a binomial conta sucessos em um número fixo de ensaios.
- Mistura Gama-Poisson: a binomial negativa surge naturalmente quando \(\lambda\) em um modelo de Poisson segue uma distribuição Gama, o que explica por que ela lida bem com a heterogeneidade da população.

