Distribuição lognormal
A distribuição lognormal modela variáveis que são sempre positivas e têm assimetria positiva, em que o logaritmo da variável segue uma distribuição normal. Ela aparece naturalmente sempre que uma quantidade é o produto de muitos fatores aleatórios independentes.
Definição
Uma variável aleatória \(X\) segue uma distribuição lognormal com parâmetros \(\mu \in \mathbb{R}\) e \(\sigma > 0\), escrita \(X \sim \text{Lognormal}(\mu, \sigma)\), se \(Y = \ln(X) \sim N(\mu, \sigma)\).
Sua função de densidade de probabilidade é:
\[f(x) = \frac{1}{x\sigma\sqrt{2\pi}}\exp\left(-\frac{(\ln x - \mu)^2}{2\sigma^2}\right), \quad x > 0\]
⚠️ μ e σ são parâmetros de ln(X), não de X
Essa é a fonte de confusão mais comum. Em \(X \sim \text{Lognormal}(\mu, \sigma)\):
- \(\mu\) é a média de \(\ln(X)\), não de \(X\).
- \(\sigma\) é o desvio padrão de \(\ln(X)\), não de \(X\).
A média real de \(X\) é \(e^{\mu + \sigma^2/2}\), que é sempre maior que \(e^\mu\). Se alguém disser “essa variável tem distribuição lognormal com média 0 e desvio padrão 1”, quase certamente quer dizer que \(\ln(X) \sim N(0,1)\), não que \(E(X) = 0\).
A CDF tem uma forma simples em termos da CDF normal padrão \(\Phi\):
\[F(x) = \Phi\left(\frac{\ln x - \mu}{\sigma}\right)\]
Isso torna os cálculos de probabilidade diretos: padronize \(\ln(x)\) e consulte a tabela normal padrão.
PDF e CDF
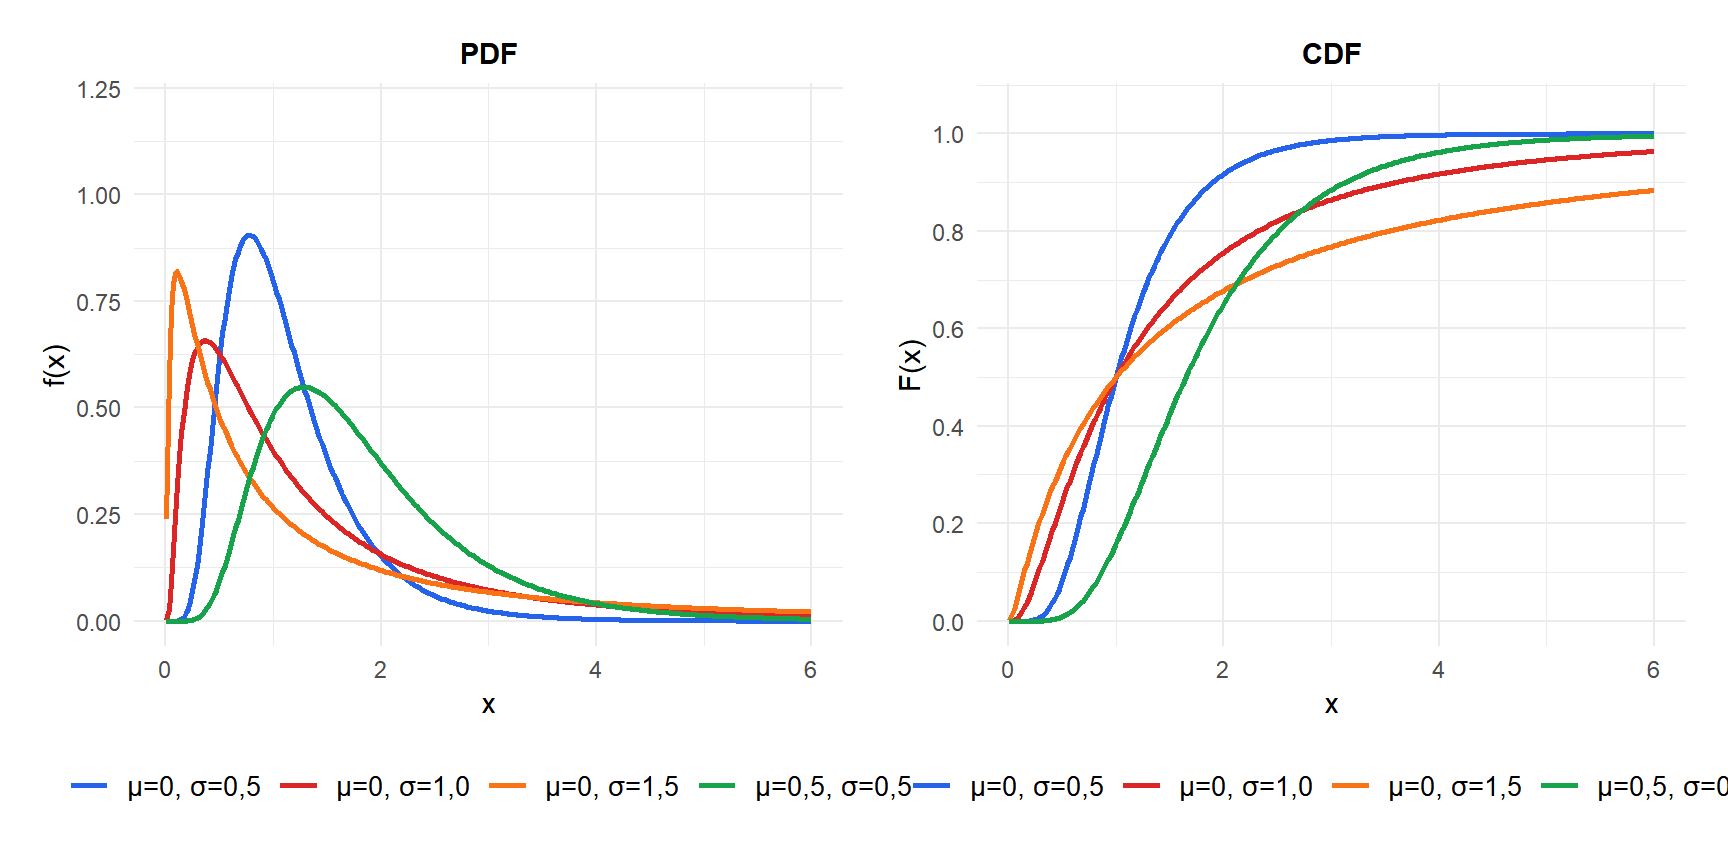
Propriedades
Para \(X \sim \text{Lognormal}(\mu, \sigma)\):
- Valor esperado (média)
\[E(X) = e^{\mu + \sigma^2/2}\]
- Variância
\[\text{Var}(X) = \left(e^{\sigma^2} - 1\right)e^{2\mu + \sigma^2}\]
- Mediana
\[\text{Mediana}(X) = e^{\mu}\]
A mediana é sempre menor que a média (já que \(e^{\mu} < e^{\mu + \sigma^2/2}\)), refletindo a assimetria à direita.
- Moda
\[\text{Moda}(X) = e^{\mu - \sigma^2}\]
A moda é a menor das três: Moda \(<\) Mediana \(<\) Média, uma característica das distribuições com assimetria à direita.
- Assimetria
\[\text{Assimetria} = \left(e^{\sigma^2} + 2\right)\sqrt{e^{\sigma^2} - 1}\]
Sempre positiva. Para \(\sigma = 1\): assimetria \(\approx 6{,}18\).
- Curtose
\[g_2 = e^{4\sigma^2} + 2e^{3\sigma^2} + 3e^{2\sigma^2} - 6\]
Para \(\sigma = 1\): \(g_2 \approx 110{,}9\), extremamente leptocúrtica. A lognormal tem caudas muito pesadas para valores grandes de \(\sigma\).
- Função quantil
\[Q(p) = e^{\mu + \sigma\,\Phi^{-1}(p)}\]
em que \(\Phi^{-1}\) é a função quantil da normal padrão.
Por que a lognormal aparece na prática
A lognormal surge naturalmente sempre que uma quantidade é o produto de muitos fatores aleatórios positivos independentes. Pelo Teorema Central do Limite aplicado aos logaritmos:
\[\ln(X) = \ln(X_1 \cdot X_2 \cdots X_n) = \sum_{i=1}^n \ln(X_i) \xrightarrow{} N(\mu, \sigma)\]
Logo, \(X\) é lognormal. É por isso que ela descreve:
- Preços de ações: o preço de hoje é o preço de ontem multiplicado por um fator de retorno aleatório.
- Distribuições de renda: os salários resultam de ajustes multiplicativos ao longo de uma carreira.
- Tamanhos biológicos: o crescimento celular é multiplicativo em cada divisão.
- Tempos de reparo: cada etapa de um processo de reparo multiplica a duração da anterior.
💡 Transforme para a escala logarítmica e trabalhe em escala normal
A principal vantagem prática da lognormal: se \(X\) é lognormal, então \(\ln(X)\) é normal, e todas as ferramentas da distribuição normal se aplicam. Para encontrar \(P(X \leq x)\), calcule \(P(\ln X \leq \ln x) = \Phi((\ln x - \mu)/\sigma)\). Para encontrar o percentil 90 de \(X\), encontre o percentil 90 de \(\ln(X)\) e exponencie. Trabalhar em escala logarítmica transforma um problema lognormal em um problema normal.
Exemplo passo a passo
Os retornos diários de uma ação são aproximadamente normais, então seu preço segue um processo lognormal. Suponha que as variações do log-preço tenham \(\mu = 0{,}001\) (tendência diária) e \(\sigma = 0{,}02\) (volatilidade diária). A ação é negociada atualmente a 100 USD.
Após um dia de negociação, o preço \(P \sim 100 \cdot \text{Lognormal}(0{,}001;\, 0{,}02)\).
Preço esperado para amanhã:
\[E(P) = 100 \cdot e^{0{,}001 + 0{,}02^2/2} = 100 \cdot e^{0{,}0012} \approx 100{,}12 \text{ USD}\]
Probabilidade de o preço cair abaixo de 98 USD:
Padronizando: \(z = (\ln(98/100) - 0{,}001)/0{,}02 = (\ln(0{,}98) - 0{,}001)/0{,}02 \approx (-0{,}0202 - 0{,}001)/0{,}02 \approx -1{,}06\)
\[P(P < 98) = \Phi(-1{,}06) \approx 0{,}145\]
Cerca de 14,5% de chance de uma queda abaixo de 98 USD em um dia.
Percentil 90 do preço de amanhã:
\[Q(0{,}90) = 100 \cdot e^{0{,}001 + 0{,}02 \times 1{,}282} \approx 100 \cdot e^{0{,}02664} \approx 102{,}70 \text{ USD}\]
Renda: a renda familiar em um país segue aproximadamente \(\text{Lognormal}(10{,}5;\, 0{,}8)\) (em unidades da moeda local). Renda média: \(e^{10{,}5 + 0{,}32} \approx e^{10{,}82} \approx 50.000\). Renda mediana: \(e^{10{,}5} \approx 36.000\). A média é 39% maior que a mediana, refletindo a longa cauda direita dos que ganham mais.
Tempo de resposta de um site: a latência das requisições costuma seguir uma distribuição lognormal. Se \(\mu = 2\) e \(\sigma = 0{,}5\) (em log-milissegundos), a latência mediana é \(e^2 \approx 7{,}4\) ms e o percentil 99 é \(e^{2 + 0{,}5 \times 2{,}326} \approx e^{3{,}163} \approx 23{,}6\) ms.

💡 Relação com outras distribuições
- Normal: \(\ln(X) \sim N(\mu, \sigma)\) por definição.
- Exponencial: não são um caso exato uma da outra, mas ambas modelam dados positivos com assimetria à direita. Use a exponencial para processos sem memória, a lognormal para processos multiplicativos.
- Pareto: para caudas muito pesadas (comportamento de lei de potência), a distribuição de Pareto é mais apropriada do que a lognormal.
- Transformação logarítmica em regressão: modelos de regressão log-linear assumem que a resposta é lognormal dado o valor dos preditores.

