Coeficiente de correlação de Pearson
O coeficiente de correlação de Pearson mede a força e a direção da relação linear entre duas variáveis quantitativas. É uma das estatísticas mais usadas em pesquisa, e também uma das mais mal interpretadas.
Definição
O coeficiente de correlação de Pearson \(r\) é uma medida padronizada da associação linear entre duas variáveis \(X\) e \(Y\). Ele sempre fica entre \(-1\) e \(1\):
- \(r = 1\): relação linear positiva perfeita.
- \(r = -1\): relação linear negativa perfeita.
- \(r = 0\): nenhuma relação linear.
A fórmula expressa \(r\) como a razão entre a covariância e o produto dos desvios padrão:
\[ r = \frac{\sum_{i=1}^{n}(x_i - \bar{x})(y_i - \bar{y})}{\sqrt{\sum_{i=1}^{n}(x_i - \bar{x})^2 \cdot \sum_{i=1}^{n}(y_i - \bar{y})^2}} \]
Isso é equivalente a:
\[r = \frac{s_{XY}}{s_X \cdot s_Y}\]
em que \(s_{XY}\) é a covariância amostral, e \(s_X\), \(s_Y\) são os desvios padrão amostrais. Dividir pelos desvios padrão remove as unidades, tornando \(r\) adimensional e diretamente comparável entre conjuntos de dados.
Interpretando o valor de r
O sinal indica a direção; o valor absoluto indica a força:
| Valor de \(\|r\|\) | Interpretação |
|---|---|
| \(0{,}9 - 1{,}0\) | Muito forte |
| \(0{,}7 - 0{,}9\) | Forte |
| \(0{,}5 - 0{,}7\) | Moderada |
| \(0{,}3 - 0{,}5\) | Fraca |
| \(0{,}0 - 0{,}3\) | Muito fraca ou negligenciável |
Esses limiares são orientações, não regras fixas. O que conta como uma correlação “forte” depende muito da área: em física, \(r = 0{,}7\) pode ser decepcionante; em psicologia ou ciências sociais, pode ser um resultado notável.
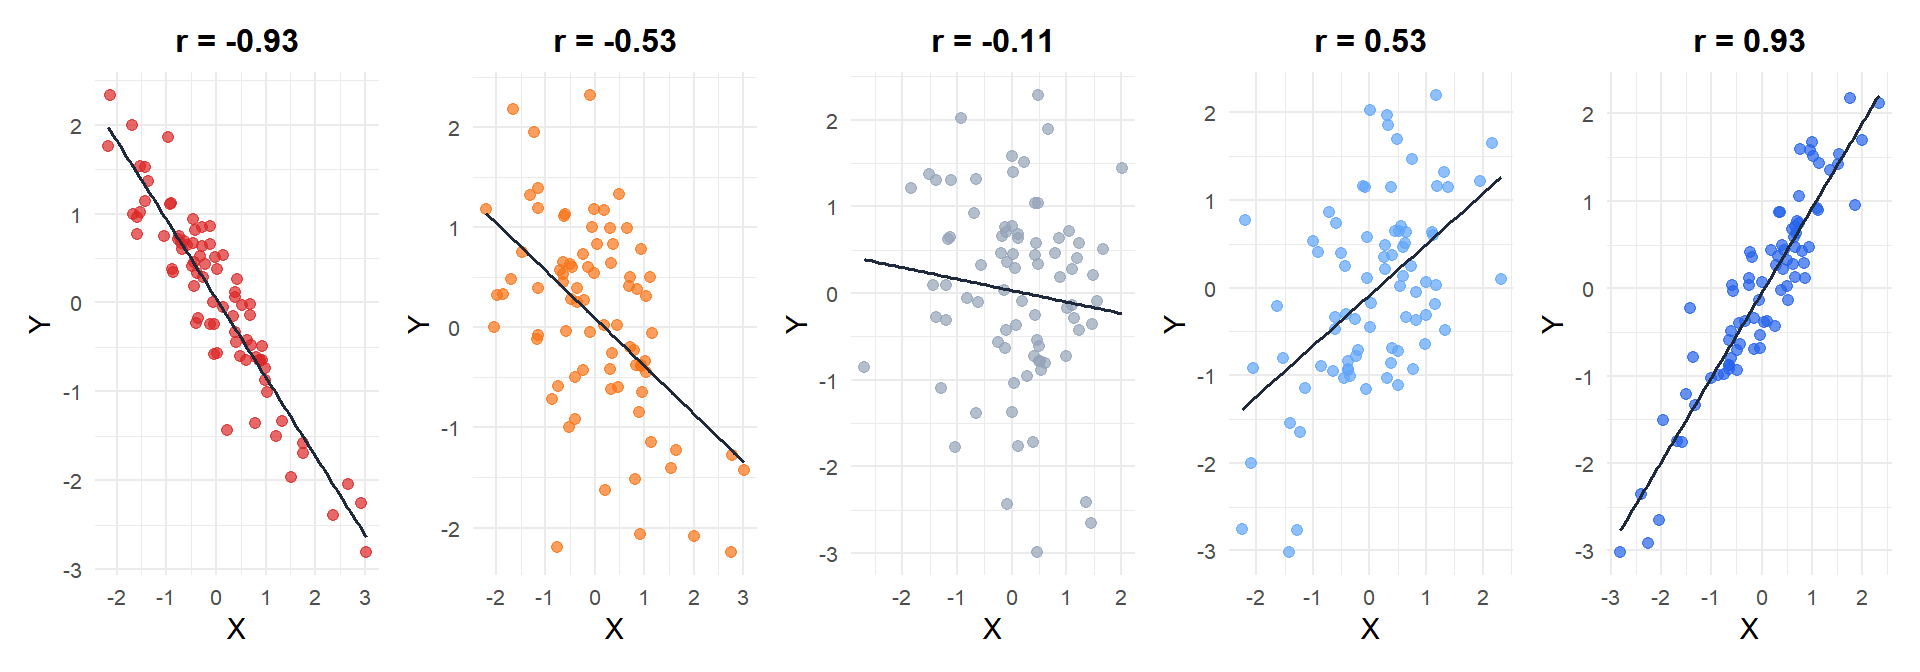
Figure 1: Da esquerda para a direita: negativa forte, negativa fraca, sem correlação, positiva fraca e positiva forte
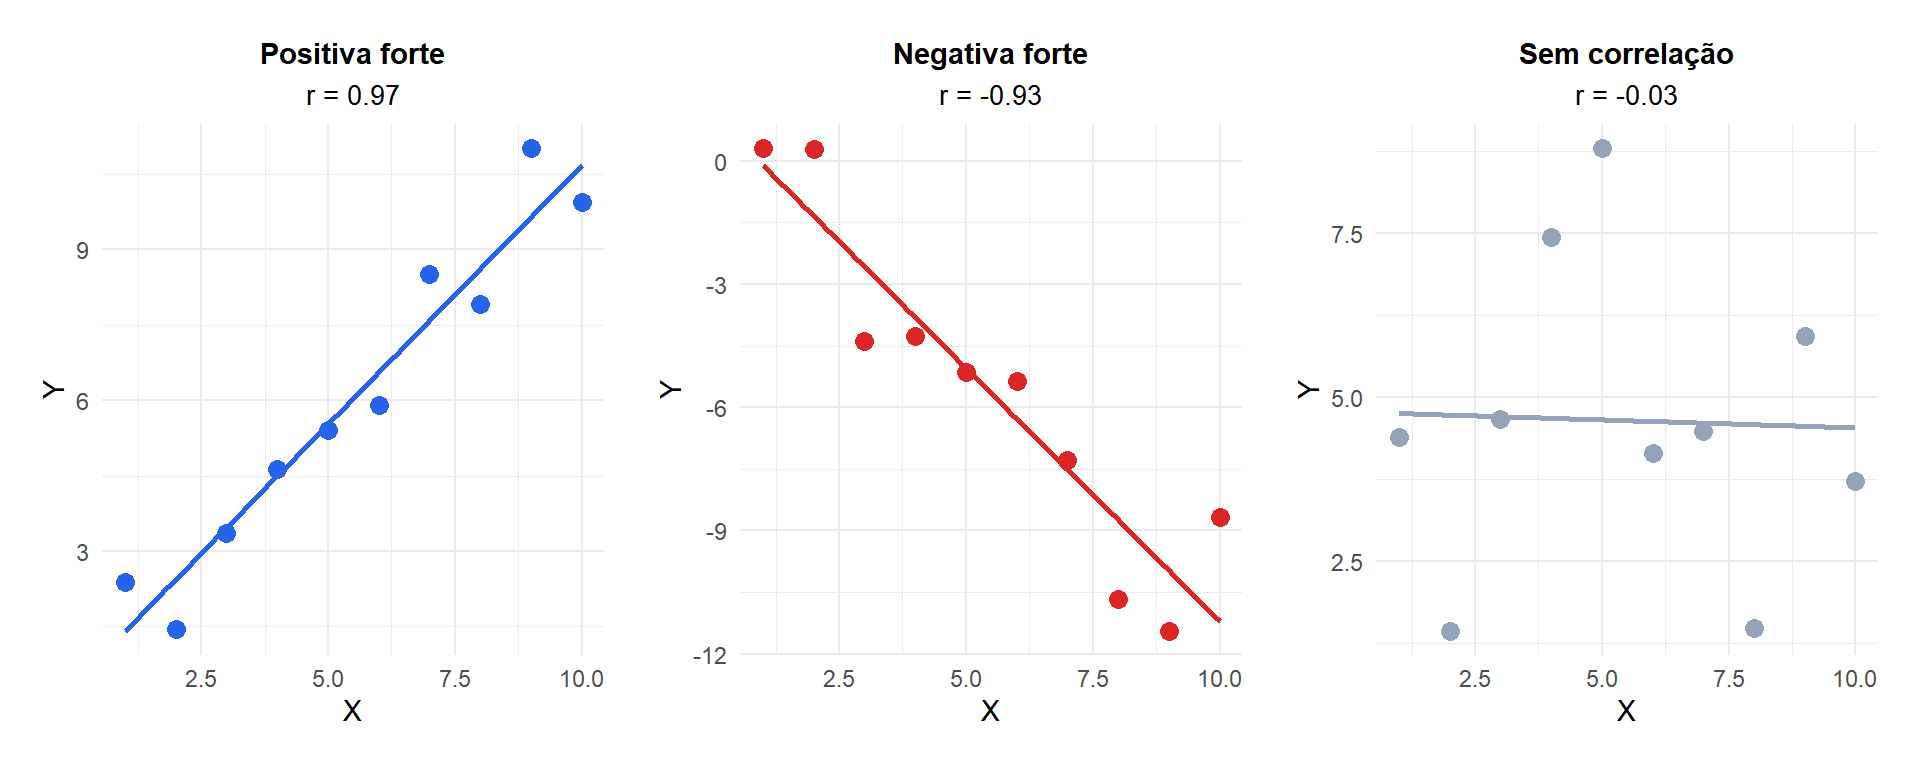
Figure 2: Direção da relação linear: positiva, negativa e sem correlação
Exemplo passo a passo
Um professor registra as horas de estudo e as notas da prova de cinco alunos:
| Aluno | Horas (\(X\)) | Nota (\(Y\)) |
|---|---|---|
| 1 | 2 | 50 |
| 2 | 3 | 60 |
| 3 | 5 | 80 |
| 4 | 7 | 85 |
| 5 | 9 | 95 |
Passo 1: calcular as médias.
\[\bar{x} = \frac{2+3+5+7+9}{5} = 5{,}2, \quad \bar{y} = \frac{50+60+80+85+95}{5} = 74\]
Passo 2: calcular os desvios e seus produtos.
| \(x_i\) | \(y_i\) | \(x_i-\bar{x}\) | \(y_i-\bar{y}\) | \((x_i-\bar{x})(y_i-\bar{y})\) | \((x_i-\bar{x})^2\) | \((y_i-\bar{y})^2\) |
|---|---|---|---|---|---|---|
| 2 | 50 | \(-3{,}2\) | \(-24\) | \(76{,}8\) | \(10{,}24\) | \(576\) |
| 3 | 60 | \(-2{,}2\) | \(-14\) | \(30{,}8\) | \(4{,}84\) | \(196\) |
| 5 | 80 | \(-0{,}2\) | \(6\) | \(-1{,}2\) | \(0{,}04\) | \(36\) |
| 7 | 85 | \(1{,}8\) | \(11\) | \(19{,}8\) | \(3{,}24\) | \(121\) |
| 9 | 95 | \(3{,}8\) | \(21\) | \(79{,}8\) | \(14{,}44\) | \(441\) |
| Soma | \(206{,}0\) | \(32{,}80\) | \(1370\) |
Passo 3: aplicar a fórmula.
\[r = \frac{206{,}0}{\sqrt{32{,}80 \times 1370}} = \frac{206{,}0}{\sqrt{44936}} = \frac{206{,}0}{212{,}0} \approx 0{,}97\]
Uma correlação de \(0{,}97\) indica uma relação linear positiva muito forte: os alunos que estudam mais horas obtêm notas consistentemente mais altas na prova.
O coeficiente de determinação \(r^2\)
Elevar o coeficiente de correlação ao quadrado dá \(r^2\), o coeficiente de determinação. Ele representa a proporção da variância de \(Y\) que é explicada por \(X\):
\[r^2 = 0{,}97^2 \approx 0{,}94\]
Neste exemplo, 94% da variabilidade nas notas da prova pode ser explicada pelas horas de estudo. Os 6% restantes se devem a outros fatores não capturados no modelo.
💡 r ou r²: qual reportar?
Limitações
Correlação não é causalidade
⚠️ A interpretação errada mais comum em estatística
Uma correlação alta entre duas variáveis não significa que uma cause a outra. As vendas de sorvete e as taxas de afogamento são positivamente correlacionadas, mas o sorvete não causa afogamentos: ambos são impulsionados pelo calor. O número de filmes lançados com Nicolas Cage se correlaciona com afogamentos em piscinas. O consumo per capita de queijo se correlaciona com mortes por se enroscar em lençóis. Essas são chamadas de correlações espúrias, e são embaraçosamente fáceis de encontrar em conjuntos de dados grandes. Pense sempre no mecanismo antes de inferir causalidade a partir de uma correlação.
Só detecta relações lineares
O \(r\) de Pearson mede apenas a associação linear. Uma relação não linear forte pode produzir \(r \approx 0\).
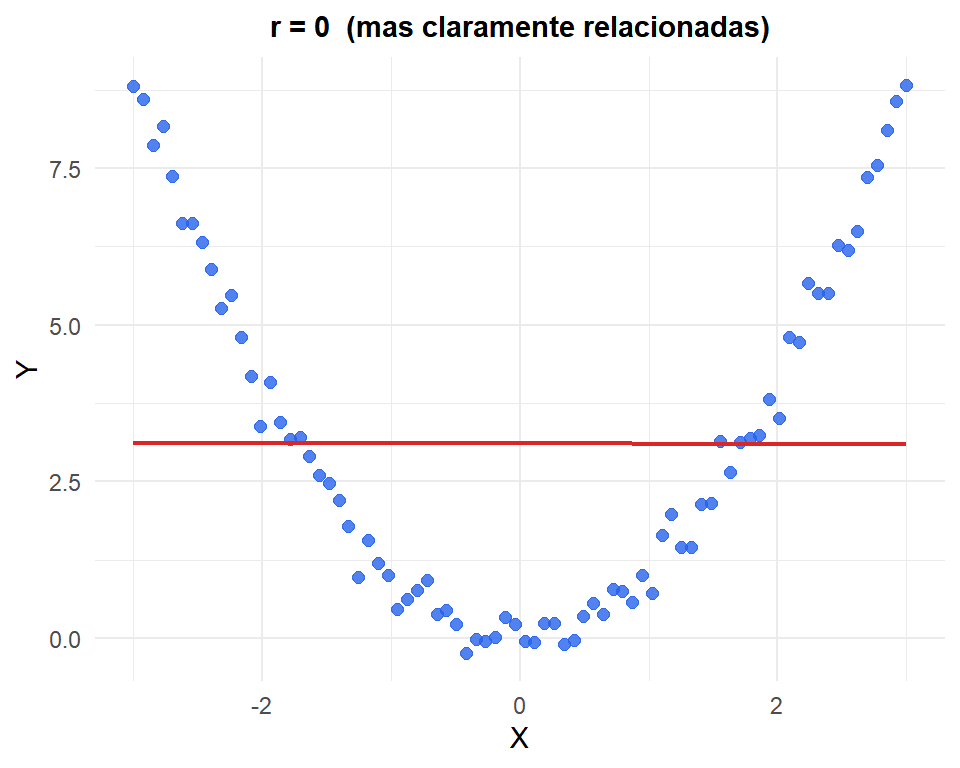
Figure 3: Uma relação quadrática perfeita dá r ≈ 0: o r de Pearson ignora completamente os padrões não lineares
Para relações não lineares, considere a correlação de postos de Spearman ou outras medidas não paramétricas.
Sensibilidade a outliers
Uma única observação extrema pode mudar drasticamente o valor de \(r\). Sempre inspecione o gráfico de dispersão antes de confiar no coeficiente de correlação.
⚠️ Sempre plote os dados antes de calcular r
Dois conjuntos de dados podem ter coeficientes de correlação quase idênticos, mas padrões de dispersão completamente diferentes. Isso é conhecido como o quarteto de Anscombe: quatro conjuntos de dados com (r \approx 0{,}82) que não se parecem nada entre si quando plotados. Calcular (r) sem olhar para os dados é um dos erros analíticos mais comuns.

