Otimização convexa
A otimização convexa é a classe de problemas em que tanto a função objetivo quanto o conjunto viável são convexos. Essa única propriedade tem uma consequência enorme: todo mínimo local é um mínimo global. Problemas convexos podem ser resolvidos de forma confiável e eficiente independentemente de seu tamanho, enquanto problemas não convexos são geralmente intratáveis no pior caso. Este post restringe o framework geral da nossa introdução à otimização a esse caso mais amigável e bem-comportado, que inclui a programação linear como caso especial em que tanto o objetivo quanto as restrições são lineares.
Conjuntos convexos
Um conjunto \(\mathcal{C} \subseteq \mathbb{R}^n\) é convexo se o segmento de reta entre quaisquer dois pontos de \(\mathcal{C}\) estiver inteiramente contido em \(\mathcal{C}\):
\[x, y \in \mathcal{C} \implies \theta x + (1-\theta)y \in \mathcal{C} \quad \forall \theta \in [0,1]\]
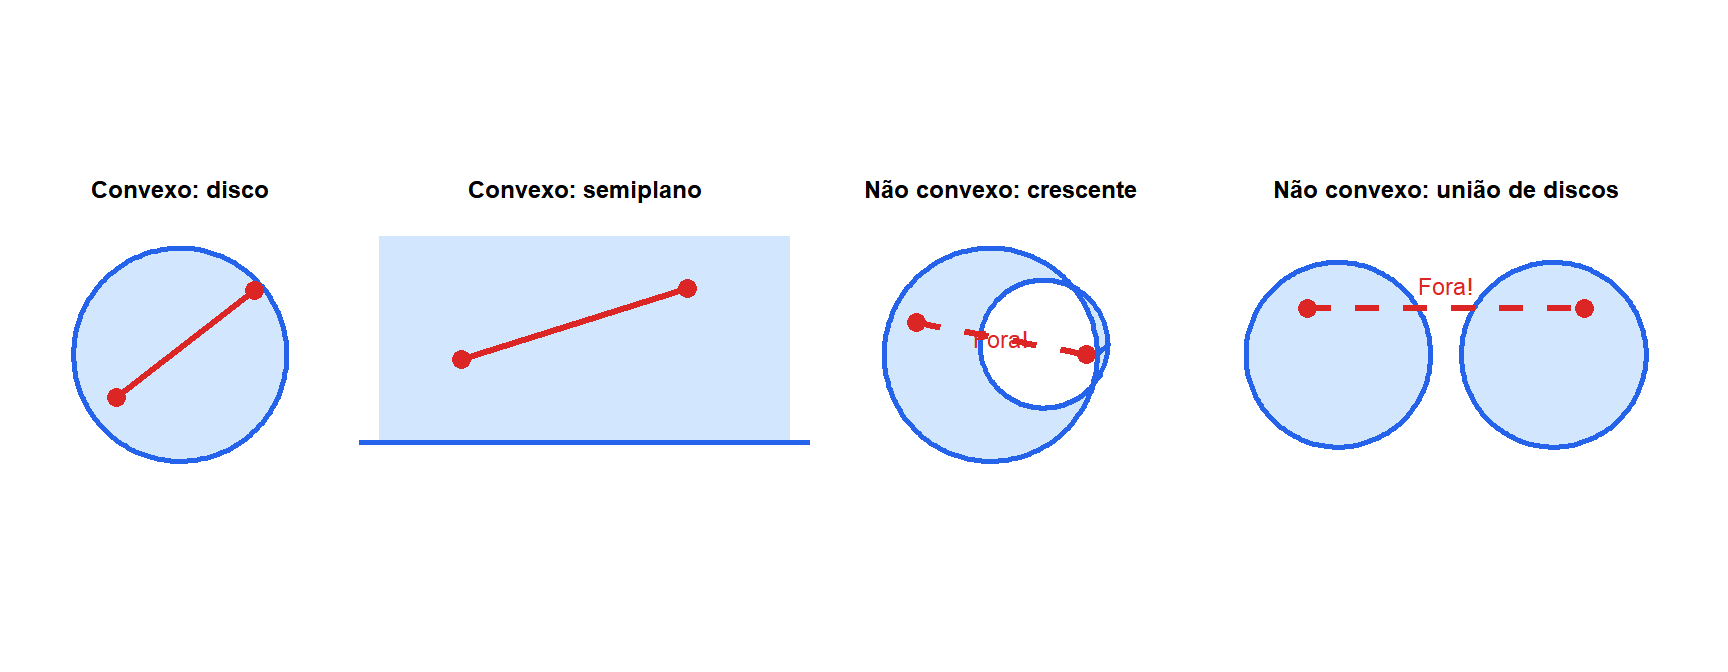
O segmento vermelho está inteiramente contido nos conjuntos convexos (disco, semiplano), mas sai dos não convexos (crescente, união de discos). Conjuntos convexos importantes: semiespaços, poliedros (interseções de semiespaços), bolas, elipsoides, cones.
Funções convexas
Uma função \(f: \mathbb{R}^n \to \mathbb{R}\) é convexa se seu domínio é convexo e:
\[f(\theta x + (1-\theta)y) \leq \theta f(x) + (1-\theta)f(y) \quad \forall x,y,\; \theta \in [0,1]\]
Geometricamente: a corda entre quaisquer dois pontos no gráfico está acima (ou sobre) o gráfico.
Para \(f\) duas vezes diferenciável: \(f\) é convexa sse \(\nabla^2 f(x) \succeq 0\) (Hessiana positiva semidefinida) em todo ponto.
Operações que preservam a convexidade: combinações lineares não negativas, máximo pontual, composição com funções afins. Isso permite construir funções convexas complexas a partir de outras simples.
Funções convexas comuns:
- Quadrática: \(f(x) = x^T Q x + b^T x\) com \(Q \succeq 0\).
- Exponencial: \(e^{ax}\) para qualquer \(a\).
- Potências: \(|x|^p\) para \(p \geq 1\); \(x^p\) para \(p \geq 1\) em \(x > 0\).
- Normas: \(\|x\|_p\) para \(p \geq 1\).
- Log-sum-exp: \(\log\sum_i e^{x_i}\) (aproximação suave do máximo).
- Entropia negativa: \(\sum_i x_i \log x_i\).
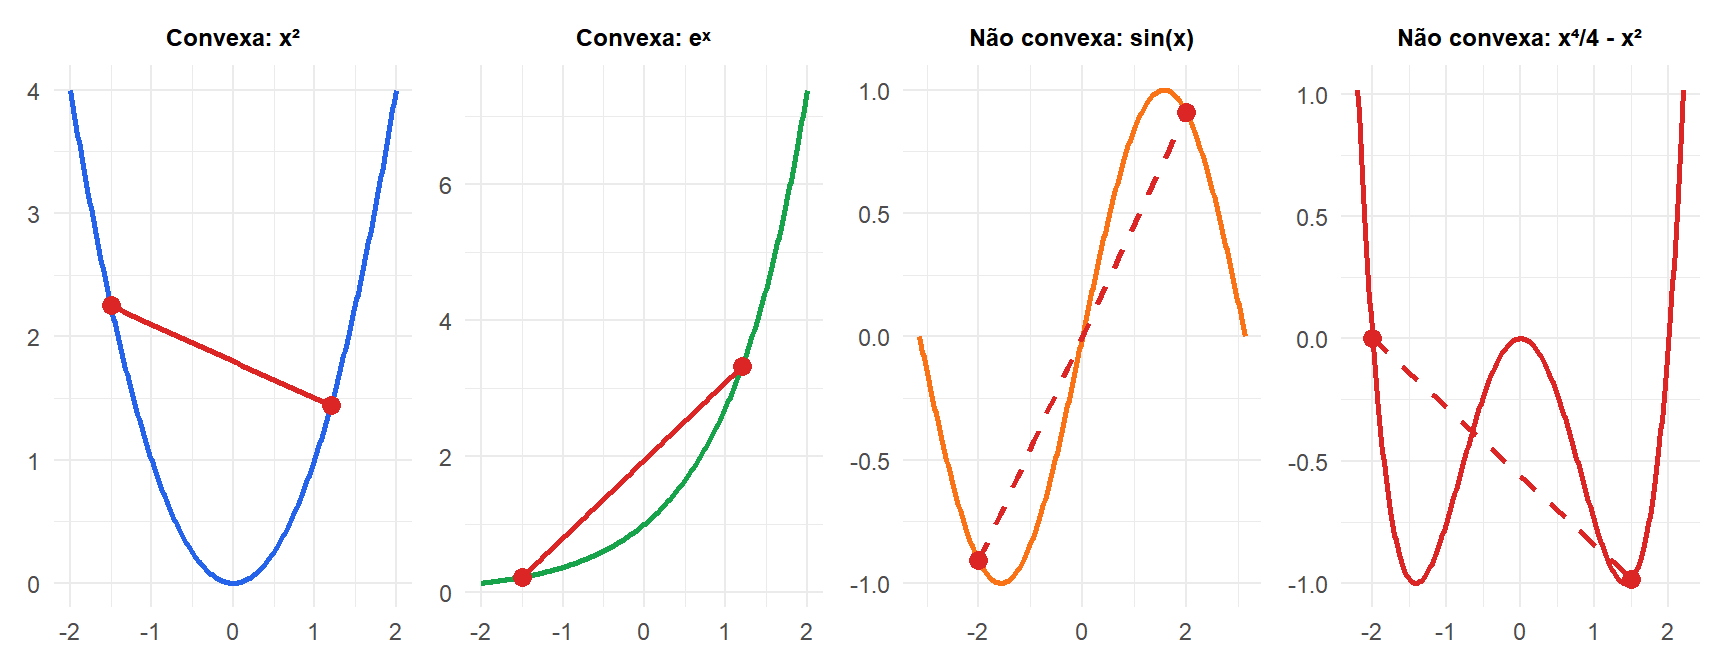
Para funções convexas (azul, verde) a corda está acima da curva. Para funções não convexas (laranja, vermelho) a corda cai abaixo: a definição é violada.
Problema padrão de otimização convexa
Todo problema convexo, não importa como foi originalmente formulado, pode ser escrito nesta forma canônica:
\[\min_{x} f_0(x) \quad \text{s.a.} \quad f_i(x) \leq 0,\; i=1,\ldots,m \quad Ax = b\]
em que \(f_0, f_1, \ldots, f_m\) são todas convexas e as restrições de igualdade são afins. O conjunto viável \(\{x : f_i(x) \leq 0,\; Ax = b\}\) é convexo (interseção de conjuntos convexos).
O teorema fundamental da otimização convexa: qualquer mínimo local de um problema convexo é um mínimo global. Se \(f_0\) é estritamente convexa, o mínimo global é único.
Essa é a propriedade que torna a otimização convexa tratável: não precisamos nos preocupar em ficar presos em mínimos locais. Qualquer algoritmo de descida encontrará o ótimo global.
Hierarquia das classes de problemas convexos
A otimização convexa abrange uma hierarquia de classes de problemas cada vez mais gerais, cada uma com solvers especializados:
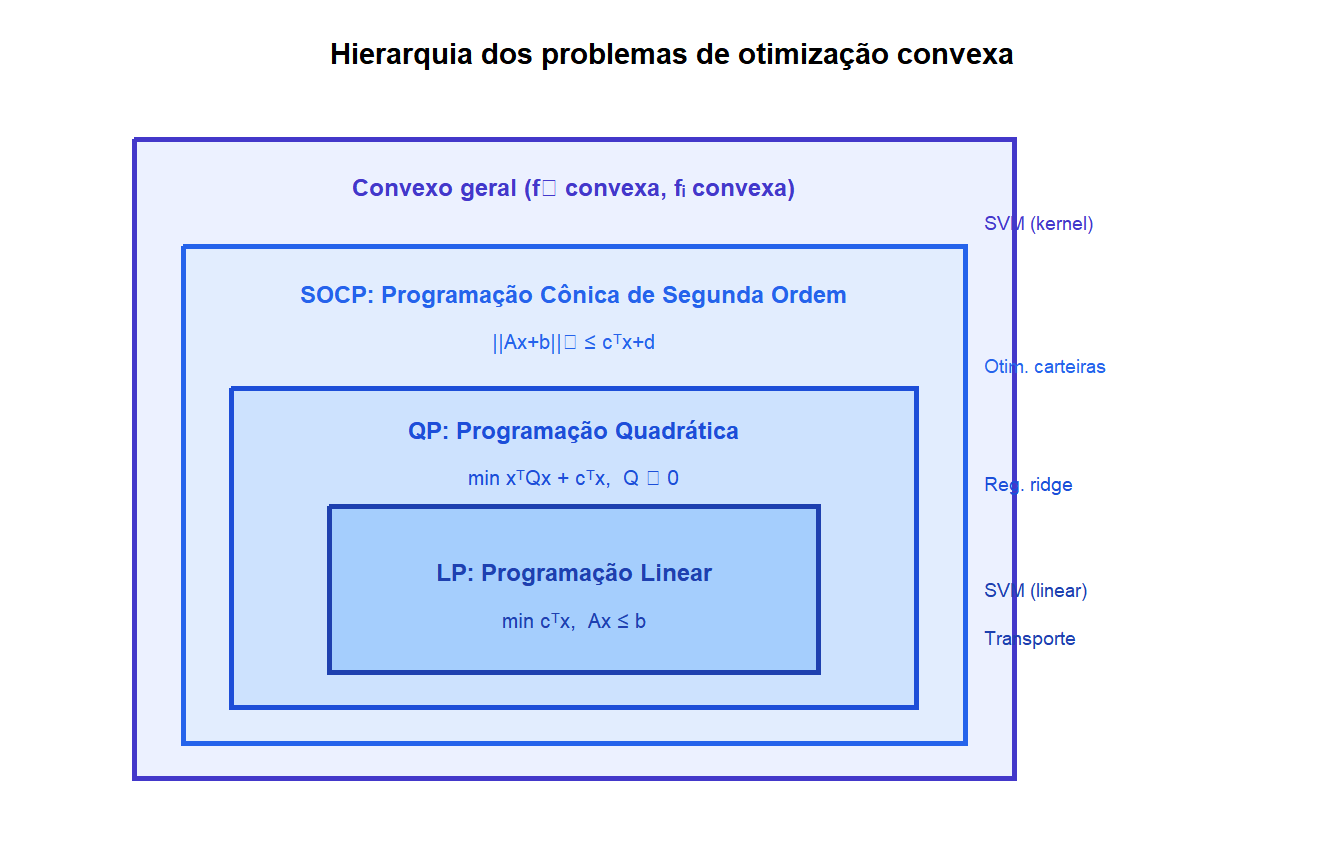
Cada classe é um caso especial da anterior. Existem solvers especializados para cada nível: o método Simplex para LP, conjunto ativo ou ponto interior para QP, solvers SOCP para restrições cônicas de segunda ordem.
Dualidade de Lagrange e dualidade forte
Para qualquer problema de otimização (convexo ou não), o problema dual de Lagrange é:
\[\max_{\lambda \geq 0,\, \nu} g(\lambda, \nu), \qquad g(\lambda, \nu) = \inf_x \mathcal{L}(x, \lambda, \nu) = \inf_x \left[f_0(x) + \sum_i \lambda_i f_i(x) + \nu^T(Ax-b)\right]\]
A função dual \(g(\lambda, \nu)\) é sempre côncava (mesmo que o primal seja não convexo) e fornece um limite inferior para o valor ótimo primal \(p^*\):
\[g(\lambda, \nu) \leq p^* \quad \forall \lambda \geq 0, \nu\]
A diferença \(p^* - g(\lambda^*, \nu^*)\) é o gap de dualidade.
Dualidade fraca: \(d^* \leq p^*\) sempre. Dualidade forte: \(d^* = p^*\) (gap zero). A dualidade forte vale para problemas convexos sob a condição de Slater: existe um ponto estritamente viável \(\hat{x}\) com \(f_i(\hat{x}) < 0\) para todas as restrições de desigualdade.
Sob dualidade forte, as condições KKT são necessárias e suficientes para a otimalidade. Resolver o dual às vezes é mais fácil do que o primal: o dual da SVM é um programa quadrático que leva naturalmente ao kernel trick e a soluções esparsas.
⚠️ A convexidade do problema, não apenas da função, é o que importa
Um objetivo convexo com restrições não convexas não produz um problema convexo. O conjunto viável também deve ser convexo. Restrições não convexas (por exemplo, \(\|x\|_0 \leq k\) para esparsidade, \(x \in \{0,1\}^n\) para programas inteiros) tornam o problema não convexo mesmo que \(f_0\) seja quadrática.
Situações comuns que quebram a convexidade apesar de um objetivo de aparência convexa:
- Restrições de igualdade que não são afins: \(\|x\| = 1\) (esfera).
- Restrições de cardinalidade: no máximo \(k\) entradas não nulas.
- Variáveis inteiras ou binárias.
- Restrições de posto (rank) em matrizes.
Para esses problemas, relaxações convexas (substituir variáveis inteiras por contínuas, substituir posto pela norma nuclear) frequentemente fornecem limites úteis ou soluções aproximadas.
Condições KKT para problemas convexos
Para problemas convexos que satisfazem a condição de Slater, as condições KKT são necessárias e suficientes para a otimalidade global. Um ponto \(x^*\) é o ótimo global se e somente se existirem \(\lambda^* \geq 0\) e \(\nu^*\) tais que:
- Viabilidade primal: \(f_i(x^*) \leq 0\), \(Ax^* = b\).
- Viabilidade dual: \(\lambda_i^* \geq 0\).
- Folga complementar: \(\lambda_i^* f_i(x^*) = 0\).
- Estacionariedade: \(\nabla f_0(x^*) + \sum_i \lambda_i^* \nabla f_i(x^*) + A^T\nu^* = 0\).
Esse é o resultado limpo das KKT: para problemas não convexos, KKT é apenas necessária. Para problemas convexos sob a condição de Slater, ela caracteriza completamente o ótimo global.
💡 Otimização convexa em R
library(CVXR)

# Lasso (L1-regularized least squares): convex but non-smooth
n <- 50; p <- 20
X <- matrix(rnorm(n*p), n, p)
y <- rnorm(n)
beta <- Variable(p)
lambda <- 0.1

prob <- Problem(Minimize(sum_squares(X %*% beta - y) + lambda*sum(abs(beta))))
solve(prob)
beta$value

# Portfolio optimization: minimize variance subject to return constraint
w <- Variable(p, nonneg=TRUE)           # weights >= 0
Sigma <- cov(matrix(rnorm(n*p), n, p)) # covariance matrix
mu <- rnorm(p, 0.05, 0.02)             # expected returns
target_return <- 0.04

prob <- Problem(Minimize(quad_form(w, Sigma)),
                list(sum(w) == 1,
                     t(mu) %*% w >= target_return))
solve(prob)

# Linear program
c_obj <- c(5, 4)
A_mat <- rbind(c(1,2), c(2,1))
b_rhs <- c(8, 10)
x <- Variable(2, nonneg=TRUE)
prob <- Problem(Maximize(t(c_obj) %*% x),
                list(A_mat %*% x <= b_rhs))
solve(prob)
O CVXR verifica automaticamente se os problemas são convexos (usando regras de programação convexa disciplinada) e chama o solver apropriado (ECOS, SCS, MOSEK).

