Introdução à otimização
A otimização matemática busca os valores das variáveis de decisão que minimizam ou maximizam uma função objetivo, possivelmente sujeita a restrições. Ela é a base do machine learning, da pesquisa operacional, da economia, e do design em engenharia.
O problema de otimização
A forma geral de um problema de otimização é:
\[\min_{x \in \mathcal{X}} f(x) \quad \text{sujeito a} \quad g_i(x) \leq 0,\; i=1,\ldots,m \quad h_j(x) = 0,\; j=1,\ldots,p\]
em que:
- \(x \in \mathbb{R}^n\): variáveis de decisão (o que controlamos).
- \(f: \mathbb{R}^n \to \mathbb{R}\): função objetivo (o que otimizamos).
- \(g_i(x) \leq 0\): restrições de desigualdade (fronteira da região viável).
- \(h_j(x) = 0\): restrições de igualdade (devem ser satisfeitas exatamente).
- \(\mathcal{X}\): conjunto viável (todos os \(x\) que satisfazem as restrições).
Um problema de maximização \(\max f(x)\) é equivalente a \(\min -f(x)\).
Exemplos em diferentes áreas:
- Machine learning: minimizar a função de perda \(f(\theta) = \frac{1}{n}\sum_i \ell(y_i, \hat{y}_i(\theta))\) sobre os parâmetros do modelo \(\theta\).
- Otimização de carteiras: maximizar o retorno esperado sujeito a uma restrição de variância.
- Planejamento de rotas: minimizar o tempo de deslocamento sujeito às restrições da rede rodoviária.
- Planejamento de produção: maximizar o lucro sujeito a restrições de capacidade de recursos.
Taxonomia dos problemas de otimização
Contínuo vs discreto
- Contínuo: \(x \in \mathbb{R}^n\). Métodos baseados em gradiente se aplicam. Exemplos: treinamento de redes neurais, regressão.
- Discreto (combinatório): \(x \in \mathbb{Z}^n\) ou \(x \in \{0,1\}^n\). Muito mais difícil em geral. Exemplos: escalonamento, roteamento, programação inteira.
- Misto-inteiro: algumas variáveis contínuas, outras discretas.
Com restrições vs sem restrições
- Sem restrições: \(\mathcal{X} = \mathbb{R}^n\). A otimalidade é caracterizada puramente por derivadas.
- Com restrições: o conjunto viável é um subconjunto próprio de \(\mathbb{R}^n\). Exige multiplicadores de Lagrange ou condições KKT.
Convexo vs não convexo
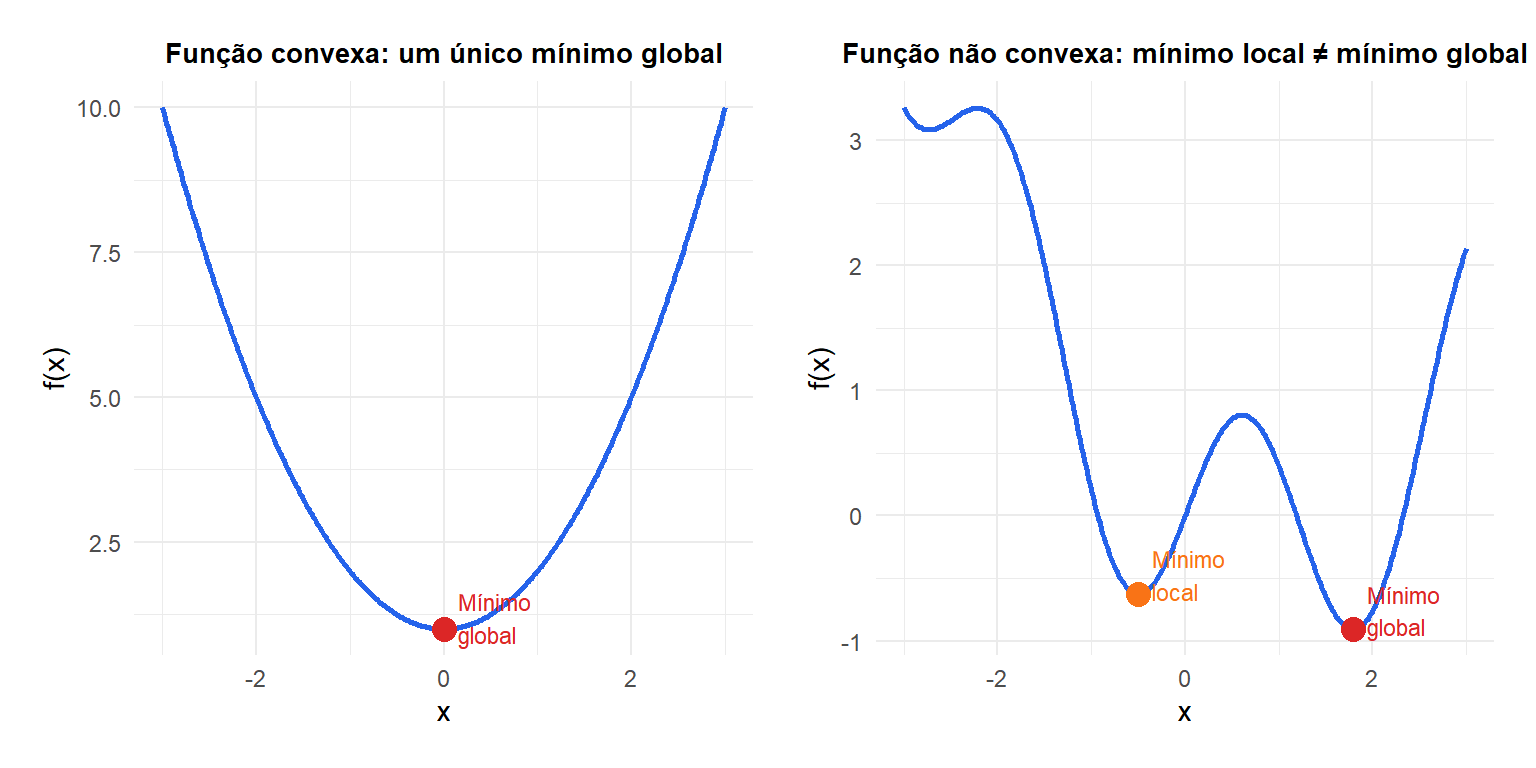
A distinção mais importante na prática:
- Convexo: \(f\) é convexa e \(\mathcal{X}\) é um conjunto convexo. Todo mínimo local é um mínimo global. Existem algoritmos eficientes com garantias de convergência.
- Não convexo: múltiplos mínimos locais são possíveis. Nenhuma garantia de que algum algoritmo encontre o mínimo global. A maioria dos problemas de deep learning é não convexa.
Condições de otimalidade
Condição necessária de primeira ordem (sem restrições)
Se \(x^*\) é um mínimo local de uma função diferenciável \(f\), então:
\[\nabla f(x^*) = \mathbf{0}\]
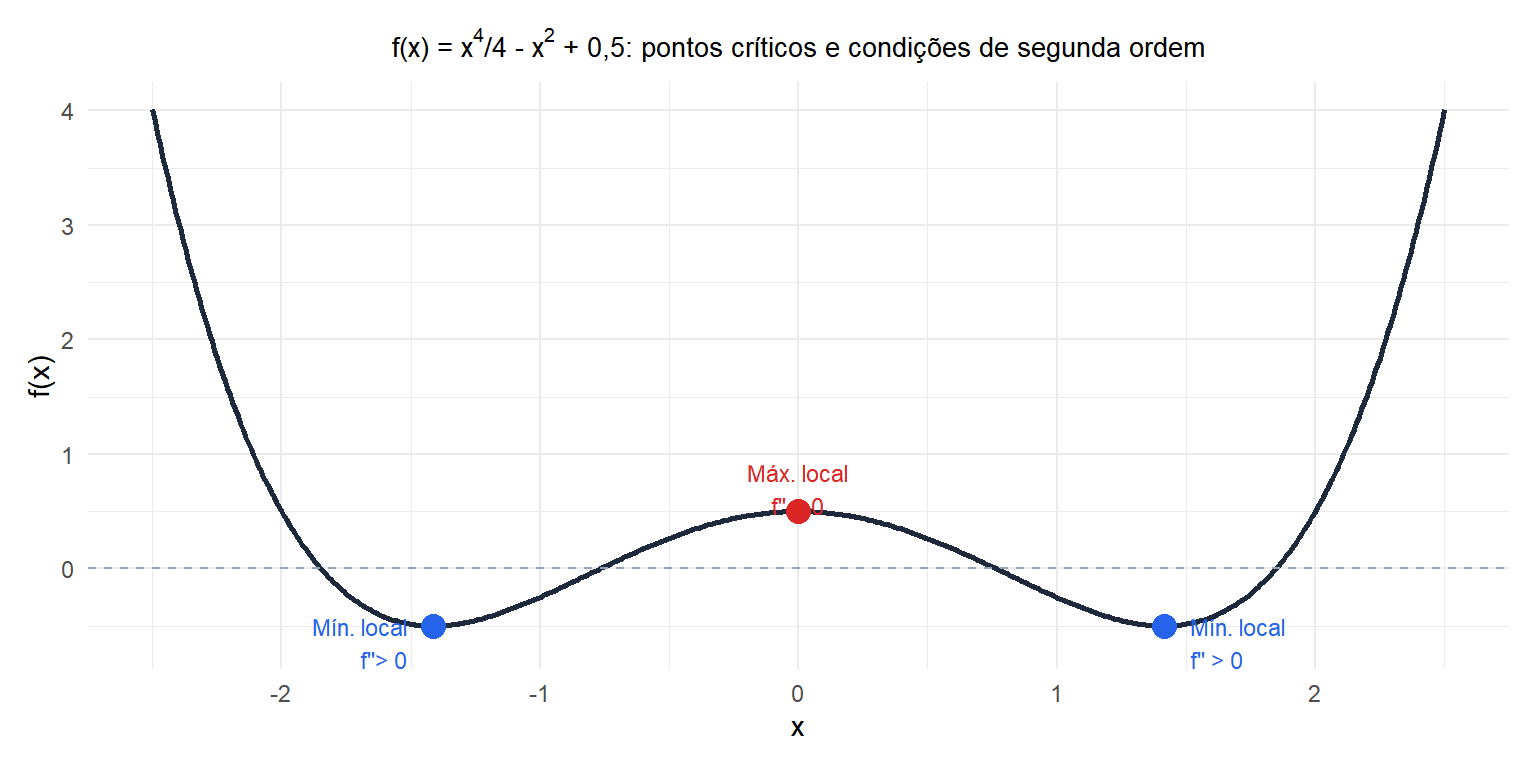
Pontos em que \(\nabla f = 0\) são chamados de pontos estacionários ou pontos críticos. Eles incluem mínimos, máximos, e pontos de sela.
Condições de segunda ordem (sem restrições)
Em um ponto estacionário \(x^*\):
| Hessiana \(\nabla^2 f(x^*)\) | Tipo de ponto crítico |
|---|---|
| Positiva definida | Mínimo local |
| Negativa definida | Máximo local |
| Indefinida | Ponto de sela |
| Positiva semidefinida | Não é possível determinar (precisa de análise de ordem superior) |
Para uma função de uma variável: \(f''(x^*) > 0\) implica mínimo local; \(f''(x^*) < 0\) implica máximo local.
Otimalidade com restrições: Lagrange e KKT
Para problemas com restrições, o gradiente de \(f\) no ótimo não é necessariamente zero. Em vez disso, ele deve poder ser expresso como uma combinação linear dos gradientes das restrições.
Para problemas com restrições de igualdade apenas (\(h_j(x) = 0\)), as condições de Lagrange exigem:
\[\nabla f(x^*) + \sum_j \lambda_j \nabla h_j(x^*) = \mathbf{0}\]
Para problemas com restrições de igualdade e desigualdade, as condições KKT (Karush-Kuhn-Tucker) generalizam isso, adicionando condições de folga complementar para as restrições de desigualdade. Elas são tratadas em detalhe nos posts sobre multiplicadores de Lagrange e KKT.
Visão geral dos métodos de resolução
| Método | Tipo de problema | Ideia-chave |
|---|---|---|
| Simplex | Programação linear | Mover-se ao longo dos vértices do politopo viável |
| Descida do gradiente | Sem restrições, diferenciável | Seguir o gradiente negativo |
| Método de Newton | Sem restrições, duas vezes diferenciável | Usar a Hessiana para dar passos curvos |
| BFGS / L-BFGS | Sem restrições, larga escala | Aproximar a Hessiana eficientemente |
| Multiplicadores de Lagrange | Com restrições de igualdade | Aumentar o objetivo com penalidades de restrição |
| Ponto interior | Convexo, com restrições | Permanecer dentro da região viável |
| Dijkstra | Caminho mais curto em grafos | Expansão gulosa do nó mais próximo |
| Recozimento simulado | Não convexo, combinatório | Aceitar soluções piores probabilisticamente |
⚠️ Métodos locais podem ficar presos em mínimos locais
Métodos baseados em gradiente (descida do gradiente, método de Newton, BFGS) convergem para um mínimo local, não necessariamente o global. Para problemas não convexos, isso é uma limitação fundamental:
- Problemas convexos: qualquer mínimo local é global. Use métodos baseados em gradiente com confiança.
- Problemas não convexos (redes neurais, otimização combinatória): métodos locais podem encontrar soluções ruins. Estratégias incluem múltiplos reinícios aleatórios, métodos estocásticos, ou heurísticas de otimização global (recozimento simulado, algoritmos genéticos).
Na prática, muitos problemas não convexos em machine learning têm bom comportamento empírico: pontos de sela dominam sobre mínimos locais, e a maioria dos mínimos locais têm valores objetivo semelhantes.
💡 Escolhendo o método de otimização certo
Perguntas-chave antes de selecionar um método:
- O problema é convexo? Se sim, qualquer solver local encontra o ótimo global.
- \(f\) é diferenciável? Métodos baseados em gradiente exigem pelo menos derivadas primeiras.
- Quantas variáveis? Problemas de larga escala (\(n > 10^4\)) precisam de métodos que evitem armazenar a Hessiana (L-BFGS, SGD).
- Existem restrições? Apenas igualdade → Lagrange. Também desigualdade → KKT, ponto interior, ou métodos de penalidade.
- O problema é combinatório? Use programação inteira, programação dinâmica, ou metaheurísticas.

