Probabilidade condicional
A probabilidade condicional responde à pergunta: dado que sabemos que \(B\) ocorreu, como isso muda a probabilidade de \(A\)? É a base do raciocínio bayesiano, dos testes médicos, dos filtros de spam e de qualquer situação em que uma nova informação atualiza nossa incerteza.
Definição
A probabilidade condicional de \(A\) dado \(B\) é a probabilidade de que \(A\) ocorra, restrita aos casos em que \(B\) já ocorreu:
\[P(A \mid B) = \frac{P(A \cap B)}{P(B)}, \quad P(B) > 0\]
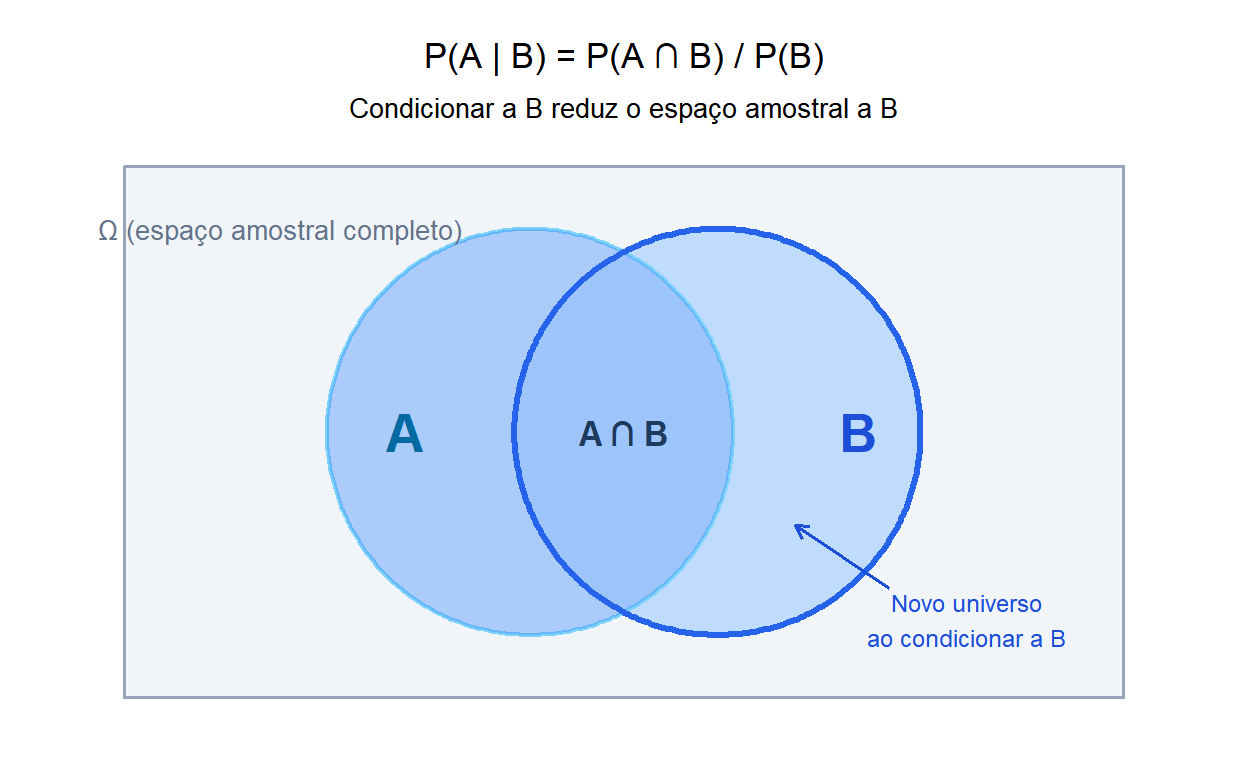
Geometricamente, condicionar a \(B\) significa reduzir o espaço amostral a \(B\) e perguntar que fração de \(B\) também está em \(A\). A fórmula divide a sobreposição \(P(A \cap B)\) pelo novo “universo” \(P(B)\).
A partir dessa definição, a regra da multiplicação segue imediatamente:
\[P(A \cap B) = P(A \mid B) \cdot P(B) = P(B \mid A) \cdot P(A)\]
⚠️ P(A|B) ≠ P(B|A): a assimetria mais importante em probabilidade
\(P(A \mid B)\) e \(P(B \mid A)\) são grandezas completamente diferentes. Confundi-las tem consequências graves:
- \(P(\text{teste positivo} \mid \text{tem a doença})\) é a sensibilidade do teste, o que o laboratório relata.
- \(P(\text{tem a doença} \mid \text{teste positivo})\) é o que o paciente quer saber, e depende criticamente de quão rara é a doença.
No contexto jurídico, isso é chamado de falácia do promotor: confundir \(P(\text{evidência} \mid \text{inocente})\) com \(P(\text{inocente} \mid \text{evidência})\). Várias condenações injustas já foram associadas a esse erro.
Lei da probabilidade total
Para calcular \(P(B)\) no denominador da fórmula de probabilidade condicional, muitas vezes precisamos considerar todas as formas pelas quais \(B\) pode ocorrer. Se \(A_1, A_2, \ldots, A_n\) formam uma partição do espaço amostral (mutuamente exclusivos e exaustivos), então:
\[P(B) = \sum_{i=1}^{n} P(B \mid A_i) \cdot P(A_i)\]
Essa é a lei da probabilidade total. Ela decompõe \(P(B)\) nas contribuições de cada cenário \(A_i\).
Uma fábrica tem três linhas de produção que contribuem com 50%, 30% e 20% da produção. Suas taxas de defeito são 2%, 4% e 6%, respectivamente. Qual é a taxa de defeitos geral?
\[P(\text{defeito}) = 0{,}02 \times 0{,}50 + 0{,}04 \times 0{,}30 + 0{,}06 \times 0{,}20\] \[= 0{,}010 + 0{,}012 + 0{,}012 = 0{,}034\]
A taxa de defeitos geral é de 3,4%.

Exemplos passo a passo
Exemplo 1: teste médico (cálculo completo)
Uma doença afeta 1% da população (\(P(D) = 0{,}01\)). Um teste diagnóstico tem:
- Sensibilidade: \(P(\text{pos} \mid D) = 0{,}95\) (detecta 95% dos casos verdadeiros).
- Taxa de falsos positivos: \(P(\text{pos} \mid D^c) = 0{,}05\) (sinaliza 5% das pessoas saudáveis).
Um paciente testa positivo. Qual é a probabilidade de que ele tenha a doença?
Passo 1: calcule \(P(\text{pos})\) usando a lei da probabilidade total:
\[P(\text{pos}) = P(\text{pos} \mid D) \cdot P(D) + P(\text{pos} \mid D^c) \cdot P(D^c)\] \[= 0{,}95 \times 0{,}01 + 0{,}05 \times 0{,}99 = 0{,}0095 + 0{,}0495 = 0{,}059\]
Passo 2: aplique a fórmula da probabilidade condicional:
\[P(D \mid \text{pos}) = \frac{P(\text{pos} \mid D) \cdot P(D)}{P(\text{pos})} = \frac{0{,}0095}{0{,}059} \approx 0{,}161\]
Apenas 16% das pessoas que testam positivo realmente têm a doença. O teste é preciso, mas a doença é rara o suficiente para que a maioria dos resultados positivos sejam alarmes falsos. Esse é o efeito da taxa base: a probabilidade a priori de ter a doença (\(P(D) = 0{,}01\)) domina o resultado.
Em vez de probabilidades, pense em 10.000 pessoas:
- 100 têm a doença. Dessas, \(95\) testam positivo (verdadeiros positivos).
- 9.900 são saudáveis. Dessas, \(495\) testam positivo (falsos positivos).
Total de positivos: \(95 + 495 = 590\).
\(P(D \mid \text{pos}) = 95/590 \approx 0{,}161\). Mesma resposta, muito mais intuitiva.
Essa abordagem de frequências naturais é recomendada por estatísticos ao comunicar riscos a pacientes ou formuladores de políticas.
Exemplo 2: processo seletivo sequencial
O processo seletivo de uma empresa tem duas etapas. Dados históricos mostram:
- 40% dos candidatos passam da primeira entrevista: \(P(S_1) = 0{,}40\).
- Desses, 35% passam da segunda entrevista: \(P(S_2 \mid S_1) = 0{,}35\).
Probabilidade de passar das duas:
\[P(S_1 \cap S_2) = P(S_2 \mid S_1) \cdot P(S_1) = 0{,}35 \times 0{,}40 = 0{,}14\]
14% dos candidatos passam pelas duas etapas.
Agora suponha que saibamos que um candidato passou da segunda entrevista. Qual é a probabilidade de que ele também tenha passado da primeira? (Ele necessariamente passou, já que a etapa 2 exige a etapa 1.)
\[P(S_1 \mid S_2) = \frac{P(S_1 \cap S_2)}{P(S_2)}\]
Precisamos de \(P(S_2)\). Como não é possível chegar à etapa 2 sem passar pela etapa 1: \(P(S_2) = P(S_1 \cap S_2) = 0{,}14\).
\[P(S_1 \mid S_2) = \frac{0{,}14}{0{,}14} = 1\]
Como esperado: se você passou da etapa 2, necessariamente passou da etapa 1.
Exemplo 3: filtro de spam
Um filtro de spam analisa a palavra “grátis” nos e-mails:
- 60% dos e-mails de spam contêm “grátis”: \(P(\text{grátis} \mid \text{spam}) = 0{,}60\).
- 5% dos e-mails legítimos contêm “grátis”: \(P(\text{grátis} \mid \text{legítimo}) = 0{,}05\).
- 30% dos e-mails recebidos são spam: \(P(\text{spam}) = 0{,}30\).
Chega um e-mail contendo “grátis”. Qual é a probabilidade de que seja spam?
\[P(\text{grátis}) = 0{,}60 \times 0{,}30 + 0{,}05 \times 0{,}70 = 0{,}180 + 0{,}035 = 0{,}215\]
\[P(\text{spam} \mid \text{grátis}) = \frac{0{,}60 \times 0{,}30}{0{,}215} = \frac{0{,}18}{0{,}215} \approx 0{,}837\]
84% de probabilidade de spam dado que contém a palavra “grátis”. Filtros de spam reais aplicam essa lógica a centenas de palavras simultaneamente usando a classificação Naive Bayes.
Conexão com a independência
Os eventos \(A\) e \(B\) são independentes se e somente se:
\[P(A \mid B) = P(A)\]
Ou seja, saber que \(B\) ocorreu não muda a probabilidade de \(A\). Quando isso vale, a fórmula da probabilidade condicional dá \(P(A \cap B) = P(A) \cdot P(B)\), que é a definição de independência.
A probabilidade condicional é, portanto, o caso geral: a independência é o caso especial em que condicionar não tem efeito. As cadeias de Markov se constroem diretamente sobre essa ideia, restringindo esse condicionamento a depender apenas do estado mais recente.
💡 A probabilidade condicional muda o espaço amostral
A intuição-chave: condicionar a \(B\) substitui o espaço amostral original \(\Omega\) pelo espaço restrito \(B\). Todas as probabilidades são então recalculadas dentro desse universo menor. É por isso que \(P(A \mid B)\) pode ser muito diferente de \(P(A)\): estamos fazendo uma pergunta completamente diferente. Não “com que frequência \(A\) acontece?”, mas “entre os casos em que \(B\) aconteceu, com que frequência \(A\) também acontece?”

