Teorema de Bayes
O teorema de Bayes diz como atualizar uma probabilidade quando uma nova evidência chega. Ele conecta o que você já sabia (a priori) com o que os dados dizem (a verossimilhança) para produzir uma crença atualizada (a posteriori). É a base matemática do raciocínio racional sob incerteza.
Definição
Para dois eventos \(A\) e \(B\) com \(P(B) > 0\):
\[P(A \mid B) = \frac{P(B \mid A) \cdot P(A)}{P(B)}\]
Cada componente tem um nome e um papel:
| Termo | Notação | Significado |
|---|---|---|
| A priori | \(P(A)\) | Probabilidade de \(A\) antes de observar \(B\) |
| Verossimilhança | \(P(B \mid A)\) | Probabilidade de observar \(B\) se \(A\) for verdadeiro |
| A posteriori | \(P(A \mid B)\) | Probabilidade atualizada de \(A\) após observar \(B\) |
| Verossimilhança marginal | \(P(B)\) | Probabilidade total de observar \(B\) (constante normalizadora) |
Quando o espaço de hipóteses tem múltiplas alternativas \(A_1, \ldots, A_n\) formando uma partição, o denominador se expande por meio da lei da probabilidade total:
\[P(A_i \mid B) = \frac{P(B \mid A_i) \cdot P(A_i)}{\displaystyle\sum_{j=1}^{n} P(B \mid A_j) \cdot P(A_j)}\]
Atualização bayesiana: da priori à posteriori
A ideia-chave do teorema de Bayes é que ele descreve um processo de atualização de crenças. Você começa com uma priori, observa evidências e chega a uma posteriori. A posteriori de uma observação se torna a priori da próxima.
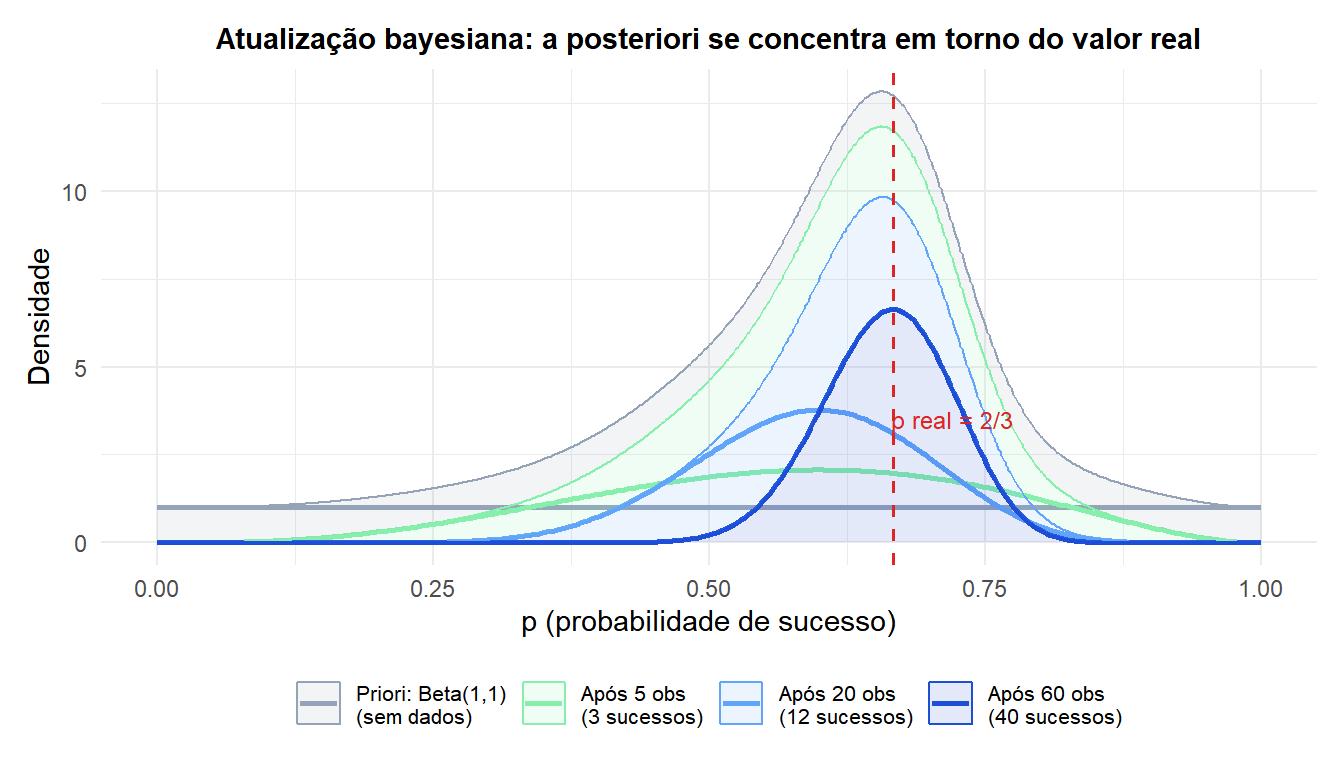
Com uma priori uniforme (todos os valores de \(p\) igualmente plausíveis), cada lote de observações desloca e estreita a posteriori. Após 60 observações, a distribução está fortemente concentrada em torno do valor real de \(2/3\).
Exemplos passo a passo
Exemplo 1: diagnóstico médico
Uma doença rara afeta 0,5% da população. Um teste de triagem tem:
- Sensibilidade: \(P(+ \mid D) = 0{,}92\)
- Taxa de falsos positivos: \(P(+ \mid D^c) = 0{,}04\)
Um paciente testa positivo. Qual é a probabilidade de que ele tenha a doença?
Priori: \(P(D) = 0{,}005\), \(P(D^c) = 0{,}995\)
Verossimilhança marginal por meio da lei da probabilidade total:
\[P(+) = 0{,}92 \times 0{,}005 + 0{,}04 \times 0{,}995 = 0{,}0046 + 0{,}0398 = 0{,}0444\]
Posteriori:
\[P(D \mid +) = \frac{0{,}92 \times 0{,}005}{0{,}0444} = \frac{0{,}0046}{0{,}0444} \approx 0{,}104\]
Apenas 10,4% das pessoas que testam positivo realmente têm a doença. O teste é bastante preciso, mas a doença é tão rara que os falsos positivos predominam.
De 10.000 pessoas:
- 50 têm a doença. Dessas, \(50 \times 0{,}92 = 46\) testam positivo (verdadeiros positivos).
- 9.950 são saudáveis. Dessas, \(9950 \times 0{,}04 = 398\) testam positivo (falsos positivos).
Total de positivos: \(46 + 398 = 444\).
\[P(D \mid +) = \frac{46}{444} \approx 0{,}104 \checkmark\]
As frequências naturais tornam o resultado intuitivo: de 444 testes positivos, apenas 46 são casos reais.

Exemplo 2: filtro de spam com várias palavras
Um filtro de spam parte da priori \(P(\text{spam}) = 0{,}30\). A palavra “urgente” aparece em:
- 45% dos e-mails de spam: \(P(\text{urgente} \mid \text{spam}) = 0{,}45\)
- 3% dos e-mails legítimos: \(P(\text{urgente} \mid \text{legítimo}) = 0{,}03\)
Após observar “urgente”:
\[P(\text{urgente}) = 0{,}45 \times 0{,}30 + 0{,}03 \times 0{,}70 = 0{,}135 + 0{,}021 = 0{,}156\]
\[P(\text{spam} \mid \text{urgente}) = \frac{0{,}45 \times 0{,}30}{0{,}156} \approx 0{,}865\]
A posteriori (86,5%) se torna a nova priori para a próxima palavra. Se o e-mail também contém “ganhador”:
- \(P(\text{ganhador} \mid \text{spam}) = 0{,}60\), \(P(\text{ganhador} \mid \text{legítimo}) = 0{,}01\)
\[P(\text{spam} \mid \text{urgente, ganhador}) = \frac{0{,}60 \times 0{,}865}{0{,}60 \times 0{,}865 + 0{,}01 \times 0{,}135} \approx \frac{0{,}519}{0{,}519 + 0{,}00135} \approx 0{,}997\]
Quase certeza de spam após apenas duas palavras suspeitas. Essa atualização sequencial é o núcleo dos classificadores Naive Bayes.
Exemplo 3: três hipóteses concorrentes
Um analista de qualidade encontra um componente defeituoso. Ele veio de um de três fornecedores:
- O fornecedor X fornece 50% das peças, com taxa de defeito de 2%.
- O fornecedor Y fornece 30%, com taxa de defeito de 5%.
- O fornecedor Z fornece 20%, com taxa de defeito de 8%.
Prioris: \(P(X) = 0{,}50\), \(P(Y) = 0{,}30\), \(P(Z) = 0{,}20\)
Verossimilhança marginal:
\[P(\text{defeito}) = 0{,}02 \times 0{,}50 + 0{,}05 \times 0{,}30 + 0{,}08 \times 0{,}20 = 0{,}010 + 0{,}015 + 0{,}016 = 0{,}041\]
Posterioris:
\[P(X \mid \text{defeito}) = \frac{0{,}02 \times 0{,}50}{0{,}041} \approx 0{,}244\]
\[P(Y \mid \text{defeito}) = \frac{0{,}05 \times 0{,}30}{0{,}041} \approx 0{,}366\]
\[P(Z \mid \text{defeito}) = \frac{0{,}08 \times 0{,}20}{0{,}041} \approx 0{,}390\]
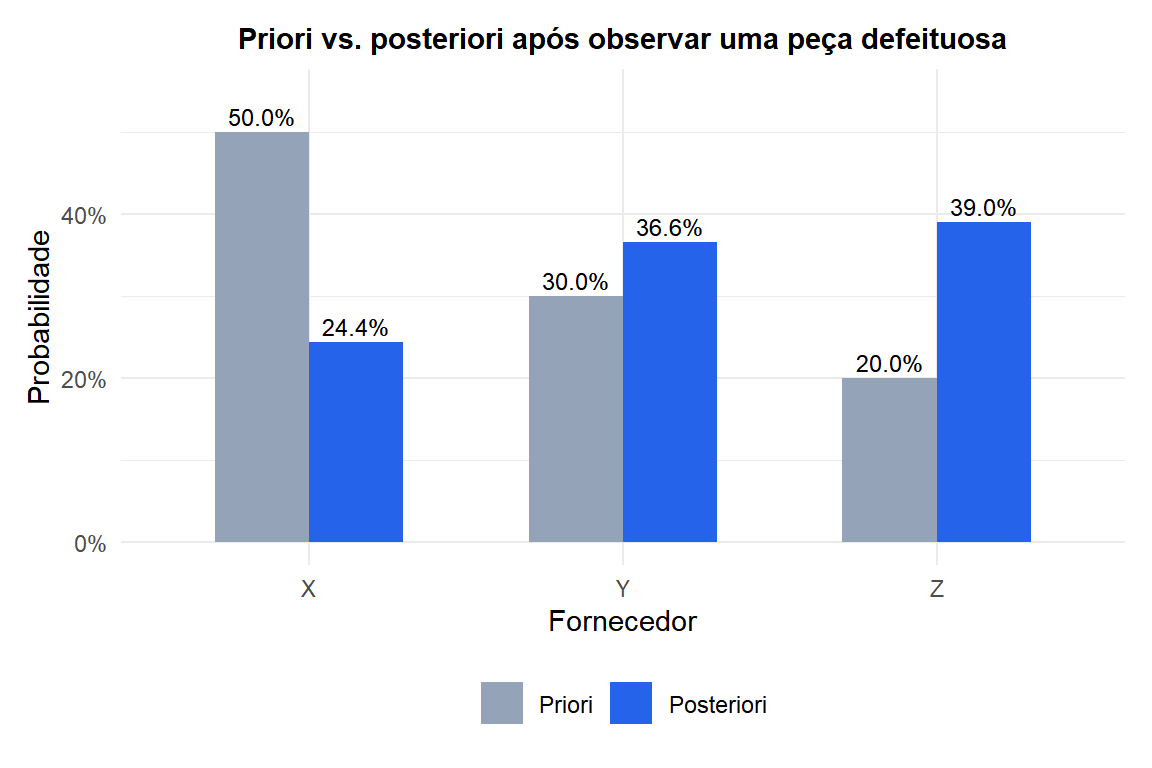
O fornecedor Z salta de 20% na priori para 39% na posteriori: mesmo fornecendo a menor quantidade de peças, sua alta taxa de defeito o torna a origem mais provável de qualquer defeito observado.
A falácia do promotor
Essa é uma das confusões mais consequentes na aplicação do teorema de Bayes, e aparece repetidamente em tribunais.
⚠️ P(evidência | inocente) não é P(inocente | evidência)
A falácia do promotor consiste em confundir a verossimilhança \(P(E \mid H)\) com a posteriori \(P(H \mid E)\). Um exemplo clássico:
- A evidência de DNA corresponde ao suspeito com probabilidade \(P(\text{correspondência} \mid \text{inocente}) = 1/1.000.000\).
- Um promotor afirma: “Há apenas 1 chance em um milhão de que o suspeito seja inocente.”
Isso está errado. \(P(\text{correspondência} \mid \text{inocente})\) não é \(P(\text{inocente} \mid \text{correspondência})\). O cálculo correto exige a probabilidade a priori de que o suspeito seja culpado, o tamanho da população e a probabilidade de uma correspondência coincidente. Em uma cidade de 1 milhão de habitantes, seria de esperar que uma pessoa inocente também correspondesse ao perfil de DNA. A probabilidade a posteriori de inocência dada a correspondência poderia ser de 50%, não de 1 em um milhão.
Esse erro já contribuiu para condenações injustas. O teorema de Bayes é a ferramenta correta para avaliar evidências forenses.
Interpretação frequentista vs. bayesiana
O teorema de Bayes em si é matematicamente incontestável: ele decorre diretamente da definição de probabilidade condicional. O debate é sobre como usá-lo:
- Os frequentistas aceitam o teorema de Bayes como regra de probabilidade, mas rejeitam a ideia de atribuir probabilidades a priori a hipóteses (que eles veem como fixas, não aleatórias). Eles o usam apenas quando \(A\) é um evento aleatório com uma frequência bem definida.
- Os bayesianos usam o teorema de Bayes como a regra geral para atualizar qualquer grau de crença, incluindo crenças sobre parâmetros fixos, mas desconhecidos. A priori codifica o conhecimento ou as suposições existentes, e a posteriori resume o que se sabe após ver os dados.
Na prática, métodos bayesianos são usados em machine learning (Naive Bayes, redes bayesianas), design de ensaios clínicos, testes A/B e qualquer área em que incorporar conhecimento prévio seja valioso.
💡 A receita de três passos para aplicar o teorema de Bayes
Toda aplicação do teorema de Bayes segue a mesma estrutura:
- Estabeleça a priori \(P(A)\): o que você acredita antes de ver a evidência?
- Especifique a verossimilhança \(P(B \mid A)\): quão provável é a evidência sob cada hipótese?
- Calcule a verossimilhança marginal \(P(B)\) usando a lei da probabilidade total.
- Aplique o teorema de Bayes para obter a posteriori \(P(A \mid B)\).
A posteriori responde à pergunta que realmente importa. A verossimilhança responde à pergunta inversa, que costuma ser mais fácil de medir (um laboratório pode medir a sensibilidade do teste; um paciente quer saber seu risco).

