Bootstrap paramétrico
O bootstrap paramétrico assume que os dados vêm de uma família distribucional específica (normal, exponencial, Poisson etc.), ajusta essa distribuição aos dados e gera amostras bootstrap simulando a partir do modelo ajustado. Quando o modelo está corretamente especificado, é mais eficiente do que o bootstrap não paramétrico. Quando o modelo está errado, os resultados podem ser enganosos.
Algoritmo
Dada uma amostra original \(\mathbf{x} = (x_1, \ldots, x_n)\) e uma família paramétrica assumida \(F_\theta\):
- Ajuste o modelo: estime \(\hat{\theta}\) a partir dos dados, normalmente por máxima verossimilhança.
- Simule: gere \(B\) amostras bootstrap de tamanho \(n\) extraindo de \(F_{\hat{\theta}}\).
- Reajuste: para cada amostra bootstrap \(\mathbf{x}^*_b\), reestime \(\hat{\theta}^*_b\).
- Resuma: use a distribuição de \(\hat{\theta}^*_b\) para estimar a distribuição amostral de \(\hat{\theta}\).
\[\mathbf{x}^*_b \sim F_{\hat{\theta}}, \quad b = 1, \ldots, B\]
A diferença fundamental em relação ao bootstrap não paramétrico: as reamostras são extraídas da distribuição paramétrica ajustada \(F_{\hat{\theta}}\), não da distribuição empírica \(\hat{F}_n\).
Bootstrap paramétrico vs não paramétrico
| Paramétrico | Não paramétrico (uniforme) | |
|---|---|---|
| Reamostra de | \(F_{\hat{\theta}}\) (modelo ajustado) | \(\hat{F}_n\) (distribuição empírica) |
| Exige suposição distribucional | Sim | Não |
| Eficiência quando o modelo é correto | Maior | Menor |
| Robustez quando o modelo é incorreto | Baixa | Boa |
| Adequado para \(n\) pequeno | Sim (se o modelo for correto) | Moderada |
| Casos de uso comuns | GLMs, modelos de sobrevivência, séries temporais | Qualquer estatístico, análise robusta |
O bootstrap paramétrico é mais eficiente porque usa toda a estrutura imposta pelo modelo: as amostras simuladas seguem exatamente a distribuição assumida, não a distribuição empírica ruidosa. Se o modelo é correto, isso reduz a variância de Monte Carlo. Se o modelo é incorreto, a distribuição bootstrap reflete o processo gerador de dados errado.
Exemplos
Exemplo 1: distribuição exponencial
O tempo entre requisições a um servidor segue uma distribuição exponencial com taxa desconhecida \(\lambda\). A partir de \(n = 25\) observações, \(\hat{\lambda} = 1/\bar{x} = 0{,}42\) (MLE). Estime o EP de \(\hat{\lambda}\) e compare o bootstrap paramétrico com o não paramétrico.
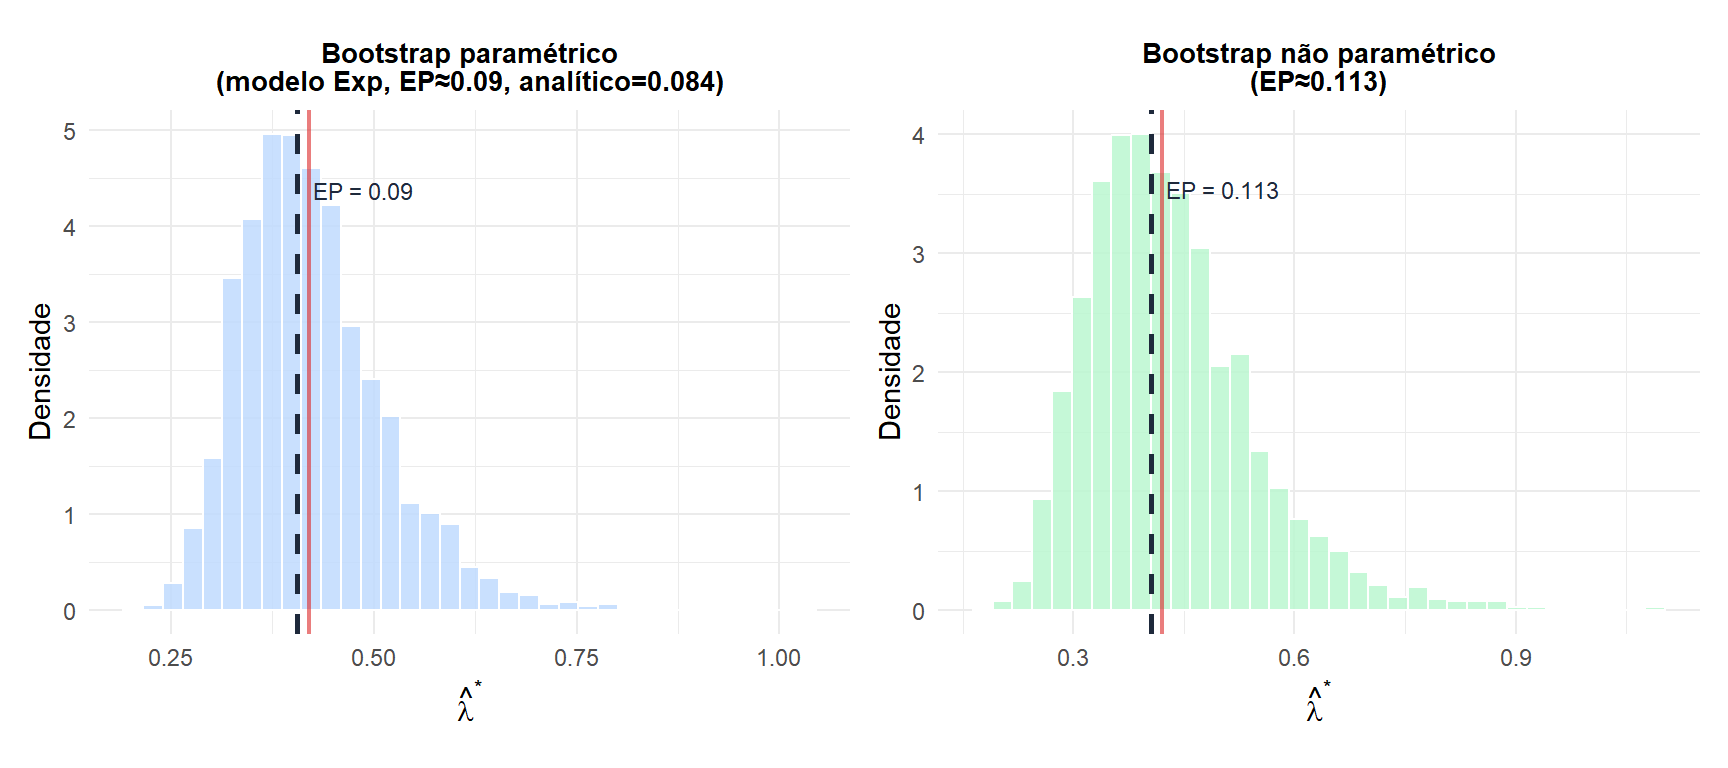
O bootstrap paramétrico (esquerda) produz uma distribuição mais estreita e suave, mais próxima do EP analítico, porque aproveita a estrutura exponencial. O bootstrap não paramétrico (direita) é mais amplo: não faz nenhuma suposição distribucional e, portanto, tem maior variância de Monte Carlo. A linha vermelha mostra o verdadeiro \(\lambda = 0{,}42\).
Exemplo 2: bootstrap paramétrico para um modelo de regressão
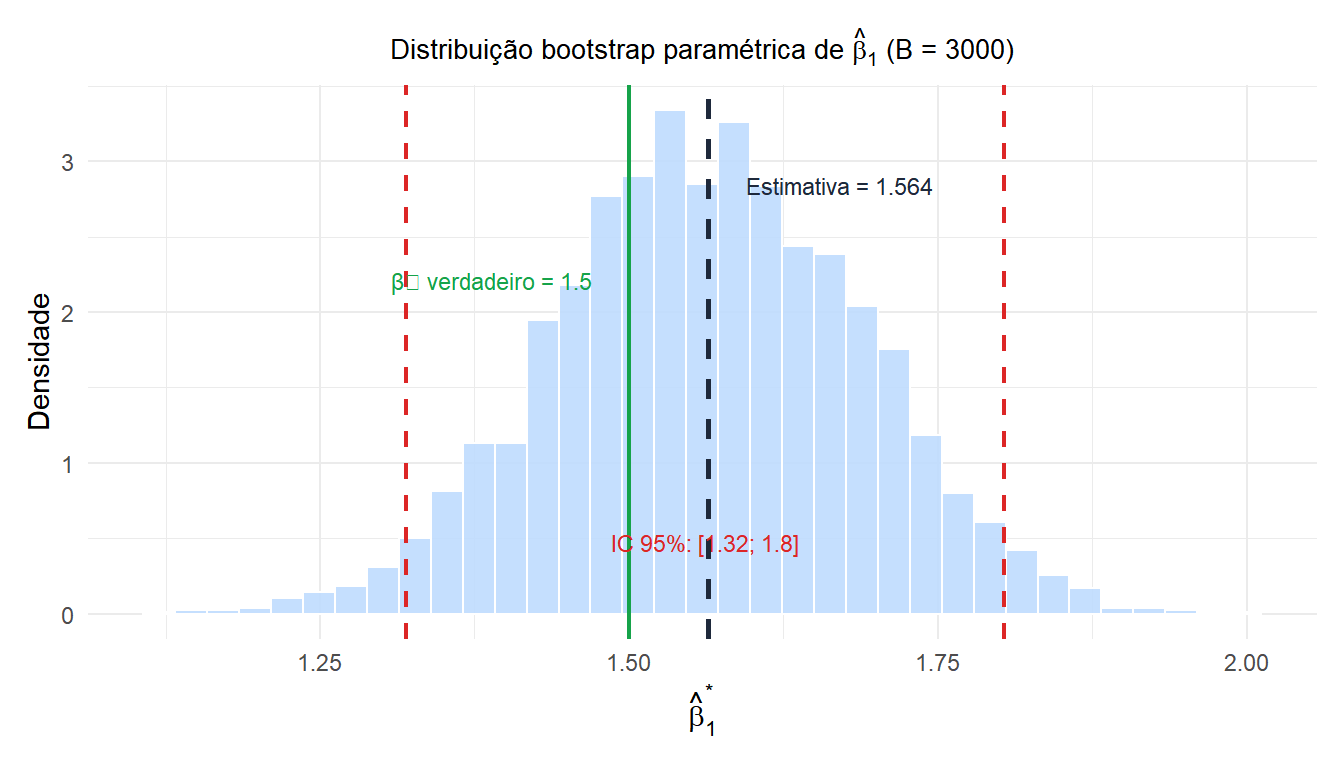
Em regressão, o bootstrap paramétrico ajusta o modelo e, depois, simula novos valores da resposta a partir da distribuição ajustada:
\[y_i^* = \hat{\beta}_0 + \hat{\beta}_1 x_i + \varepsilon_i^*, \qquad \varepsilon_i^* \sim N(0, \hat{\sigma}^2)\]
Isso gera conjuntos de dados bootstrap fixando a matriz de desenho \(X\) e simulando novos erros a partir de \(N(0, \hat{\sigma}^2)\). O modelo é então reajustado a cada conjunto de dados bootstrap para obter \(\hat{\beta}^*_b\).
Má especificação do modelo
Tudo o que foi dito acima assumia que a distribuição ajustada era a correta. É exatamente nessa suposição que o bootstrap paramétrico pode falhar silenciosamente.
⚠️ Um modelo errado produz distribuições bootstrap erradas
O bootstrap paramétrico só é válido quando a família distribucional assumida é correta. Se você ajustar uma distribuição normal a dados com assimetria positiva e usar o bootstrap paramétrico, as amostras simuladas serão simétricas, enquanto o verdadeiro processo gerador de dados é assimétrico. O EP e o IC bootstrap resultantes estarão incorretos.
Sinais de má especificação que convém verificar antes de usar o bootstrap paramétrico:
- Gráfico Q-Q: os pontos devem seguir a diagonal para a distribuição assumida.
- Teste de qualidade de ajuste: Shapiro-Wilk (normal), Kolmogorov-Smirnov (geral).
- Gráficos de resíduos: para modelos de regressão, os resíduos devem se ajustar à distribuição de erros assumida.
Se houver suspeita de má especificação, use o bootstrap não paramétrico ou o suavizado.
Quando usar o bootstrap paramétrico
O bootstrap paramétrico é a escolha natural quando:
- Existe um modelo distribucional bem justificado (exponencial para tempos de espera, Poisson para contagens, normal para erros de medição).
- A amostra é pequena e o bootstrap não paramétrico tem alta variância.
- Você está trabalhando dentro de uma estrutura de modelagem (GLM, modelo de sobrevivência, modelo misto) em que a estrutura paramétrica faz parte da inferência.
- Você precisa simular conjuntos de dados realistas para análise de poder ou estudos de simulação.
💡 Bootstrap paramétrico em R
# Exponential example
lhat <- 1 / mean(x)
boot_param <- replicate(2000, 1 / mean(rexp(length(x), rate = lhat)))
sd(boot_param)                           # bootstrap SE
quantile(boot_param, c(0.025, 0.975))   # 95% CI

# Regression example
fit <- lm(y ~ x)
boot_beta <- replicate(2000, {
  y_star <- fitted(fit) + rnorm(length(y), 0, sigma(fit))
  coef(lm(y_star ~ x))[2]
})
Para modelos complexos (GLMs, modelos mistos), a função simulate() do R gera amostras bootstrap paramétricas a partir de um objeto de modelo ajustado automaticamente.

