Bootstrap suavizado
O bootstrap suavizado substitui a distribuição empírica discreta \(\hat{F}_n\) por uma estimativa contínua de densidade por núcleo \(\hat{f}_h\) antes de reamostrar. Em vez de extrair dos pontos de dados originais, ele extrai de uma versão suavizada dos dados. Isso reduz o viés de discretização do bootstrap uniforme, especialmente para amostras pequenas e estatísticos que dependem da continuidade da distribuição.
Motivação: o problema da discretização
O bootstrap uniforme (naive) reamostra de \(\hat{F}_n\), que concentra massa de probabilidade \(1/n\) em cada valor observado. Para dados contínuos, isso é uma aproximação discreta de uma distribuição contínua. A consequência: a distribuição bootstrap também é discreta, o que pode levar a:
- Subestimação da variabilidade para estatísticos sensíveis à forma da distribuição (quantis, densidades).
- Valores idênticos repetidos nas reamostras, que podem distorcer as estimativas de amplitude ou extremos.
- Distribuições bootstrap irregulares com picos nos valores observados.
O bootstrap suavizado distribui cada ponto observado em uma pequena região contínua, produzindo uma aproximação mais suave e realista da população.
Algoritmo
Cada observação do bootstrap suavizado é gerada como:
\[x_i^* = x_{j} + h \cdot \varepsilon_i, \qquad j \sim \text{Uniforme}\{1, \ldots, n\}, \quad \varepsilon_i \sim K\]
em que \(K\) é uma função núcleo (comumente \(N(0,1)\)) e \(h > 0\) é a largura de banda. Isso equivale a amostrar da estimativa de densidade por núcleo:
\[\hat{f}_h(x) = \frac{1}{nh} \sum_{i=1}^n K\!\left(\frac{x - x_i}{h}\right)\]
O bootstrap suavizado substitui \(\hat{F}_n\) (distribuição empírica) por \(\hat{F}_h\) (CDF de núcleo). Quando \(h \to 0\), reduz-se ao bootstrap uniforme. Quando \(h \to \infty\), suaviza em excesso e perde informação.
Escolha da largura de banda
A largura de banda \(h\) controla o equilíbrio entre suavidade e fidelidade aos dados:
- Muito pequena (\(h \to 0\)): reduz-se ao bootstrap uniforme. Sem benefício de suavização.
- Muito grande: infla artificialmente a variabilidade além do que os dados sustentam.
Um padrão comum é a regra do polegar de Silverman para núcleos normais:
\[h = 0{,}9 \cdot \min\!\left(S, \frac{\text{IQR}}{1{,}34}\right) \cdot n^{-1/5}\]
Para fins de bootstrap, o \(h\) ótimo é menor do que para a estimação de densidade: na prática, é comum usar \(h_\text{boot} = h_\text{KDE} / \sqrt{2}\) ou \(h_\text{boot} = h_\text{KDE} \cdot n^{-1/10}\).
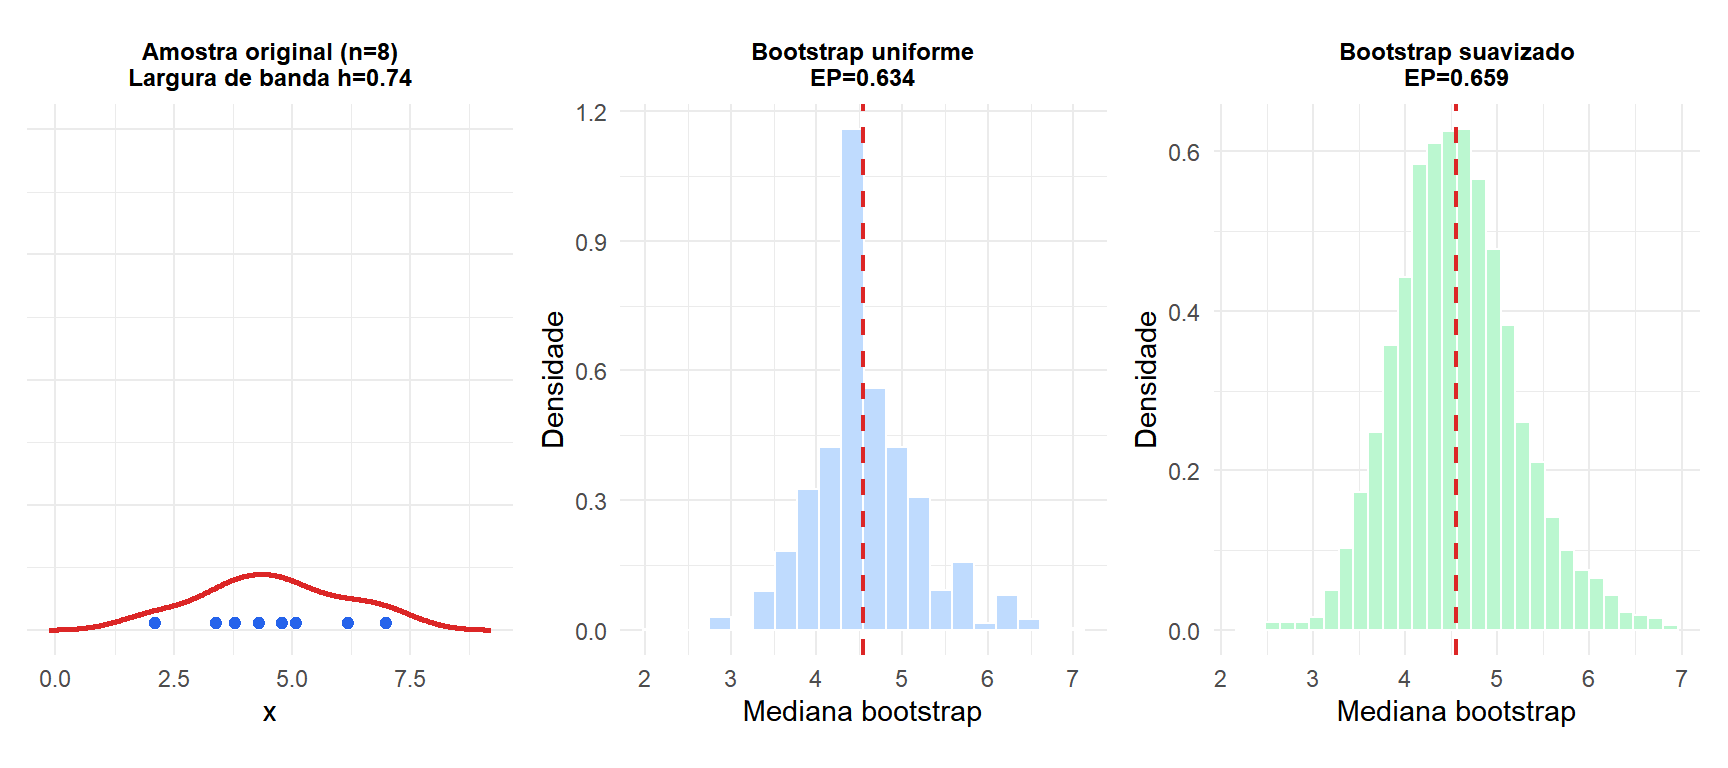
Com apenas 8 observações, a distribuição bootstrap uniforme da mediana (azul) é visivelmente discreta, com picos nos valores observados. O bootstrap suavizado (verde) produz uma distribuição contínua e mais suave que representa melhor a incerteza subjacente.
Quando usar o bootstrap suavizado
O bootstrap suavizado é mais benéfico quando:
- Amostras pequenas (\(n < 30\)): a distribuição empírica \(\hat{F}_n\) é uma má aproximação de \(F\).
- Estimação de densidades ou quantis: estatísticos que dependem da densidade local da distribuição são sensíveis à discretização.
- Distribuição subjacente contínua: se os dados vêm de uma população contínua, a suavização recupera essa continuidade.
- Redução de artefatos de discretização: quando a distribuição bootstrap uniforme mostra picos visíveis ou degraus discretos.
É menos útil, ou até prejudicial, quando:
- Os dados são verdadeiramente discretos (dados de contagem, escalas ordinais): a suavização distorce a discretização natural.
- A amostra é grande: o bootstrap uniforme já fornece uma boa aproximação.
- A largura de banda é mal escolhida: uma suavização excessiva pode inflar a variabilidade além do que os dados sustentam.
⚠️ A suavização nem sempre é melhor
Adicionar suavização introduz uma nova fonte de erro: a escolha da largura de banda. Se \(h\) for muito grande, o bootstrap suavizado gera valores distantes de qualquer dado observado, alargando artificialmente a distribuição bootstrap. Para amostras grandes, em que o bootstrap uniforme funciona bem, a suavização adiciona complexidade sem benefício.
Uma diretriz prática: use o bootstrap uniforme por padrão. Mude para o suavizado quando a distribuição bootstrap uniforme mostrar picos discretos visíveis ou quando você estiver estimando uma densidade contínua.
Exemplo: estimando um quantil
O percentil 75 de uma distribuição contínua é um funcional suave de \(F\), mas o quantil amostral de um conjunto de dados pequeno pode ser errático. O bootstrap suavizado fornece uma estimativa mais estável.
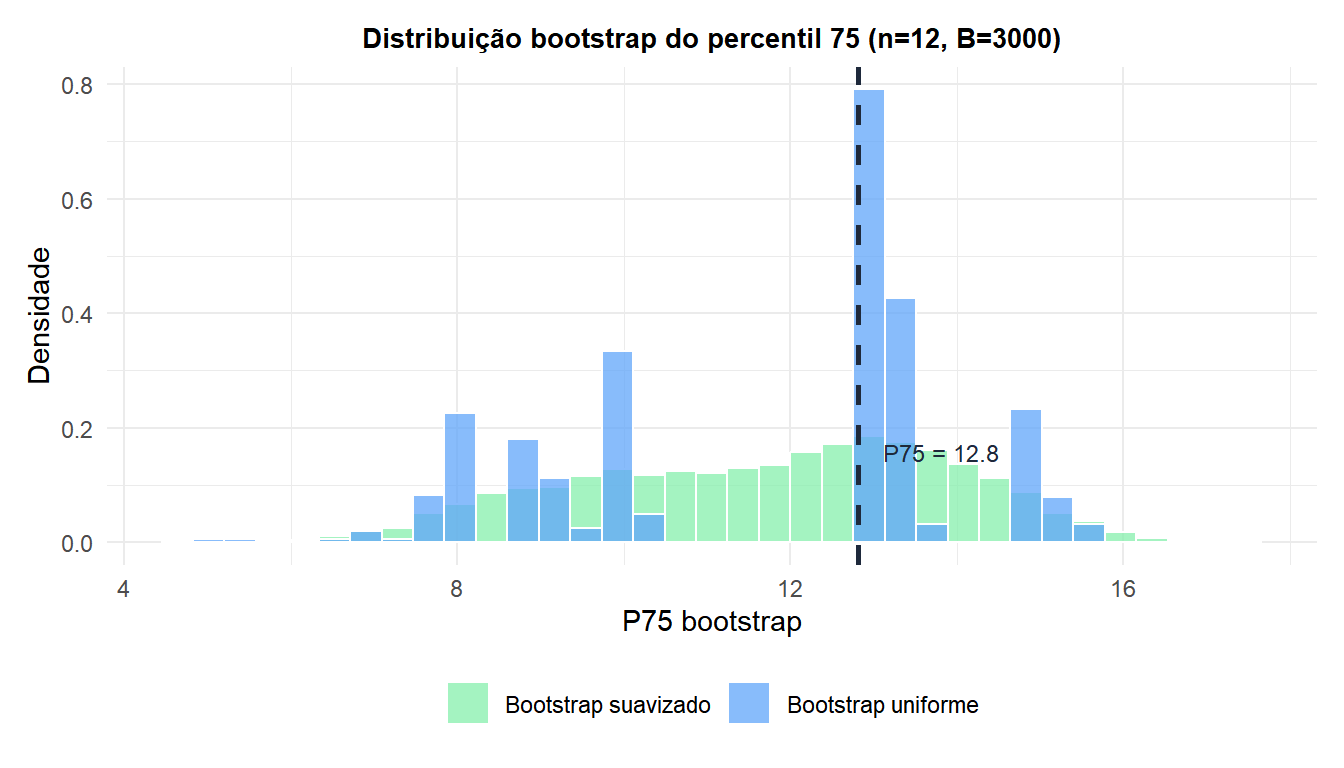
O bootstrap uniforme (azul) concentra a massa nos poucos valores de quantil distintos possíveis com \(n=12\). O bootstrap suavizado (verde) distribui essa massa de forma contínua, fornecendo um panorama mais realista da incerteza na estimativa do quantil.
💡 Bootstrap suavizado em R
O pacote boot não implementa diretamente o bootstrap suavizado, mas é simples de implementar:
library(boot)

## Define smoothed bootstrap statistic
smooth_boot_stat <- function(data, indices, h) {
  x_resamp <- data[indices] + rnorm(length(indices), 0, h)
  median(x_resamp)  # or any statistic
}

h <- 0.9 * min(sd(x), IQR(x)/1.34) * length(x)^(-0.2) / sqrt(2)
boot(data = x, statistic = smooth_boot_stat, R = 2000, h = h)
