Bootstrap uniforme
O bootstrap uniforme, também chamado de bootstrap não paramétrico ou bootstrap naive, é a forma padrão de reamostragem bootstrap. Cada observação da amostra original recebe a mesma probabilidade \(1/n\) de ser extraída em cada passo, de modo que as amostras bootstrap são extraídas da distribuição empírica \(\hat{F}_n\). É o método descrito no artigo original de Efron de 1979 e o padrão na maioria dos softwares. Veja nosso guia mais amplo sobre o que é o bootstrap para o panorama completo.
Definição
Dada uma amostra original \(\mathbf{x} = (x_1, \ldots, x_n)\), o bootstrap uniforme gera reamostras extraindo \(n\) observações de forma independente e com reposição, cada uma escolhida de forma uniforme a partir de \(\{x_1, \ldots, x_n\}\).
Isso equivale a amostrar da distribuição empírica \(\hat{F}_n\), que atribui massa de probabilidade \(1/n\) a cada valor observado:
\[\hat{F}_n(x) = \frac{1}{n} \sum_{i=1}^n \mathbf{1}(x_i \leq x)\]
O termo “uniforme” se refere aos pesos uniformes \(w_i = 1/n\) atribuídos a cada observação. Isso o distingue do bootstrap suavizado (que adiciona ruído aos valores reamostrados) e do bootstrap paramétrico (que amostra de uma distribuição paramétrica ajustada).
A representação por pesos multinomiais
Cada reamostra bootstrap pode ser caracterizada por um vetor de pesos \((m_1, m_2, \ldots, m_n)\), em que \(m_i\) é o número de vezes que a observação \(x_i\) aparece na reamostra. Essas contagens seguem uma distribuição multinomial:
\[(m_1, m_2, \ldots, m_n) \sim \text{Multinomial}\!\left(n;\; \frac{1}{n}, \frac{1}{n}, \ldots, \frac{1}{n}\right)\]
Isso implica que:
- \(E[m_i] = 1\): em média, cada observação aparece uma vez.
- \(\text{Var}(m_i) = (n-1)/n \approx 1\) para \(n\) grande.
- Aproximadamente \(1 - (1-1/n)^n \approx 1 - e^{-1} \approx 63{,}2\%\) das observações aparecem pelo menos uma vez em qualquer reamostra bootstrap. Os \(\approx 36{,}8\%\) restantes ficam de fora.
As observações fora da bolsa (OOB, do inglês out-of-bag), ou seja, as não incluídas em uma reamostra, podem ser usadas para validar modelos sem a necessidade de um conjunto de teste separado. Essa propriedade é fundamental em florestas aleatórias e estimadores por agregação (bagging).
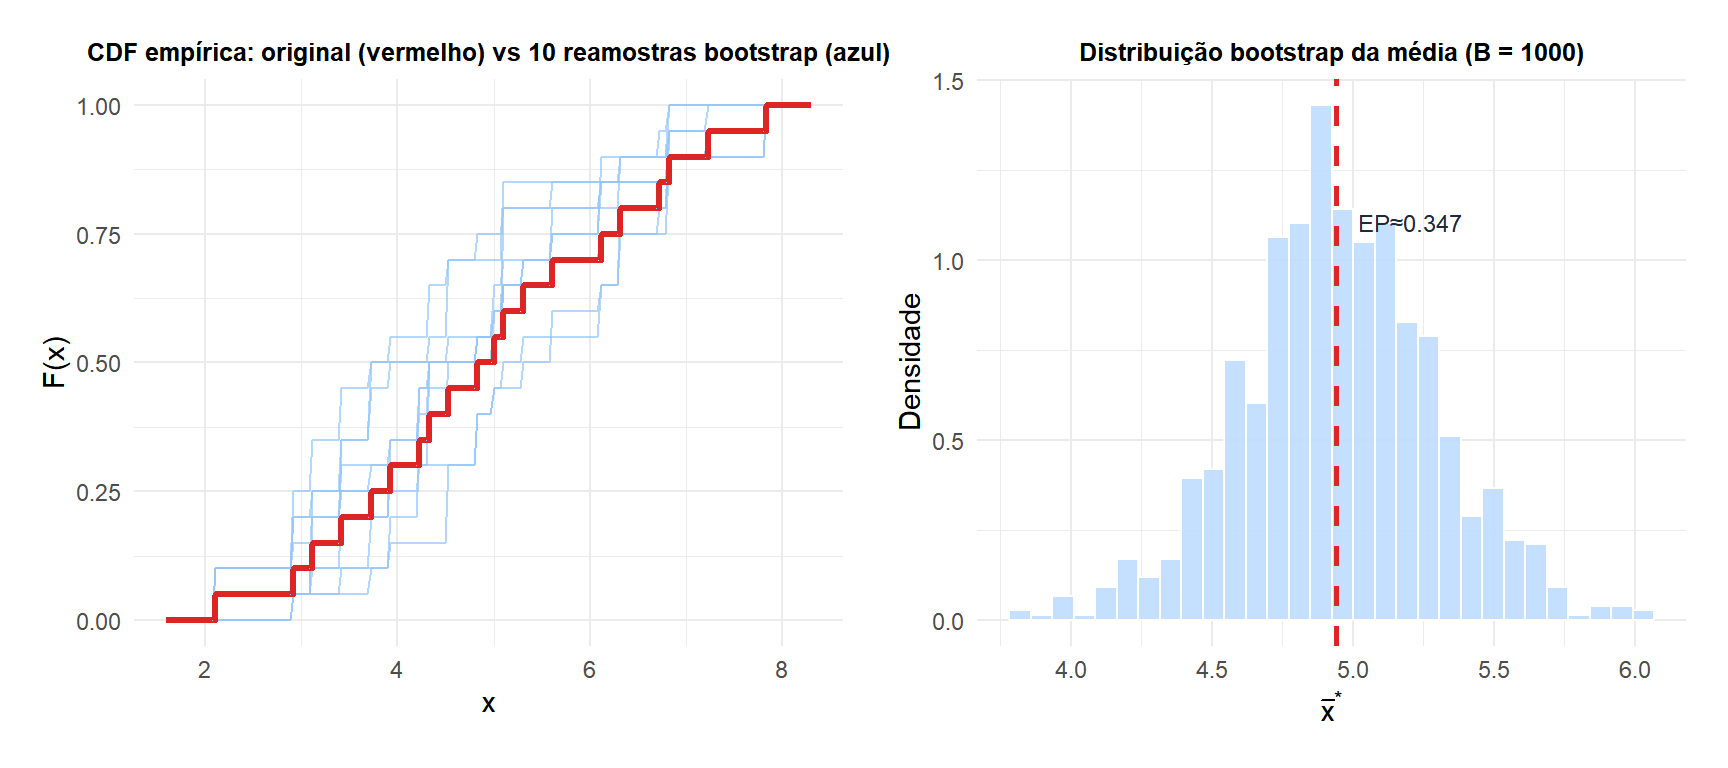
O painel esquerdo mostra como cada CDF empírica bootstrap (azul) flutua em torno da CDF original (vermelha): essa variabilidade é exatamente o que o bootstrap usa para estimar a incerteza. O painel direito mostra a distribuição bootstrap resultante da média amostral.
Exemplo completo
Um engenheiro de confiabilidade registra o tempo até a falha (horas) de 15 componentes eletrônicos:
\[x = (120, 95, 142, 108, 87, 155, 131, 99, 167, 113, 78, 144, 102, 138, 91)\]
A média observada é \(\bar{x} = 117{,}9\) horas. O EP teórico da média para uma distribuição exponencial exigiria conhecer o parâmetro de taxa. Em vez disso, usa-se o bootstrap uniforme.
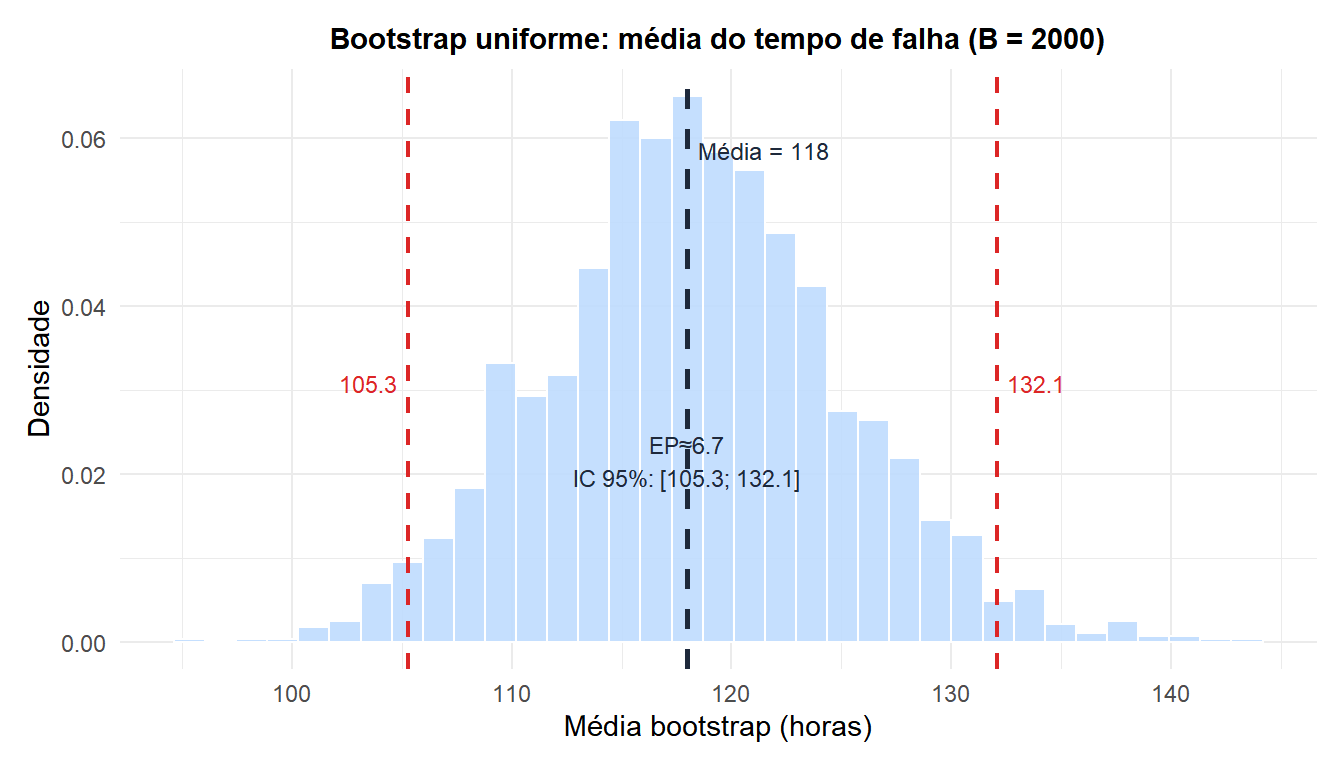
EP bootstrap \(\approx\) 6.6 horas. O IC percentil de 95% dá os limites mostrados em vermelho.
Bootstrap uniforme vs outras variantes
| Uniforme | Suavizado | Paramétrico | |
|---|---|---|---|
| Reamostra de | \(\hat{F}_n\) (empírica) | \(\hat{F}_n\) + ruído | \(F_\theta\) ajustada |
| Pressupõe distribuição | Não | Não | Sim |
| Para \(n\) pequeno | Moderado | Melhor | Melhor (se correto) |
| Para dados contínuos | Discretiza | Correto | Correto |
| Padrão na prática | Sim | Raramente | Comum em modelagem |
O bootstrap uniforme é o padrão porque não exige suposições. Sua principal fraqueza é que a distribuição empírica \(\hat{F}_n\) é discreta mesmo quando a população é contínua, o que pode subestimar a variabilidade em amostras pequenas. O bootstrap suavizado aborda isso.
💡 A regra dos 63,2% e a estimação fora da bolsa
Em qualquer reamostra do bootstrap uniforme, aproximadamente \(1 - e^{-1} \approx 63{,}2\%\) das observações originais aparecem pelo menos uma vez. Os \(36{,}8\%\) restantes ficam fora da bolsa (OOB). Essa propriedade é usada em florestas aleatórias: cada árvore é treinada com uma reamostra bootstrap, e suas observações OOB servem como um conjunto de validação integrado. A estimativa do erro OOB é quase equivalente à validação cruzada deixando um de fora, sem o custo computacional envolvido.

