O que é o bootstrap?
O bootstrap, introduzido por Bradley Efron em 1979, é um método de reamostragem que estima a distribuição amostral de qualquer estatístico extraindo repetidamente amostras com reposição a partir dos dados originais. Não exige suposições sobre a distribuição da população e funciona para estatísticos cuja distribuição teórica é intratável.
A ideia central
A inferência clássica deriva a distribuição amostral de \(\hat{\theta}\) a partir de suposições sobre a população (por exemplo, normalidade). O bootstrap inverte essa lógica: usa os próprios dados como substituto da população e simula o processo de amostragem reamostrando os dados observados.
O raciocínio: se a amostra é uma boa representação da população, então amostras extraídas da amostra com reposição se comportam como amostras extraídas da população. A distribuição de \(\hat{\theta}^*\) ao longo de muitas amostras bootstrap aproxima a verdadeira distribuição amostral de \(\hat{\theta}\).
O princípio do bootstrap:
\[\text{População} \xrightarrow{\text{amostragem}} \text{Amostra} \xrightarrow{\text{reamostragem com reposição}} \text{Amostras bootstrap}\]
\[\text{Distribuição real de } \hat{\theta} \approx \text{Distribuição bootstrap de } \hat{\theta}^*\]
O algoritmo
Dada uma amostra original \(\mathbf{x} = (x_1, x_2, \ldots, x_n)\) e um estatístico de interesse \(\hat{\theta} = g(\mathbf{x})\):
- Extraia uma amostra bootstrap \(\mathbf{x}^* = (x_1^*, \ldots, x_n^*)\) de tamanho \(n\) amostrando com reposição de \(\mathbf{x}\).
- Calcule \(\hat{\theta}^* = g(\mathbf{x}^*)\).
- Repita os passos 1-2 \(B\) vezes, obtendo \(\hat{\theta}^*_1, \hat{\theta}^*_2, \ldots, \hat{\theta}^*_B\).
- Use a distribuição de \(\{\hat{\theta}^*_b\}\) para estimar a distribuição amostral de \(\hat{\theta}\).
\(B = 1{.}000\) é um mínimo comum para a estimação do erro padrão; \(B = 10{.}000\) para intervalos de confiança.
Exemplo: distribuição bootstrap da mediana
A distribuição amostral da mediana não tem forma fechada simples para a maioria das populações. O bootstrap fornece uma aproximação empírica.
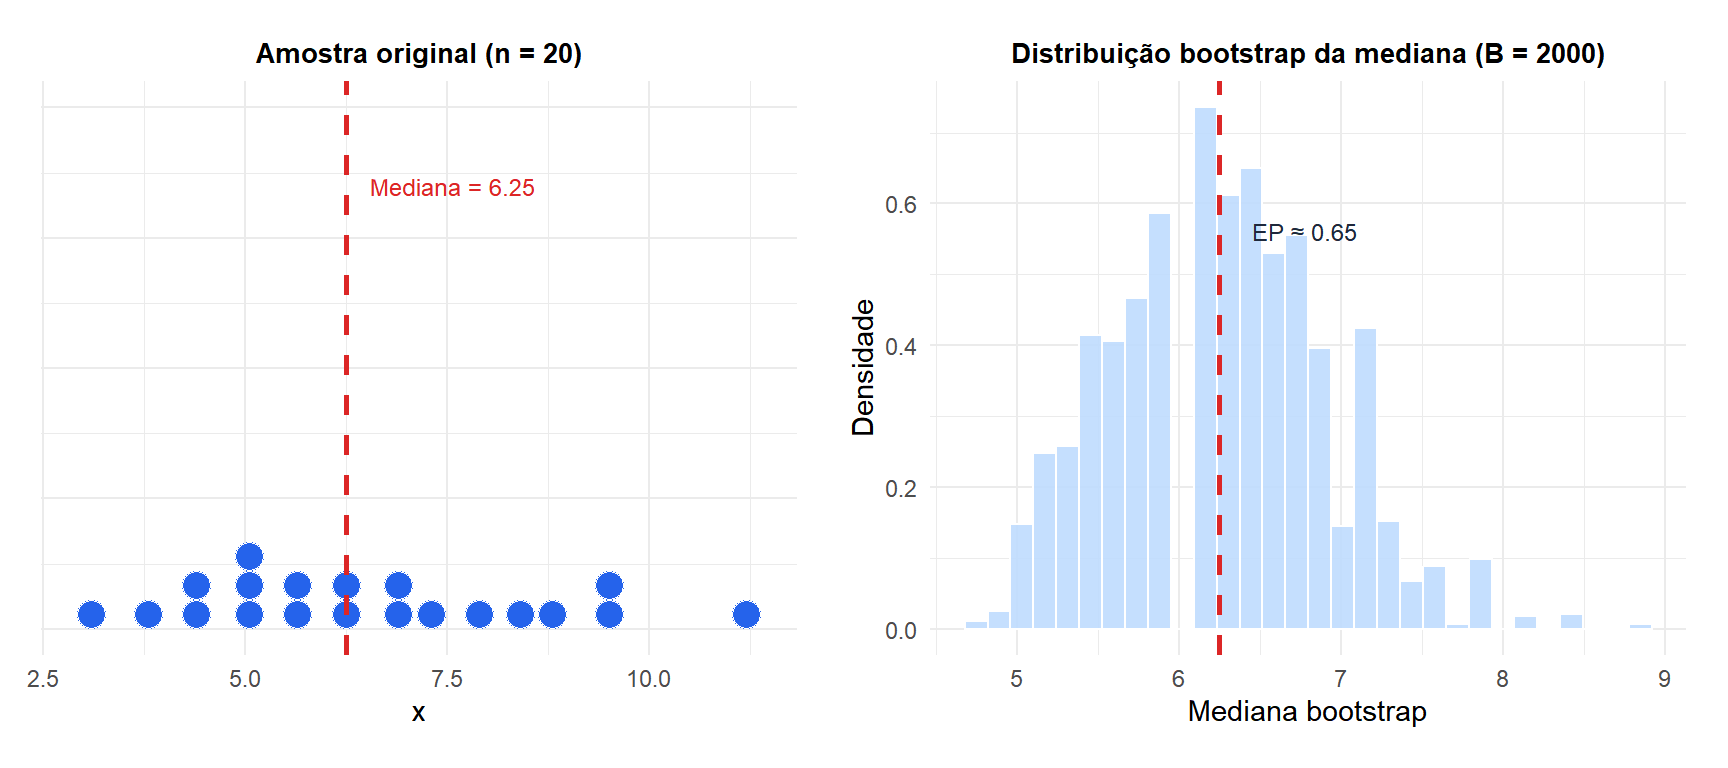
O painel esquerdo mostra a amostra original com sua mediana observada. O painel direito mostra a distribuição da mediana ao longo de 2.000 reamostras bootstrap: aproximadamente normal e centrada na mediana observada. O desvio padrão dessa distribuição é o erro padrão bootstrap da mediana.
O que o bootstrap estima
A distribuição bootstrap de \(\hat{\theta}^*\) centrada em \(\hat{\theta}\) aproxima a distribuição amostral de \(\hat{\theta}\) centrada em \(\theta\). A partir dela, podemos estimar:
- Erro padrão: \(\widehat{\text{EP}}_\text{boot} = \text{DP}(\hat{\theta}^*_1, \ldots, \hat{\theta}^*_B)\).
- Viés: \(\widehat{\text{Viés}}_\text{boot} = \bar{\hat{\theta}}^* - \hat{\theta}\), em que \(\bar{\hat{\theta}}^*\) é a média das estimativas bootstrap.
- Intervalos de confiança: percentil, básico, BCa (abordados no post sobre IC bootstrap).
- Forma da distribuição amostral: útil para detectar assimetria ou multimodalidade.
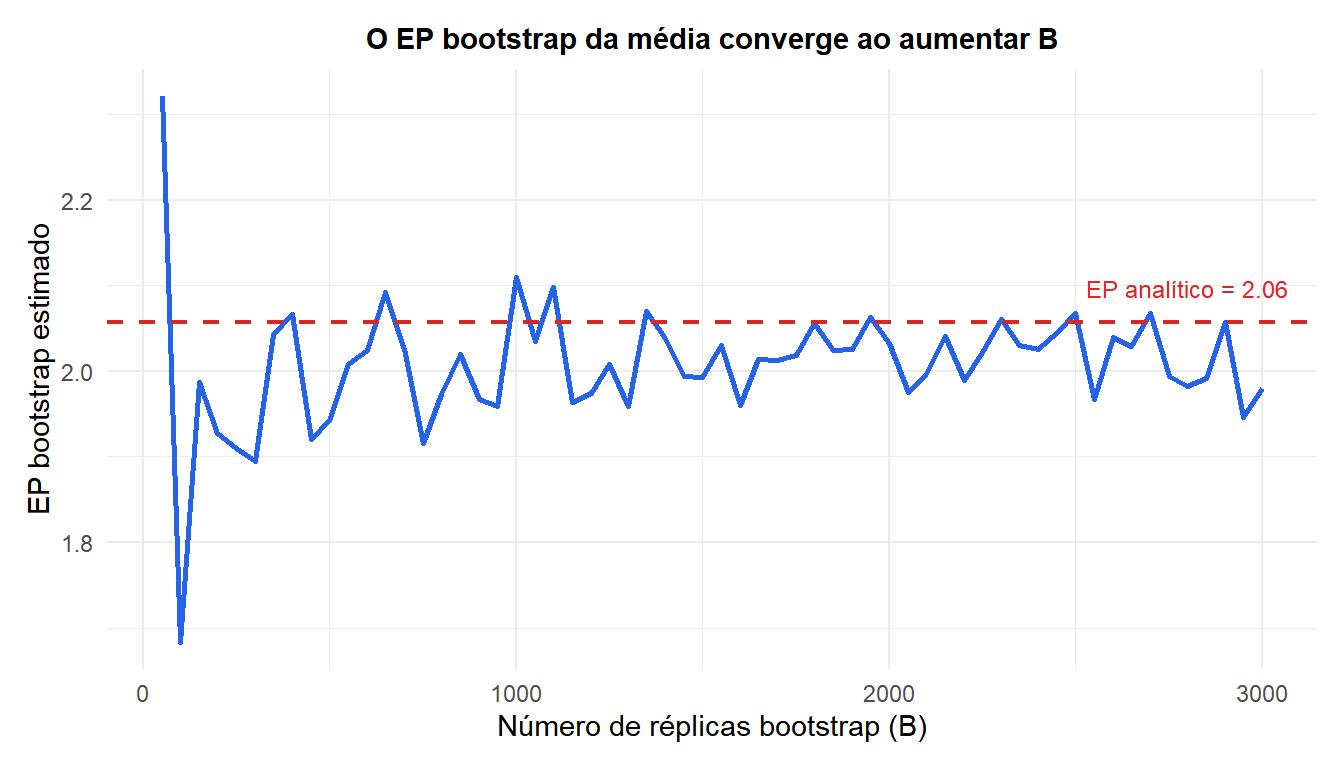
O EP bootstrap converge rapidamente: em \(B = 500\) já está próximo do valor analítico. Para os intervalos de confiança, recomenda-se um \(B\) maior (normalmente 2.000-10.000) para obter estabilidade nas caudas.
Por que funciona
O bootstrap se justifica pelo princípio da substituição: substituir a distribuição populacional desconhecida \(F\) pela distribuição empírica \(\hat{F}_n\) (que atribui probabilidade \(1/n\) a cada valor observado). Qualquer funcional de \(F\) (média, variância, quantil) pode então ser estimado pelo funcional correspondente de \(\hat{F}_n\).
Reamostrar com reposição a partir da amostra original é equivalente a amostrar de \(\hat{F}_n\). Quando \(n \to \infty\), \(\hat{F}_n \to F\) (pelo teorema de Glivenko-Cantelli), de modo que a aproximação bootstrap melhora com amostras maiores.
Limitações
O princípio de substituição acima depende de \(\hat{F}_n\) ser um substituto razoável de \(F\), e isso deixa de valer em algumas situações reconhecíveis.
⚠️ Quando o bootstrap falha ou funciona mal
O bootstrap não é universalmente válido. Pode falhar quando:
- Amostras pequenas: \(\hat{F}_n\) é uma má aproximação de \(F\) com poucas observações. O bootstrap suavizado (próximo post) aborda isso parcialmente.
- Quantis extremos: estimar o percentil 99 a partir de \(n = 50\) observações é pouco confiável mesmo com bootstrap, porque as caudas de \(\hat{F}_n\) são mal estimadas.
- Dados dependentes: o bootstrap padrão pressupõe observações i.i.d. Para séries temporais, use o bootstrap por blocos ou o bootstrap por blocos circular.
- Estatísticos não suaves: o bootstrap pode ser inconsistente para estatísticos como o máximo amostral ou estatísticos com discontinuidades.
Quando o bootstrap falha, o bootstrap paramétrico (assumindo uma família distribucional específica) costuma ser uma alternativa melhor.
💡 Quantas réplicas bootstrap?
- Estimação do erro padrão: \(B = 200\)–\(500\) costuma ser suficiente.
- Intervalos de confiança percentil: \(B = 1{.}000\)–\(2{.}000\).
- Intervalos de confiança BCa: \(B = 5{.}000\)–\(10{.}000\) para resultados estáveis.
- Valores-p em testes de hipóteses: \(B \geq 10{.}000\) para valores-p próximos do limiar de significância.
Em R: boot::boot(data, statistic, R = 1000). A função statistic deve aceitar os dados e um vetor de índices como argumentos.

