Intervalos de confiança bootstrap
Os intervalos de confiança bootstrap usam a distribuição bootstrap de \(\hat{\theta}^*\) para construir uma faixa de valores plausíveis para o verdadeiro parâmetro \(\theta\). Existem quatro métodos principais, que diferem em precisão, suposições e custo computacional. O intervalo BCa é a opção mais precisa de uso geral.
Configuração e notação
A partir de \(B\) reamostras bootstrap, temos estimativas \(\hat{\theta}^*_1, \ldots, \hat{\theta}^*_B\). Seja \(\hat{\theta}^*_{(\alpha)}\) o quantil \(\alpha\) da distribuição bootstrap. O estatístico observado na amostra original é \(\hat{\theta}\).
- Intervalo percentil
O método mais simples: usa diretamente os quantis da distribuição bootstrap.
\[\text{IC}_\text{perc} = \left[\hat{\theta}^*_{(\alpha/2)},\; \hat{\theta}^*_{(1-\alpha/2)}\right]\]
Intuição: se a distribuição bootstrap está centrada em \(\hat{\theta}\) e é simétrica, o intervalo percentil é uma aproximação válida. Aplicação: ordene as \(B\) estimativas bootstrap e tome os valores nas posições \(\lfloor B\alpha/2 \rfloor\) e \(\lceil B(1-\alpha/2) \rceil\).
Limitação: o intervalo percentil ignora o viés. Se a distribuição bootstrap está deslocada em relação à verdadeira distribuição amostral (ou seja, \(E[\hat{\theta}^*] \neq \hat{\theta}\) ou \(E[\hat{\theta}] \neq \theta\)), o intervalo tem cobertura incorreta.
- Intervalo básico (invertido)
Também chamado de empírico ou pivotal. Usa a distribuição bootstrap de \(\hat{\theta}^* - \hat{\theta}\) como aproximação da distribuição amostral de \(\hat{\theta} - \theta\):
\[\text{IC}_\text{básico} = \left[2\hat{\theta} - \hat{\theta}^*_{(1-\alpha/2)},\; 2\hat{\theta} - \hat{\theta}^*_{(\alpha/2)}\right]\]
Intuição: reflete a distribuição bootstrap em torno de \(\hat{\theta}\). Isso corrige o viés na localização da distribuição bootstrap, mas não a assimetria. Os limites estão “invertidos”: o limite superior usa o quantil bootstrap inferior e vice-versa.
- Intervalo estudentizado (bootstrap-t)
O intervalo mais preciso quando se dispõe de uma estimativa do erro padrão. Padroniza o estatístico bootstrap pelo seu próprio EP:
\[t_b^* = \frac{\hat{\theta}^*_b - \hat{\theta}}{\widehat{\text{EP}}^*_b}\]
\[\text{IC}_\text{stud} = \left[\hat{\theta} - t^*_{(1-\alpha/2)} \cdot \widehat{\text{EP}},\; \hat{\theta} - t^*_{(\alpha/2)} \cdot \widehat{\text{EP}}\right]\]
em que \(\widehat{\text{EP}}^*_b\) é o EP de \(\hat{\theta}^*_b\) estimado a partir de um bootstrap aninhado dentro de cada reamostra (ou analiticamente, se disponível), e \(\widehat{\text{EP}}\) é o EP da amostra original.
Vantagem: leva em conta a variação do EP entre as reamostras bootstrap, alcançando precisão de segunda ordem. Desvantagem: exige \(B \times B\) bootstrap aninhado ou uma fórmula analítica do EP, o que o torna computacionalmente caro.
- Intervalo BCa (corrigido por viés e acelerado)
A recomendação padrão para uso geral. Ajusta o intervalo percentil tanto por viés quanto por assimetria usando duas quantidades:
- Correção por viés \(\hat{z}_0\): mede o quanto a distribuição bootstrap está deslocada em relação a \(\hat{\theta}\).
- Aceleração \(\hat{a}\): mede como o EP de \(\hat{\theta}\) varia com o verdadeiro valor do parâmetro (estimado por meio do jackknife).
\[\hat{z}_0 = \Phi^{-1}\!\left(\frac{\#\{\hat{\theta}^*_b < \hat{\theta}\}}{B}\right)\]
\[\hat{a} = \frac{\sum_{i=1}^n (\bar{\psi} - \psi_i)^3}{6\left[\sum_{i=1}^n (\bar{\psi} - \psi_i)^2\right]^{3/2}}, \quad \psi_i = \hat{\theta}_{(i)} \text{ (jackknife)}\]
\[\alpha_1 = \Phi\!\left(\hat{z}_0 + \frac{\hat{z}_0 + z_{\alpha/2}}{1 - \hat{a}(\hat{z}_0 + z_{\alpha/2})}\right), \quad \alpha_2 = \Phi\!\left(\hat{z}_0 + \frac{\hat{z}_0 + z_{1-\alpha/2}}{1 - \hat{a}(\hat{z}_0 + z_{1-\alpha/2})}\right)\]
\[\text{IC}_\text{BCa} = \left[\hat{\theta}^*_{(\alpha_1)},\; \hat{\theta}^*_{(\alpha_2)}\right]\]
Quando \(\hat{z}_0 = 0\) (sem viés) e \(\hat{a} = 0\) (sem assimetria), o BCa se reduz ao intervalo percentil. O BCa alcança precisão de segunda ordem: seu erro de cobertura é \(O(n^{-1})\) em vez de \(O(n^{-1/2})\) do intervalo percentil.
Comparação dos quatro métodos
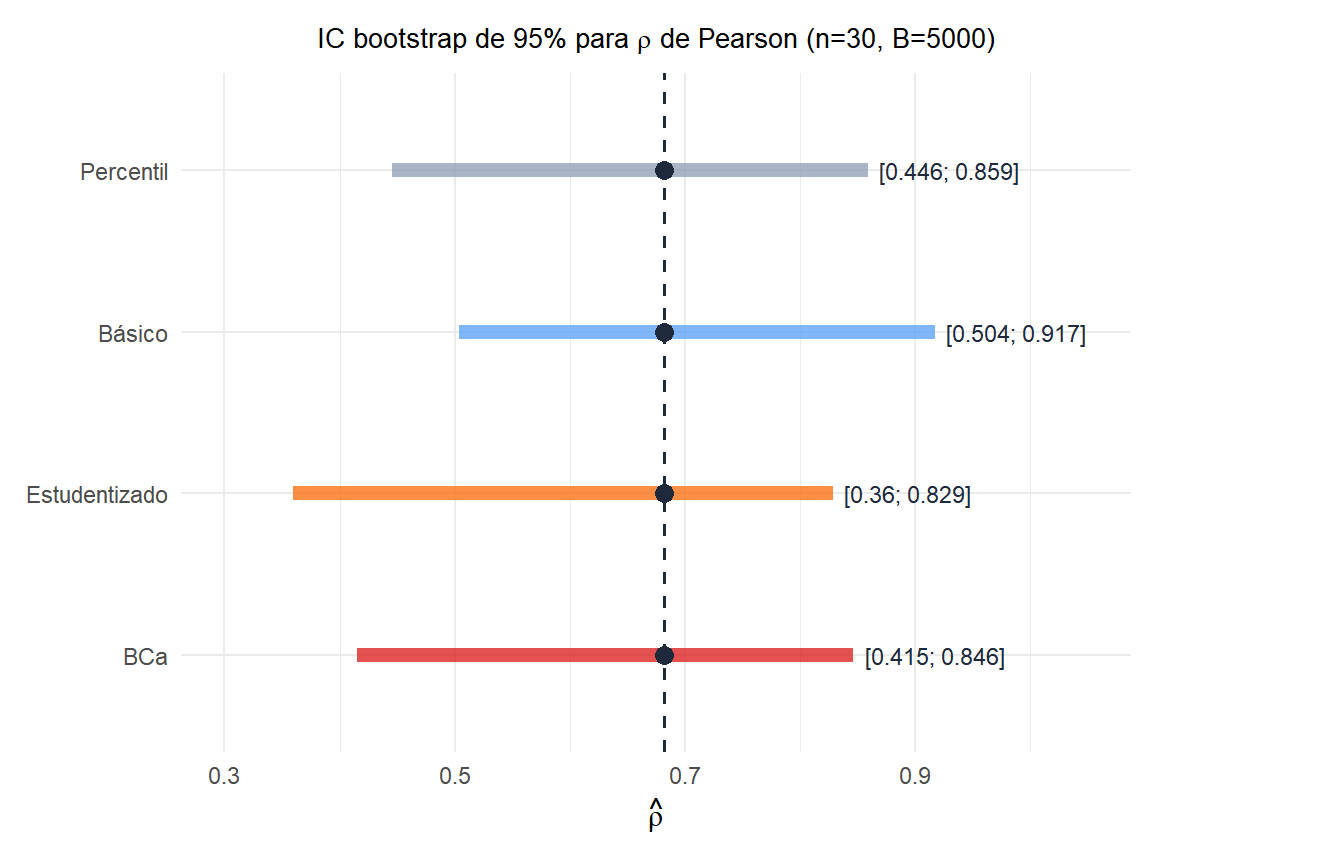
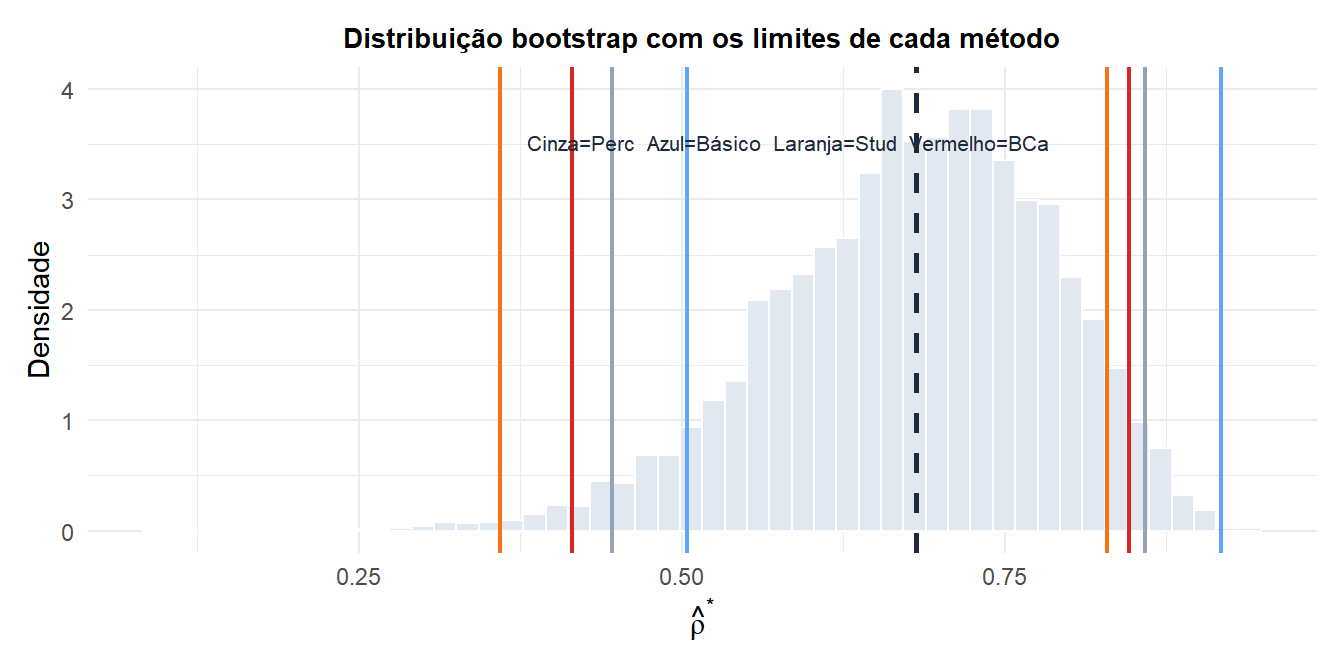
Os quatro intervalos diferem em posição e amplitude porque fazem correções diferentes por viés e assimetria. Para uma correlação próxima do limite (\(\hat{\rho} \approx 0{,}8\)), a distribuição é assimétrica à esquerda e o BCa produz o intervalo assimétrico mais adequado.
Qual método usar
| Método | Precisão | Exige | Melhor para |
|---|---|---|---|
| Percentil | Primeira ordem | \(B \geq 1000\) | Estimativas rápidas, distribuições simétricas |
| Básico | Primeira ordem | \(B \geq 1000\) | Corrige o viés de localização |
| Estudentizado | Segunda ordem | EP por reamostra | Estatísticos pivotáveis com EP disponível |
| BCa | Segunda ordem | \(B \geq 5000\) + jackknife | Uso geral, distribuições assimétricas |
⚠️ O intervalo percentil pode ter cobertura deficiente para estatísticos viesados ou assimétricos
O intervalo percentil pressupõe que a distribuição bootstrap tem a mesma forma que a verdadeira distribuição amostral. Quando \(\hat{\theta}\) é viesado ou sua distribuição é assimétrica (comum para estatísticos limitados, como correlações, proporções e variâncias), o intervalo percentil tem cobertura real abaixo do nível nominal.
Para correlações próximas de \(\pm 1\), variâncias e outros parâmetros limitados, prefira sempre o BCa em vez do percentil. Para a média amostral de uma distribuição simétrica, os quatro métodos dão resultados semelhantes.
💡 IC bootstrap em R com o pacote boot
library(boot)

stat_fn  <- function(data, idx) median(data[idx])
boot_obj <- boot(x, stat_fn, R = 5000)

# All four intervals at once
boot.ci(boot_obj, conf = 0.95,
        type = c("perc", "basic", "stud", "bca"))
Para o intervalo estudentizado, a função statistic deve retornar um vetor c(estimativa, variância). Para o BCa, recomenda-se ao menos \(B = 2000\); \(B = 5000\) para estabilidade nas caudas.

