Poder de um teste
O poder de um teste é a probabilidade de rejeitar corretamente uma hipótese nula falsa. Um teste com pouco poder deixa passar efeitos reais: ele produz muitos falsos negativos. Planejar um poder adequado antes de coletar os dados é um dos passos mais importantes no planejamento de um estudo.
Definição
O poder é definido como:
\[\text{Poder} = P(\text{rejeitar } H_0 \mid H_1 \text{ \'{e} verdadeira}) = 1 - \beta\]
em que \(\beta = P(\text{n\~{a}o rejeitar } H_0 \mid H_1 \text{ \'{e} verdadeira})\) é a probabilidade de erro tipo II. Um poder de 0,80 significa que há 80% de chance de detectar um efeito real, se ele existir.
O poder depende de quatro quantidades, todas interligadas:
- Tamanho de efeito \(\delta\): quão grande é a diferença real.
- Tamanho de amostra \(n\): mais dados sempre aumentam o poder.
- Nível de significância \(\alpha\): um \(\alpha\) maior aumenta o poder, mas também o risco de erro tipo I.
- Variabilidade populacional \(\sigma\): populações menos variáveis são mais fáceis de estudar.
Se três dessas quantidades forem fixadas, a quarta fica determinada. A análise de poder usa essa relação para encontrar o \(n\) mínimo necessário para alcançar um poder-alvo.
Visualizando o poder
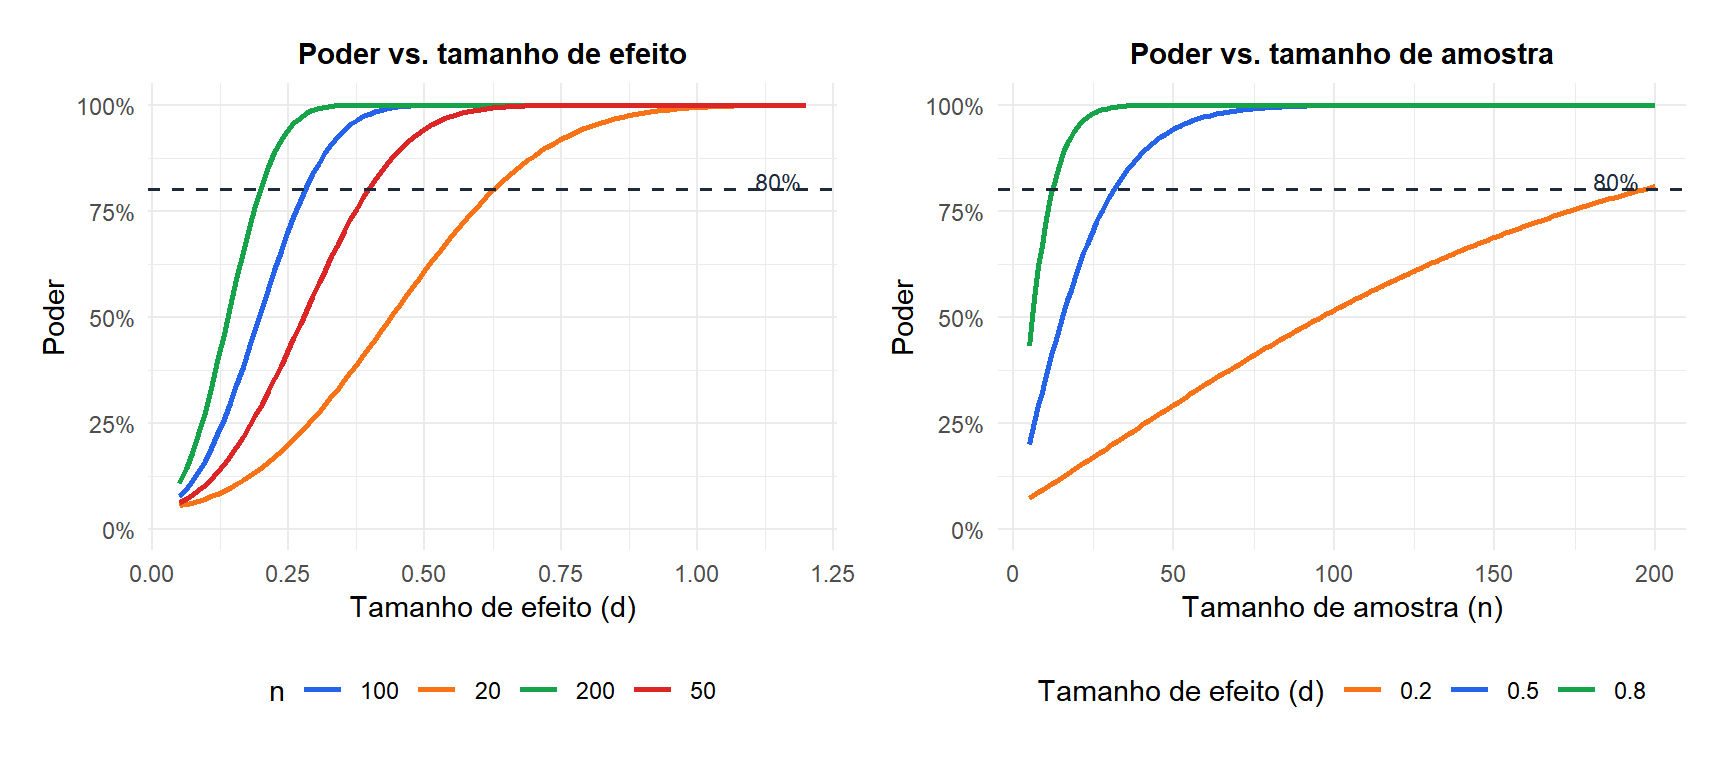
O poder é a área sob a distribuição alternativa que cai na região de rejeição. A figura a seguir mostra como ele varia com o tamanho de efeito e o tamanho de amostra.
Calculando o poder para um teste z de uma amostra
Para um teste z de uma amostra bilateral com \(\sigma\) conhecido, testando \(H_0: \mu = \mu_0\) vs. \(H_1: \mu = \mu_1\):
\[\text{Poder} = \Phi\!\left(\frac{|\mu_1 - \mu_0|}{\sigma/\sqrt{n}} - z_{\alpha/2}\right) + \Phi\!\left(-\frac{|\mu_1 - \mu_0|}{\sigma/\sqrt{n}} - z_{\alpha/2}\right)\]
em que \(\Phi\) é a CDF da normal padrão. Para fins práticos, o segundo termo é desprezível quando o efeito não é minúsculo, simplificando para:
\[\text{Poder} \approx \Phi\!\left(\frac{|\mu_1 - \mu_0|}{\sigma/\sqrt{n}} - z_{\alpha/2}\right) = \Phi\!\left(d\sqrt{n} - z_{\alpha/2}\right)\]
em que \(d = |\mu_1 - \mu_0|/\sigma\) é o \(d\) de Cohen.
Uma fábrica monitora o volume de enchimento. \(H_0: \mu = 500\) ml. O processo é considerado problemático se \(\mu = 498\) ml (um desvio de 2 ml). \(\sigma = 5\) ml conhecido, \(n = 40\), \(\alpha = 0{,}05\).
\[d = \frac{|498 - 500|}{5} = 0{,}4, \qquad d\sqrt{n} = 0{,}4 \times \sqrt{40} \approx 2{,}530\]
\[\text{Poder} \approx \Phi(2{,}530 - 1{,}960) = \Phi(0{,}570) \approx 0{,}716\]
O teste tem 71,6% de poder para detectar um desvio de 2 ml com \(n = 40\). Isso está abaixo da meta de 80%. Para alcançar 80% de poder:
\[n \geq \left(\frac{z_{0{,}025} + z_{0{,}20}}{d}\right)^2 = \left(\frac{1{,}960 + 0{,}842}{0{,}4}\right)^2 = \left(\frac{2{,}802}{0{,}4}\right)^2 \approx 49\]
Com \(n = 49\) (arredondado para 50), o teste alcança \(\geq 80\%\) de poder.

Análise de poder a priori vs. post hoc
Análise de poder a priori
Realizada antes da coleta de dados. Você especifica o poder desejado (por exemplo, 0,80), o nível de significância \(\alpha\) e o tamanho mínimo de efeito que quer detectar, e resolve para \(n\). Este é o uso correto da análise de poder.
Análise de poder post hoc (observada)
Realizada depois do estudo, usando o tamanho de efeito observado e o \(n\) real para calcular o poder. Essa prática quase sempre é pouco informativa e frequentemente enganosa.
⚠️ A análise de poder post hoc não é útil
A análise de poder post hoc usa o tamanho de efeito observado como se fosse o efeito real. Mas o efeito observado é uma estimativa ruidosa: para um resultado não significativo, o tamanho de efeito observado é tendencioso para baixo por definição (se fosse grande o suficiente, o teste teria sido significativo). O poder post hoc calculado a partir de um resultado não significativo é mecanicamente baixo, o que não revela nada de novo.
A resposta correta a um resultado não significativo não é calcular o poder post hoc, mas reportar o intervalo de confiança do parâmetro e discutir quais tamanhos de efeito são compatíveis com os dados.
Fatores que aumentam o poder
Dado um tamanho de efeito e \(\alpha\) fixos, o poder pode ser aumentado:
- Aumentando \(n\): a palanca mais direta.
- Reduzindo \(\sigma\): melhores instrumentos de medição, amostras mais homogêneas, controle de fatores de confusão.
- Usando um teste unilateral: se a direção for conhecida de antemão e justificada, o valor crítico é menor, aumentando o poder. Use apenas quando apropriado.
- Aumentando \(\alpha\): aceitar uma taxa de erro tipo I maior para reduzir os erros tipo II. Justificado quando o custo de deixar passar um efeito real supera o de um falso alarme (por exemplo, em testes de triagem).
- Delineamentos pareados ou combinados: o pareamento remove a variabilidade entre sujeitos, reduzindo efetivamente \(\sigma\).
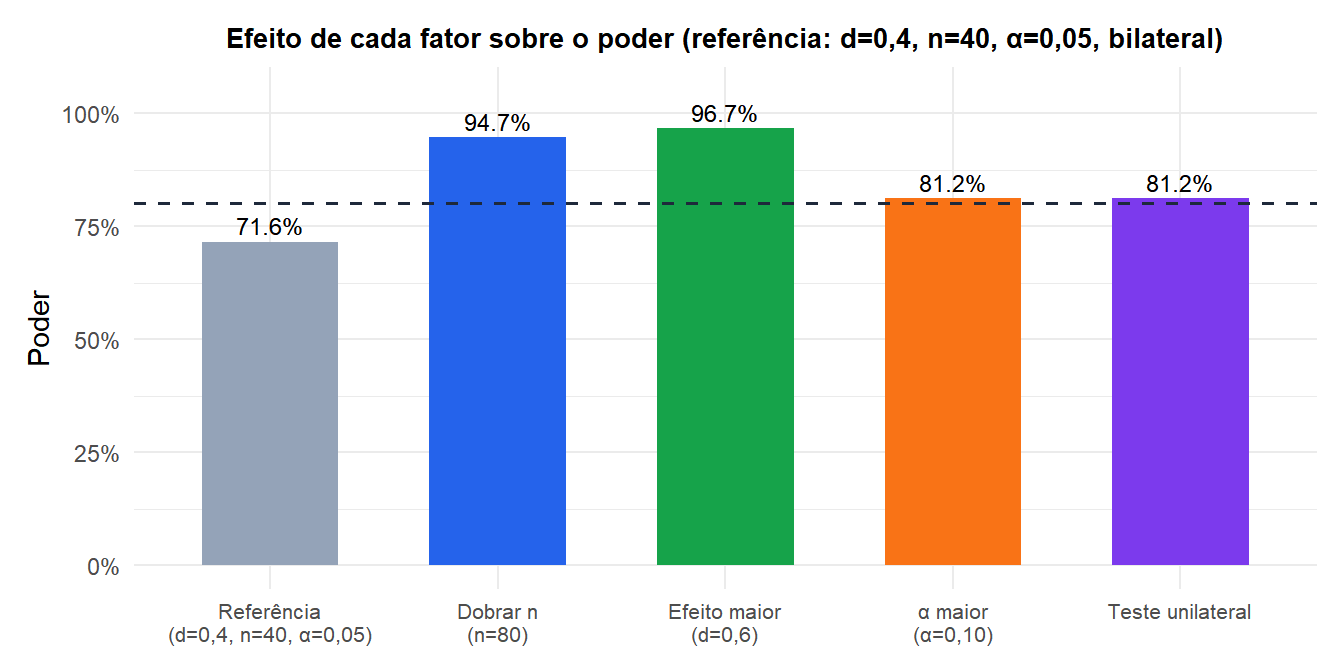
Dobrar \(n\) é a palanca mais confiável. Mudar para um teste unilateral dá um aumento moderado, mas requer justificativa. Aumentar \(\alpha\) troca erro tipo I por poder.
💡 Diretrizes práticas para a análise de poder
- Busque um poder \(\geq 0{,}80\) para estudos exploratórios, \(\geq 0{,}90\) para ensaios confirmatórios.
- Se você não conseguir alcançar 80% de poder com um \(n\) viável, reconsidere se o estudo vale a pena ser realizado: um estudo com pouco poder provavelmente não será informativo.
- No R, o pacote
pwrfornece cálculos de poder para todos os testes comuns:pwr.t.test(),pwr.p.test(),pwr.chisq.test(), etc. - Reporte o tamanho de efeito e o \(\sigma\) assumidos no cálculo de poder: os revisores precisam avaliar se suas suposições eram razoáveis.
- Se um resultado significativo for obtido em um estudo com pouco poder, a estimativa do tamanho de efeito provavelmente está inflada (maldição do vencedor). Replique antes de agir com base nela.

