Tipos de erros em estatística
Todo teste de hipóteses pode cometer dois tipos de erro: rejeitar uma hipótese nula verdadeira (erro tipo I) ou não rejeitar uma hipótese nula falsa (erro tipo II). Entender esses erros, suas probabilidades e a compensação entre eles é essencial para planejar e interpretar testes estatísticos corretamente.
Definição
Ao tomar uma decisão em um teste de hipóteses, estamos comparando nossa conclusão com a verdade desconhecida. Quatro resultados são possíveis:
| \(H_0\) é verdadeira | \(H_0\) é falsa | |
|---|---|---|
| Rejeitar \(H_0\) | Erro tipo I (\(\alpha\)) | Decisão correta (poder \(= 1-\beta\)) |
| Não rejeitar \(H_0\) | Decisão correta | Erro tipo II (\(\beta\)) |
- Erro tipo I (falso positivo)
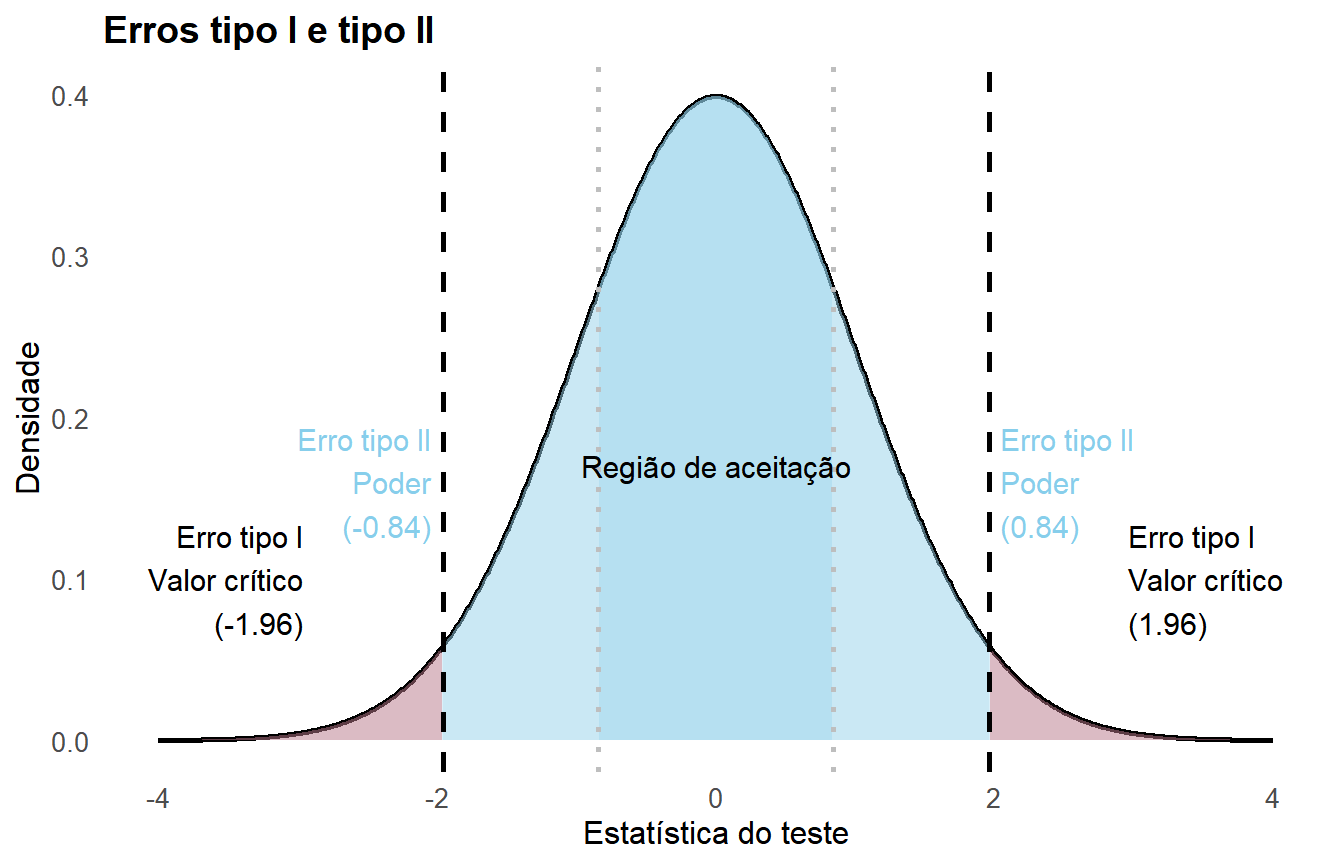
Um erro tipo I ocorre quando \(H_0\) é rejeitada mesmo sendo verdadeira. A probabilidade desse erro é \(\alpha\), o nível de significância. Ao fixar \(\alpha = 0{,}05\), aceitamos 5% de chance de rejeitar incorretamente uma hipótese nula verdadeira.
- Erro tipo II (falso negativo)
Um erro tipo II ocorre quando não rejeitamos \(H_0\) mesmo sendo falsa. Sua probabilidade é \(\beta\). O poder do teste é \(1 - \beta\): a probabilidade de detectar corretamente um efeito real. Uma meta comum é poder \(= 0{,}80\).
Exemplos do mundo real
- Diagnóstico médico
\(H_0\): o paciente não tem a doença. \(H_1\): o paciente tem a doença.
- Erro tipo I: o teste indica que o paciente tem a doença quando não tem (falso positivo). Consequência: ansiedade desnecessária, testes adicionais ou tratamento prejudicial.
- Erro tipo II: o teste indica que o paciente está saudável quando na verdade tem a doença (falso negativo). Consequência: atraso no tratamento, progressão da doença.
Em programas de triagem de doenças graves, minimizar os erros tipo II costuma ser prioritário: deixar passar um caso real pode ser fatal, enquanto um falso positivo leva apenas a um teste confirmatório.
- Controle de qualidade
\(H_0\): o lote de produção atende aos padrões de qualidade. \(H_1\): o lote é defeituoso.
- Erro tipo I: rejeitar um lote bom (falso alarme). Consequência: desperdício desnecessário e custo de produção.
- Erro tipo II: aceitar um lote defeituoso. Consequência: produtos defeituosos chegam aos clientes.
O equilíbrio entre os dois custos depende do produto. Para componentes críticos de segurança (peças de aeronaves, dispositivos médicos), minimizar erros tipo II justifica taxas de erro tipo I mais altas.
- Sistema jurídico
\(H_0\): o réu é inocente. \(H_1\): o réu é culpado.
- Erro tipo I: condenar uma pessoa inocente. O critério “além de qualquer dúvida razoável” fixa um \(\alpha\) muito baixo.
- Erro tipo II: absolver uma pessoa culpada.
A maioria dos sistemas jurídicos aceita deliberadamente taxas de erro tipo II mais altas para minimizar condenações injustas.
A compensação e como gerenciá-la
Para um tamanho de amostra fixo, reduzir \(\alpha\) aumenta \(\beta\) (e reduz o poder). A única forma de reduzir ambos simultaneamente é aumentar \(n\).
O poder de um teste depende de quatro fatores:
- \(\alpha\): um \(\alpha\) maior aumenta o poder, mas também o risco de erro tipo I.
- \(n\): amostras maiores sempre aumentam o poder.
- Tamanho de efeito \(\delta\): diferenças reais maiores são mais fáceis de detectar.
- \(\sigma\): populações menos variáveis dão maior poder.
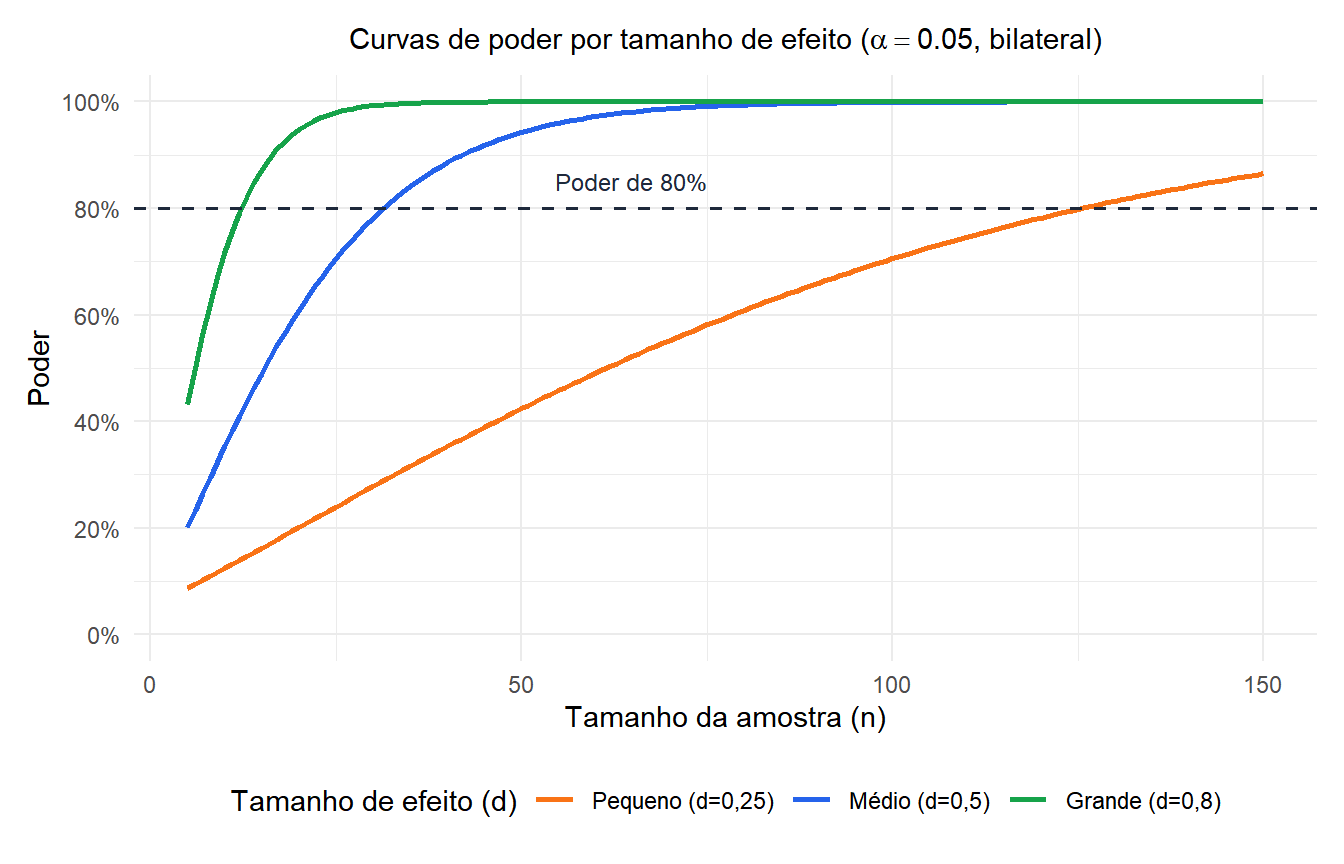
Para efeitos pequenos (\(d = 0{,}25\)), alcançar 80% de poder exige 125 observações. Para efeitos médios (\(d = 0{,}5\)), cerca de 35 bastam. Para efeitos grandes (\(d = 0{,}8\)), menos de 15 são suficientes. É por isso que estudos com pouco poder e amostras pequenas frequentemente não detectam efeitos reais.
⚠️ Estudos com pouco poder: um problema sistêmico
Muitos estudos publicados têm pouco poder: usam tamanhos de amostra pequenos demais para detectar de forma confiável os efeitos que afirmam estudar. Um estudo com pouco poder que encontra um resultado significativo pode estar detectando um efeito espuriamente grande (devido à variabilidade amostral), enquanto um que não encontra significância pode simplesmente ter sido incapaz de detectar um efeito real, mas pequeno.
Sempre calcule o poder antes de coletar os dados. Um estudo com poder abaixo de 0,50 provavelmente não será informativo, independentemente de seu resultado.
💡 Diretrizes práticas para gerenciar os erros
- Fixe \(\alpha\) antes de coletar os dados, com base no custo de um erro tipo I no seu contexto.
- Almeje um poder \(\geq 0{,}80\) (80%), idealmente 0,90 para estudos confirmatórios.
- Use a análise de poder para determinar \(n\) antes de iniciar a coleta de dados.
- Quando o custo de um erro tipo II for alto (triagem médica, testes de segurança), use um \(\alpha\) maior ou um \(n\) maior para aumentar o poder.
- Reporte tanto \(\alpha\) quanto o poder alcançado para que os leitores possam avaliar a confiabilidade das suas conclusões.

