Análise de componentes principais (PCA)
A Análise de Componentes Principais (PCA) encontra uma representação de dimensão menor dos dados que captura o máximo de variância possível. Ela faz isso girando o sistema de coordenadas para alinhá-lo com as direções de máxima variância nos dados. O resultado é um conjunto de componentes não correlacionadas, ordenadas pela quantidade de variância que explicam. Para dados categóricos organizados como uma tabela de contingência, a mesma ideia se aplica por meio da análise de correspondência.
O que o PCA faz geometricamente
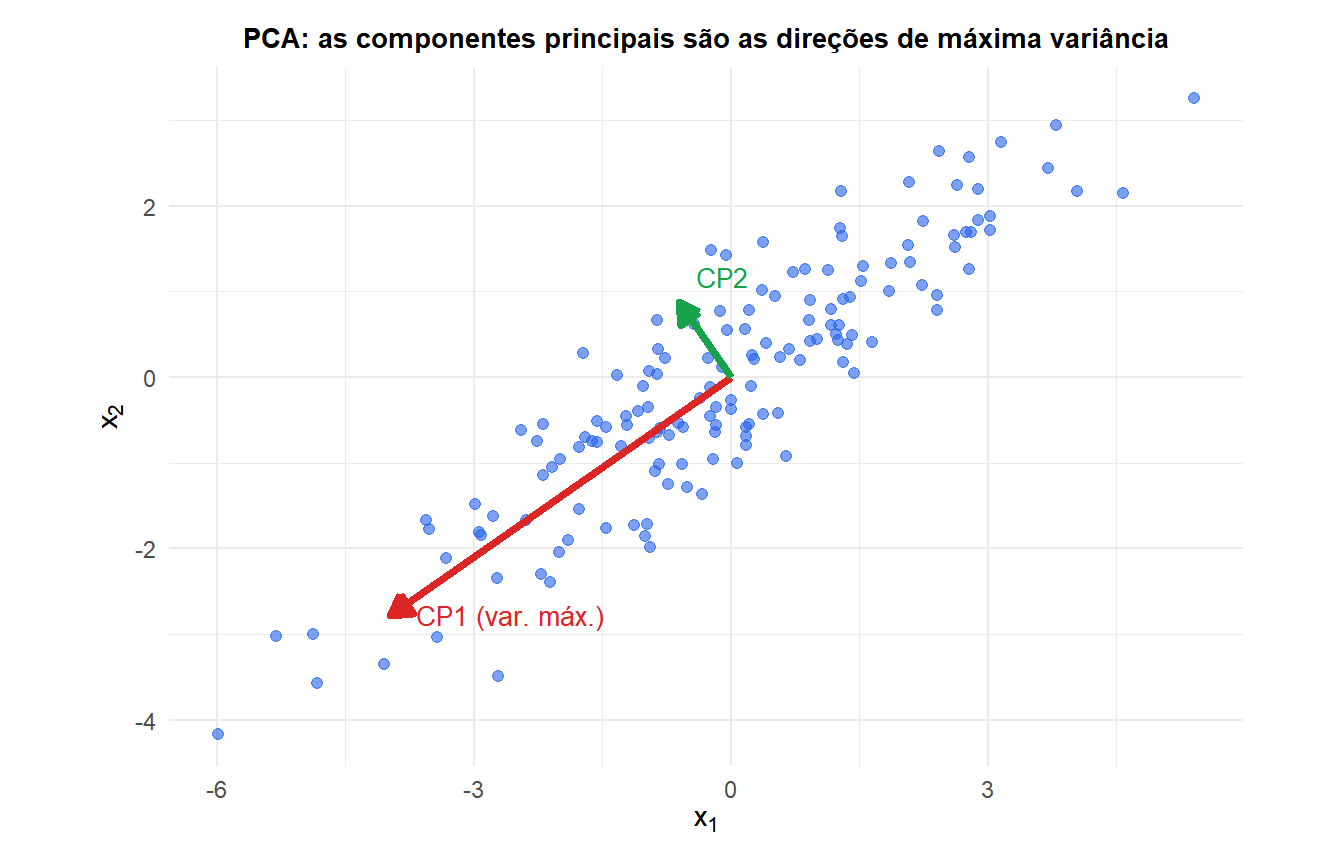
Dadas \(n\) observações de \(p\) variáveis, o PCA encontra uma sequência de direções ortogonais \(\mathbf{v}_1, \mathbf{v}_2, \ldots, \mathbf{v}_p\) (as componentes principais) tais que:
- \(\mathbf{v}_1\) é a direção de máxima variância nos dados.
- \(\mathbf{v}_2\) é a direção de máxima variância no subespaço ortogonal a \(\mathbf{v}_1\).
- E assim por diante.
A projeção dos dados sobre \(\mathbf{v}_k\) dá os escores \(\mathbf{z}_k = \mathbf{X}\mathbf{v}_k\): as coordenadas de cada observação no novo sistema de coordenadas. As direções \(\mathbf{v}_k\) são chamadas de cargas (loadings): elas dizem o quanto cada variável original contribui para cada componente.
Derivação matemática
Centralize os dados: \(\tilde{\mathbf{X}} = \mathbf{X} - \bar{\mathbf{X}}\). A matriz de covariância amostral é:
\[\mathbf{S} = \frac{1}{n-1}\tilde{\mathbf{X}}^T\tilde{\mathbf{X}}\]
As componentes principais são os autovetores de \(\mathbf{S}\):
\[\mathbf{S}\mathbf{v}_k = \lambda_k \mathbf{v}_k\]
em que \(\lambda_k\) é a variância explicada pela \(k\)-ésima componente. Os autovetores são ortonormais (\(\mathbf{v}_j^T\mathbf{v}_k = 0\) para \(j \neq k\), \(\|\mathbf{v}_k\|=1\)) e ordenados por autovalor decrescente \(\lambda_1 \geq \lambda_2 \geq \cdots \geq \lambda_p \geq 0\).
Conexão com a SVD: a decomposição em valores singulares de \(\tilde{\mathbf{X}} = \mathbf{U}\mathbf{D}\mathbf{V}^T\) dá imediatamente:
\[\tilde{\mathbf{X}}^T\tilde{\mathbf{X}} = \mathbf{V}\mathbf{D}^2\mathbf{V}^T\]
Os vetores singulares direitos \(\mathbf{V}\) são as cargas das componentes principais, e os valores singulares \(d_k\) se relacionam com os autovalores via \(\lambda_k = d_k^2/(n-1)\). Calcular o PCA via SVD é numericamente mais estável do que a autodecomposição de \(\mathbf{S}\) quando \(p\) é grande ou algumas variáveis são quase colineares.
PCA de covariância vs correlação
O PCA sobre a matriz de covariância preserva a escala original: variáveis com grande variância dominam as componentes. O PCA sobre a matriz de correlação (equivalente a padronizar cada variável para variância unitária primeiro) dá peso igual a todas as variáveis, independentemente de sua escala.
Sempre padronize quando as variáveis são medidas em unidades diferentes (por exemplo, altura em cm e peso em kg). Quando todas as variáveis estão na mesma escala (por exemplo, contagens de expressão génica), o PCA de covariância é apropriado e preserva diferenças significativas na variância.
Escolhendo o número de componentes
A proporção de variância explicada pela componente \(k\):
\[\text{PVE}_k = \frac{\lambda_k}{\sum_{j=1}^p \lambda_j}\]
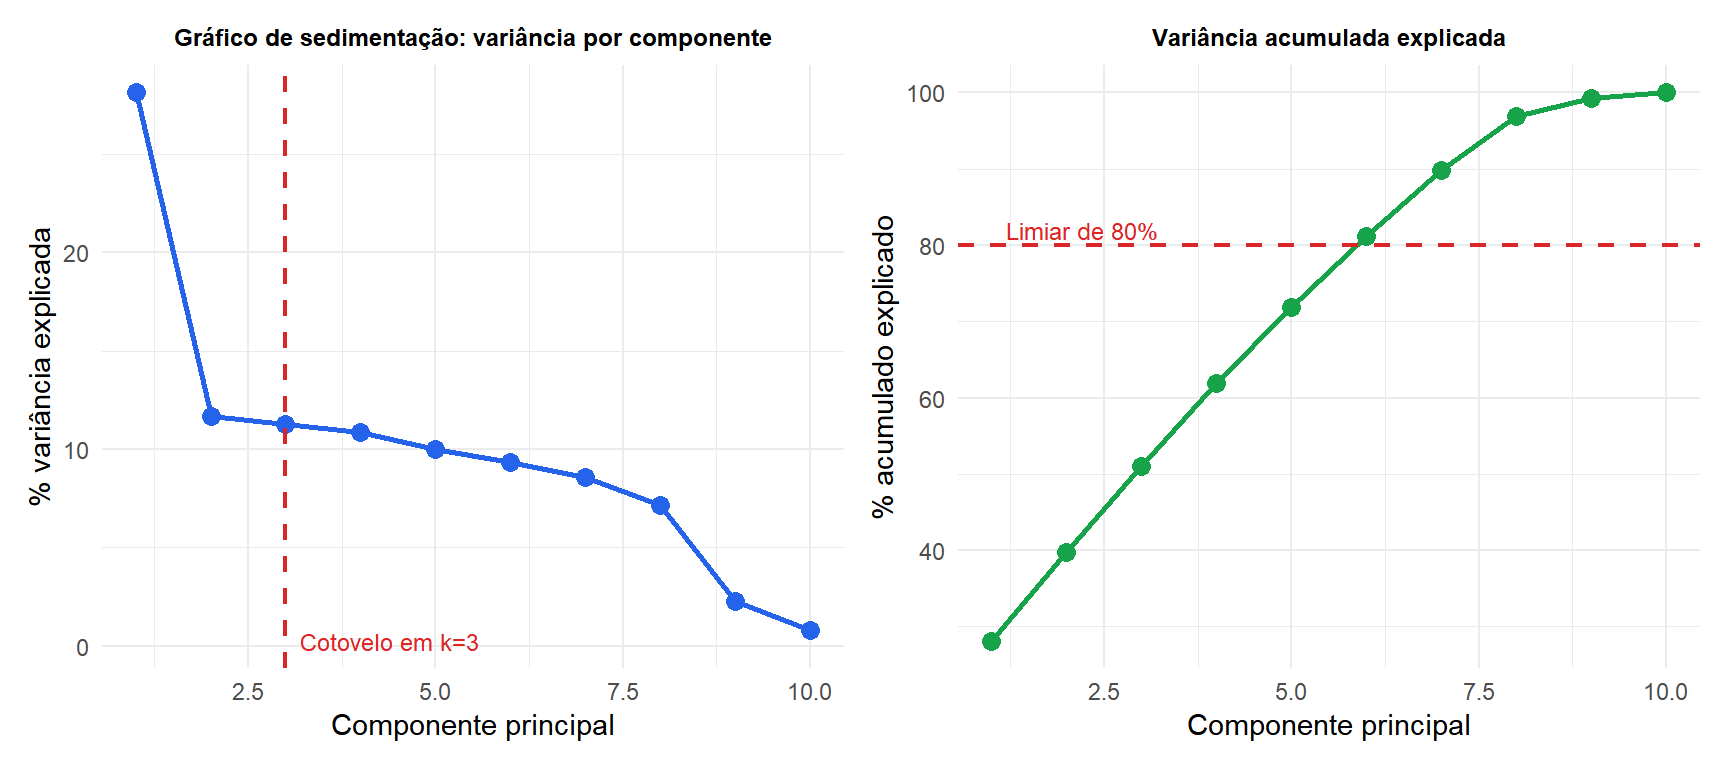
Gráfico de sedimentação (scree plot): plote \(\lambda_k\) (ou \(\text{PVE}_k\)) vs \(k\). Procure o “cotovelo” em que a curva se achata. Componentes à esquerda do cotovelo capturam a maior parte da estrutura; as à direita capturam ruído.
Critério de Kaiser: retenha componentes com \(\lambda_k > 1\) (para PCA de correlação: componentes que explicam mais do que uma única variável original).
Limiar de variância acumulada: retenha componentes suficientes para explicar 80-90% da variância total.
O biplot
Um biplot sobrepõe os escores (observações no espaço das componentes) e as cargas (variáveis originais como setas) no mesmo gráfico. Ele permite a interpretação simultânea de ambos:
- Observações próximas entre si têm perfis semelhantes.
- Variáveis (setas) apontando na mesma direção são positivamente correlacionadas; em direções opostas, negativamente correlacionadas; setas perpendiculares são não correlacionadas.
- O comprimento da seta indica quanto da variância da variável é capturado pelas duas componentes mostradas.
- Uma observação próxima de uma seta tem escore alto nessa variável.
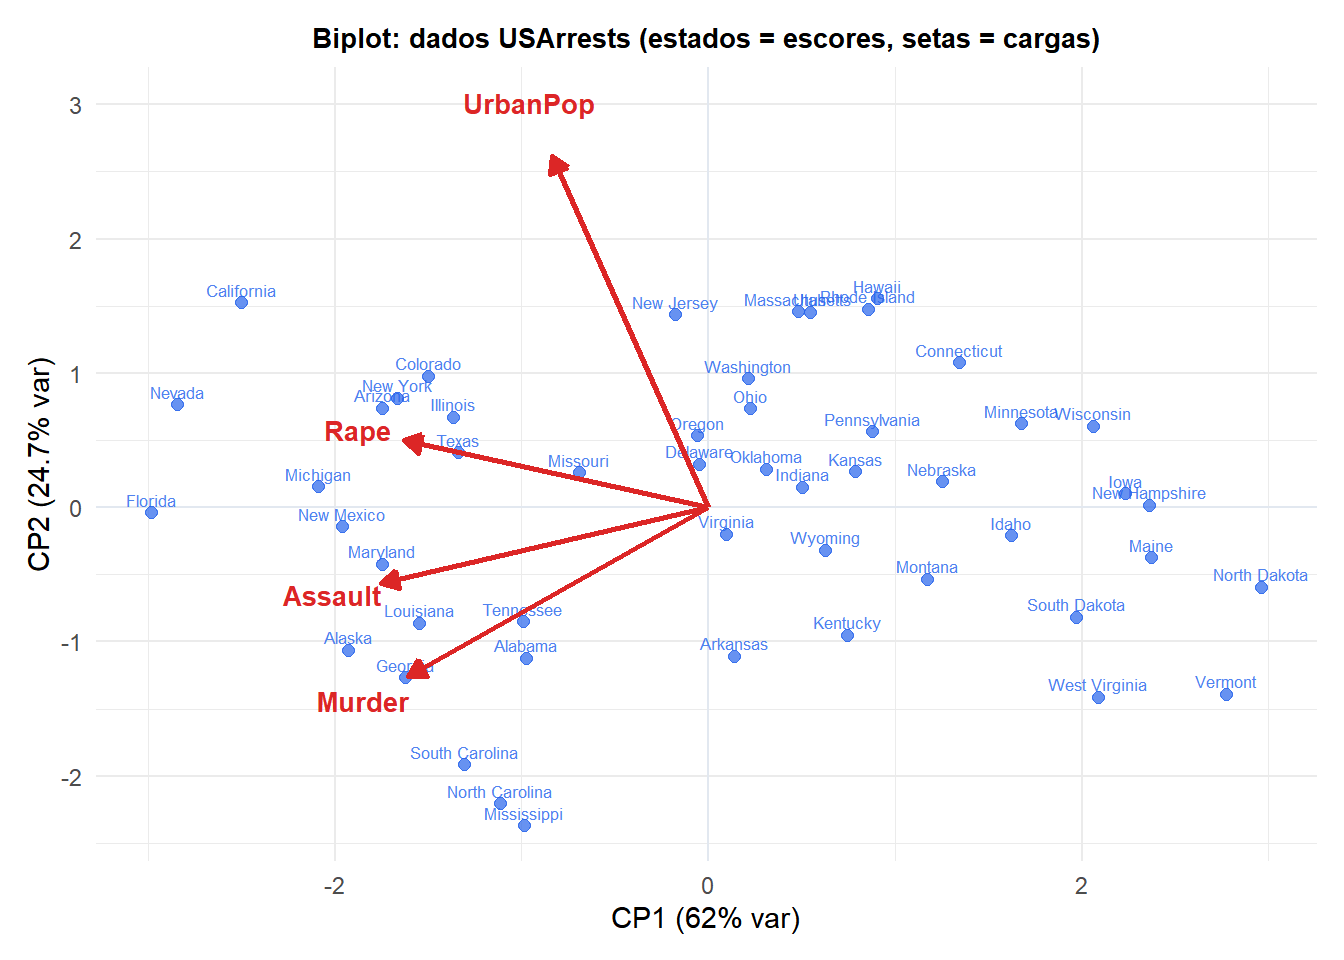
A CP1 (horizontal) separa estados de alta criminalidade (direita) dos de baixa criminalidade (esquerda): Murder, Assault e Rape todos apontam para a direita, o que significa que a CP1 é um índice geral de criminalidade. A CP2 (vertical) é impulsionada principalmente por UrbanPop: estados com alta população urbana têm escore alto na CP2, independentemente das taxas de criminalidade.
PCA vs LDA
Tanto o PCA quanto a LDA projetam os dados em um espaço de dimensão menor, mas com objetivos diferentes:
- PCA: não supervisionado. Maximiza a variância total dos dados projetados. Ignora os rótulos de classe. Útil para visualização, redução de ruído e pré-processamento.
- LDA: supervisionada. Maximiza a variância entre classes em relação à variância dentro da classe. Usa os rótulos de classe. Útil quando o objetivo é a classificação ou encontrar direções que separam classes conhecidas.
Ambos também são estritamente lineares: quando a estrutura nos dados é genuinamente não linear, o t-SNE e o UMAP são as alternativas não lineares padrão para visualização. Se as direções de máxima variância forem as mesmas que as direções que separam as classes, o PCA e a LDA concordam. Quando a direção mais variável é ruído dentro da classe (por exemplo, indivíduos variam muito dentro de cada classe, mas as classes diferem em uma direção de baixa variância), o PCA não encontra a estrutura discriminante e a LDA é necessária.
⚠️ O PCA não garante componentes interpretáveis
Cada componente principal é uma combinação linear de todas as variáveis originais. Mesmo que a CP1 capture 60% da variância, ela pode ser uma média ponderada de 20 variáveis com cargas semelhantes: não há garantia de que corresponda a um conceito científico significativo.
Técnicas como o PCA esparso (impõe penalidade L1 sobre as cargas para forçar a maioria a zero) e a rotação varimax (gira as componentes para maximizar a simplicidade da estrutura de cargas) podem melhorar a interpretabilidade, ao custo de perder a propriedade de otimalidade de variância máxima.
💡 PCA em R
# Fit PCA
pca <- prcomp(X, center=TRUE, scale.=TRUE)
summary(pca)            # variance explained per component
pca$rotation            # loadings (eigenvectors)
pca$x                   # scores (projected data)

# Scree plot
plot(pca, type="l")

# Biplot
biplot(pca, scale=0)

# Choose number of components
cumsum(pca$sdev^2) / sum(pca$sdev^2)  # cumulative PVE

# Project new data onto existing PCA
predict(pca, newdata=X_new)

# Sparse PCA for interpretable loadings
library(sparsepca)
spca <- spca(X, k=3, alpha=1e-3, beta=1e-3)
