Regressão logística
A regressão logística modela a probabilidade de um resultado binário em função de preditores usando a função logística (sigmoide). Diferentemente da regressão linear, ela é estimada por máxima verossimilhança, não por MQO. É a referência padrão para classificação binária e a base das redes neurais, junto com alternativas mais antigas, como a análise discriminante.
O modelo
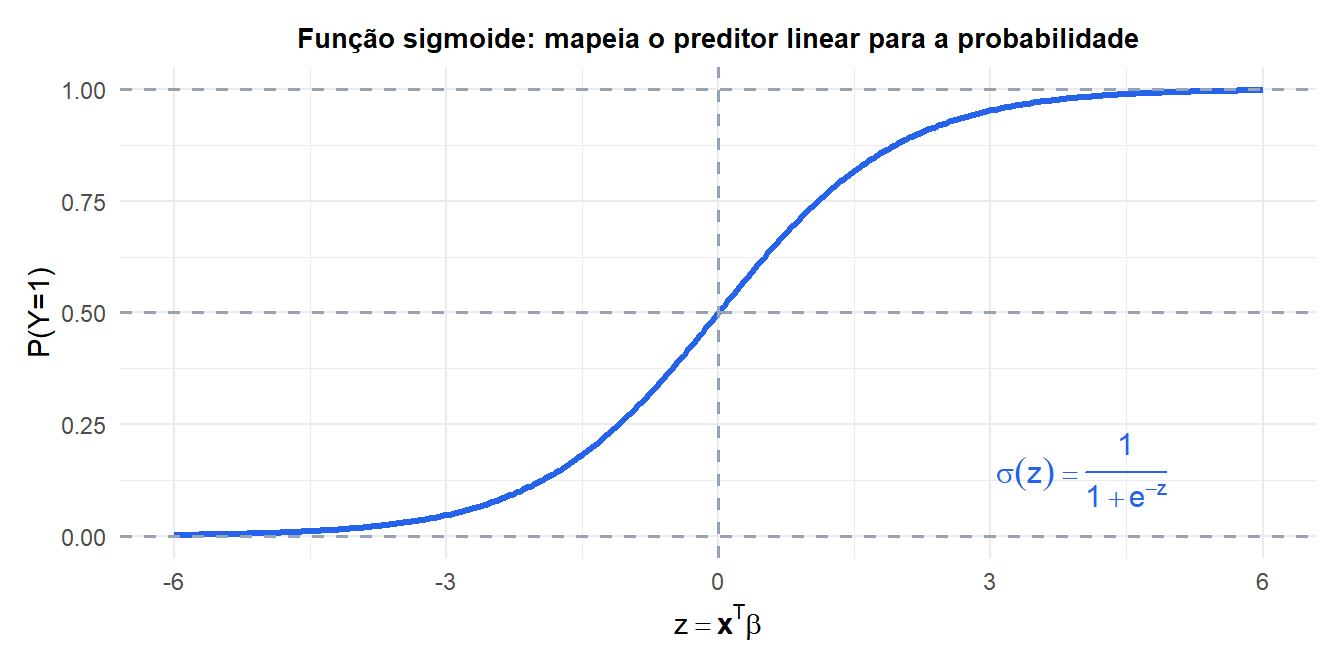
A regressão linear aplicada diretamente a um resultado binário \(y \in \{0,1\}\) pode produzir probabilidades previstas fora de \([0,1]\). A regressão logística corrige isso passando o preditor linear pela função sigmoide:
\[P(Y=1 \mid \mathbf{x}) = \sigma(\mathbf{x}^T\boldsymbol{\beta}) = \frac{1}{1 + e^{-(\beta_0 + \beta_1 x_1 + \cdots + \beta_k x_k)}}\]
A sigmoide mapeia \((-\infty, +\infty)\) para \((0,1)\) e tem formato de S: é quase linear no meio e satura em 0 e 1 nos extremos.
De forma equivalente, o log-odds (logit) da probabilidade é linear nos preditores:
\[\log\frac{P(Y=1)}{P(Y=0)} = \beta_0 + \beta_1 x_1 + \cdots + \beta_k x_k\]
Estimação por máxima verossimilhança
Para o método geral por trás disso, veja o post dedicado à estimação de máxima verossimilhança.
Como \(y_i \in \{0,1\}\), cada observação segue uma distribuição de Bernoulli com \(p_i = \sigma(\mathbf{x}_i^T\boldsymbol{\beta})\). A log-verossimilhança é:
\[\ell(\boldsymbol{\beta}) = \sum_{i=1}^n \left[y_i \log p_i + (1-y_i)\log(1-p_i)\right]\]
Essa é a entropia cruzada binária (com o sinal invertido). Não existe solução em forma fechada: \(\nabla \ell = 0\) é resolvido iterativamente por IRLS (Mínimos Quadrados Iterativamente Reponderados) ou ascensão de gradiente. Cada passo do IRLS é um problema de MQO ponderado em que os pesos são \(w_i = p_i(1-p_i)\) (mais altos perto de \(p=0{,}5\), mais baixos perto de 0 ou 1).
A atualização de Newton-Raphson:
\[\boldsymbol{\beta}^{(t+1)} = \boldsymbol{\beta}^{(t)} + (\mathbf{X}^T\mathbf{W}^{(t)}\mathbf{X})^{-1}\mathbf{X}^T(\mathbf{y} - \mathbf{p}^{(t)})\]
Interpretando coeficientes: odds ratios
Um aumento de uma unidade em \(x_j\) multiplica o odds por \(e^{\beta_j}\):
\[\frac{P(Y=1)/(1-P(Y=1))}{P(Y=1|x_j+1)/(1-P(Y=1|x_j+1))} = e^{\beta_j}\]
- \(e^{\beta_j} > 1\): o odds de \(Y=1\) aumenta com \(x_j\).
- \(e^{\beta_j} < 1\): o odds diminui.
- \(e^{\beta_j} = 1\) (\(\beta_j = 0\)): \(x_j\) não tem efeito.
Intervalos de confiança para o odds ratio: \(\left(e^{\hat{\beta}_j - 1{,}96\cdot\text{EP}},\; e^{\hat{\beta}_j + 1{,}96\cdot\text{EP}}\right)\).
Exemplo: previsão de risco de doença
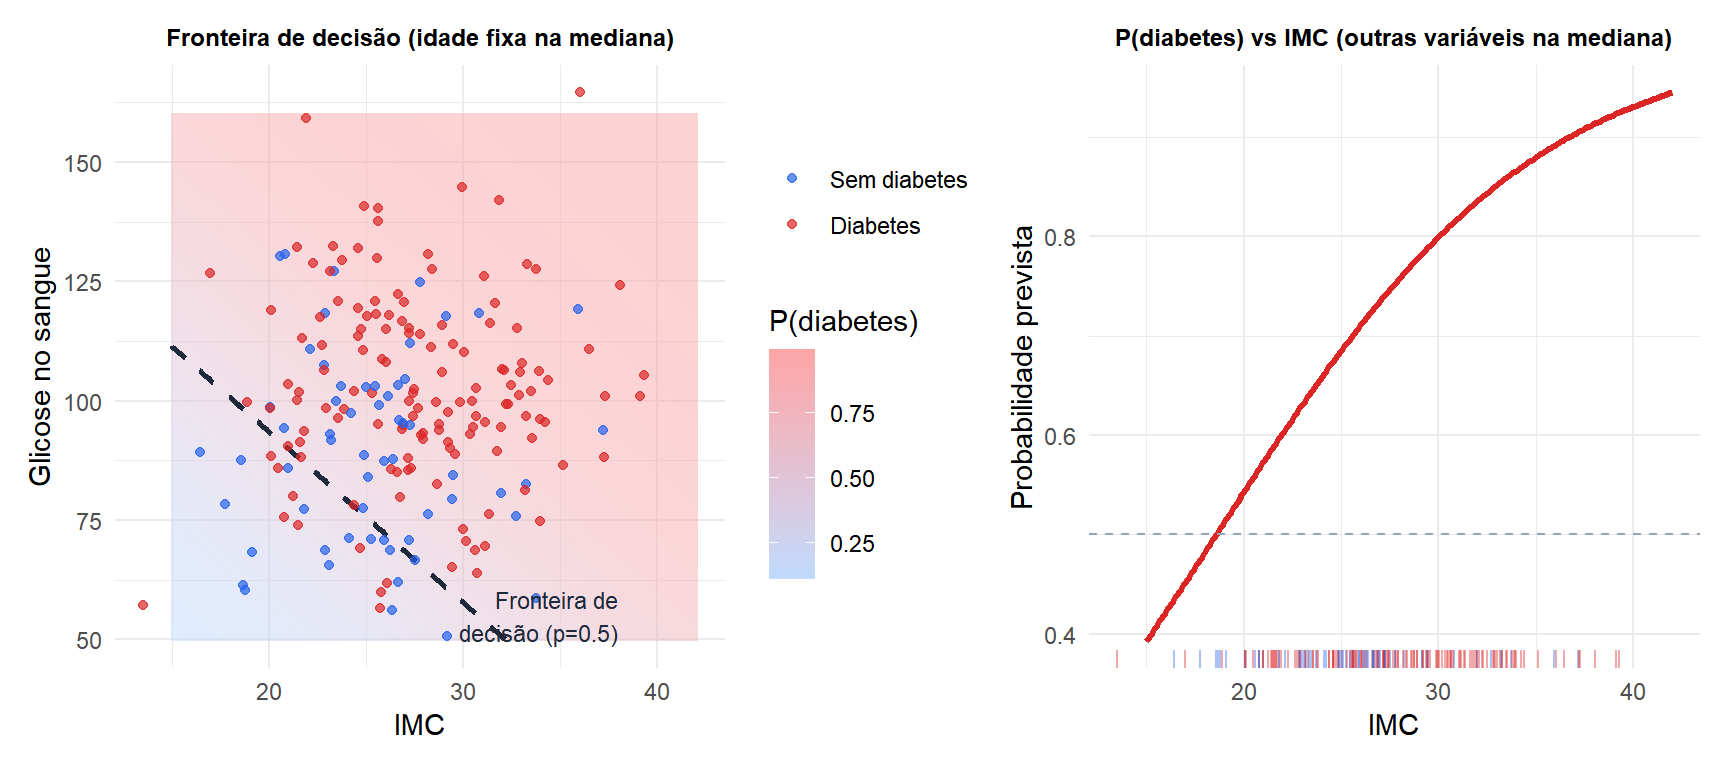
Preveja se um paciente tem diabetes com base na idade, IMC e nível de glicose no sangue.
Avaliação do modelo
Um limiar de probabilidade (normalmente 0,5) converte probabilidades em previsões de classe. A matriz de confusão resume os resultados:
| Previsto 0 | Previsto 1 | |
|---|---|---|
| Real 0 | TN | FP |
| Real 1 | FN | TP |
Métricas-chave: acurácia \((TP+TN)/n\), sensibilidade/recall \(TP/(TP+FN)\), especificidade \(TN/(TN+FP)\), precisão \(TP/(TP+FP)\), F1 score.
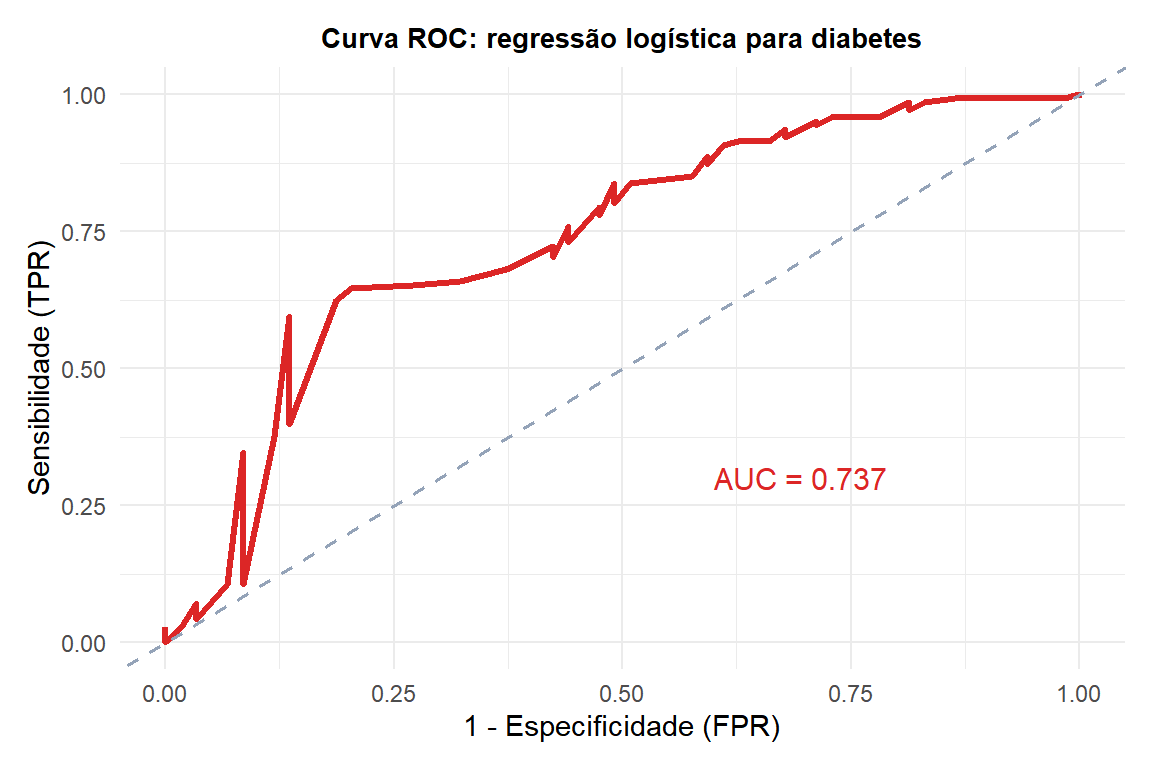
A curva ROC plota a sensibilidade vs (1-especificidade) em todos os limiares. A AUC (área sob a curva ROC) mede a capacidade de discriminação geral: AUC = 0,5 é aleatório; AUC = 1 é perfeito.
Extensão para multiclasse: regressão softmax
Para \(K > 2\) classes, a regressão logística se generaliza para a regressão softmax (multinomial):
\[P(Y=k \mid \mathbf{x}) = \frac{e^{\mathbf{x}^T\boldsymbol{\beta}_k}}{\sum_{j=1}^K e^{\mathbf{x}^T\boldsymbol{\beta}_j}}\]
Cada classe \(k\) recebe seu próprio vetor de coeficientes \(\boldsymbol{\beta}_k\). A função softmax garante que todas as \(K\) probabilidades somem 1. Uma classe é tomada como referência (seu \(\boldsymbol{\beta}\) é fixado em zero) para garantir a identificabilidade.
⚠️ A regressão logística falha quando as classes são perfeitamente separáveis
Se uma fronteira linear separa perfeitamente as duas classes (separação completa), o MLE não existe: a log-verossimilhança não tem máximo, e os coeficientes divergem para \(\pm\infty\). Isso é um sinal de alerta de que o modelo está sofrendo overfitting e vai generalizar mal.
Sintomas: coeficientes muito grandes, erros padrão enormes, probabilidades previstas próximas de zero em todos os lugares, exceto na fronteira de decisão. Soluções: regressão logística penalizada por Ridge (glmnet), regressão com redução de viés de Firth (pacote logistf), ou coletar mais dados.
💡 Regressão logística em R
# Fit logistic regression
fit <- glm(y ~ x1 + x2 + x3, data=df, family=binomial)
summary(fit)
exp(coef(fit))          # odds ratios
exp(confint(fit))       # CI for odds ratios

# Predictions
predict(fit, type="response")   # probabilities
predict(fit, type="link")       # log-odds

# Multinomial logistic regression
library(nnet)
fit_multi <- multinom(y ~ x1 + x2, data=df)

# Ridge-penalized (handles separation)
library(glmnet)
glmnet(X, y, family="binomial", alpha=0)
