Estimação de máxima verossimilhança
A estimação de máxima verossimilhança (MLE, do inglês maximum likelihood estimation) é o método mais usado para estimar os parâmetros de uma distribuição: ela escolhe os valores de parâmetros que tornam os dados que você realmente observou tão prováveis quanto possível. Ela fundamenta muito mais deste site do que pode parecer: a regressão logística é ajustada por MLE, não minimizando o erro quadrático.
A função de verossimilhança
Para observações independentes e identicamente distribuídas \(x_1, x_2, \ldots, x_n\) de uma distribuição com parâmetro \(\theta\) e função de densidade ou massa \(f(x;\theta)\), a verossimilhança é a probabilidade conjunta dos dados observados, vista como função de \(\theta\) com os dados mantidos fixos:
\[L(\theta) = \prod_{i=1}^n f(x_i; \theta)\]
Essa é uma inversão conceitual em relação a como a probabilidade normalmente funciona. Uma função de probabilidade pergunta: dados esses parâmetros, qual a probabilidade desses dados? Uma função de verossimilhança pergunta o inverso: dados esses dados, como sua probabilidade muda conforme os parâmetros variam? A estimativa de máxima verossimilhança \(\hat\theta\) é o valor de \(\theta\) que maximiza \(L(\theta)\).
Por que a log-verossimilhança
Produtos de muitas probabilidades pequenas causam underflow numérico e são difíceis de derivar. Tomar logaritmos transforma o produto em uma soma sem mudar onde está o máximo, já que o logaritmo é uma função estritamente crescente:
\[\ell(\theta) = \log L(\theta) = \sum_{i=1}^n \log f(x_i; \theta)\]
Na prática, sempre se maximiza \(\ell(\theta)\), nunca \(L(\theta)\) diretamente.
Exemplo resolvido 1: MLE para uma proporção de Bernoulli
O caso mais simples possível, uma moeda, já mostra toda a mecânica: escrever a verossimilhança, derivar e resolver.
Uma moeda é lançada 10 vezes, registrando 1 para cara e 0 para coroa: \(1,0,1,1,0,1,1,1,0,1\) (7 caras em 10). Para dados Bernoulli(\(p\)) i.i.d., a verossimilhança e a log-verossimilhança são:
\[L(p) = p^{\sum x_i}(1-p)^{n-\sum x_i}, \qquad \ell(p) = \Big(\sum x_i\Big)\log p + \Big(n-\sum x_i\Big)\log(1-p)\]
Tome a derivada em relação a \(p\) e iguale a zero:
\[\frac{d\ell}{dp} = \frac{\sum x_i}{p} - \frac{n - \sum x_i}{1-p} = 0\]
Resolvendo, obtém-se o estimador de máxima verossimilhança:
\[\hat{p}_{MLE} = \frac{\sum x_i}{n}\]
Para esses dados: \(n=10\), \(\sum x_i = 7\), então \(\hat p_{MLE} = 7/10 = 0{,}7\). Essa é exatamente a proporção amostral: o estimador “óbvio” acaba sendo o estimador de máxima verossimilhança.

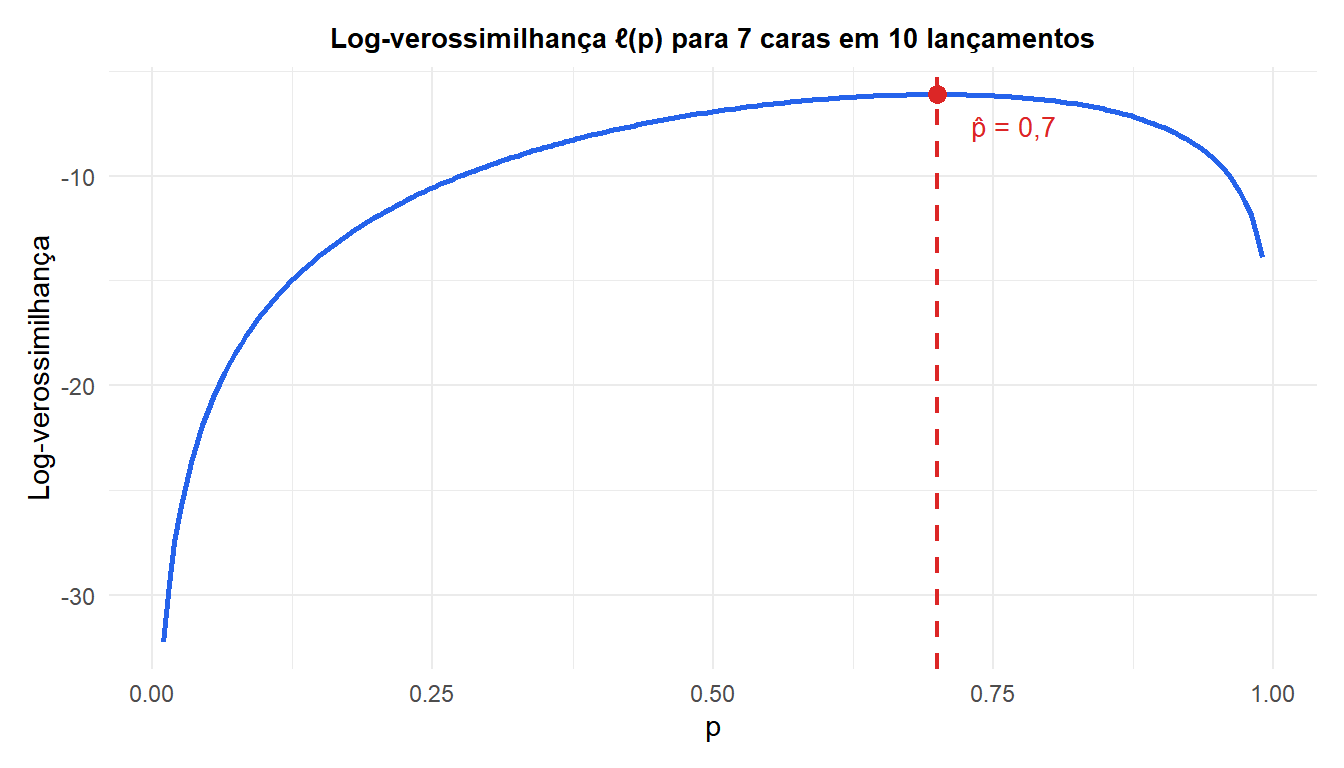
A curva atinge seu pico exatamente em \(\hat p = 0{,}7\): nenhum outro valor de \(p\) torna essa sequência específica de 7 caras e 3 coroas mais provável.
Exemplo resolvido 2: MLE para uma distribuição Normal
Com dois parâmetros para estimar de uma vez, a mesma lógica de maximização produz uma fórmula familiar para a média e uma fórmula menos familiar e tendenciosa para a variância.
Dez medições: \(4{,}2, 5{,}1, 3{,}8, 4{,}9, 5{,}5, 4{,}4, 4{,}7, 5{,}0, 4{,}1, 4{,}6\). Para dados \(N(\mu, \sigma^2)\) i.i.d., maximizar a log-verossimilhança em relação a \(\mu\) e \(\sigma^2\) dá:
\[\hat\mu_{MLE} = \bar{x} = \frac{1}{n}\sum x_i \qquad \hat\sigma^2_{MLE} = \frac{1}{n}\sum (x_i - \bar{x})^2\]
Calculado sobre os dados: \(n=10\), \(\hat\mu_{MLE} = 4{,}63\), \(\hat\sigma^2_{MLE} = 0{,}2401\), então \(\hat\sigma_{MLE} = 0{,}49\). A log-verossimilhança nesse máximo é \(\ell(\hat\mu,\hat\sigma^2) = -7{,}056\).
⚠️ A variância do MLE é tendenciosa: ela divide por n, não por n-1
\(\hat\sigma^2_{MLE} = 0{,}2401\) divide a soma dos desvios ao quadrado por \(n=10\). A conhecida variância amostral não tendenciosa do post sobre desvio padrão e variância divide, em vez disso, por \(n-1=9\), dando \(s^2 = 0{,}2668\) nos mesmos dados, visivelmente maior.
Estimadores de máxima verossimilhança não são automaticamente não tendenciosos. Maximizar a verossimilhança e minimizar o viés são objetivos diferentes que coincidem para alguns parâmetros, como a média, mas não para outros, como a variância. Veja o post sobre o que é um estimador para o quadro completo de não tendenciosidade/consistência/eficiência com o qual isso se conecta. Na prática, para amostras genuinamente pequenas, a versão não tendenciosa com \(n-1\) geralmente é preferida para a variância; o viés da versão MLE diminui conforme \(n\) cresce, e as duas versões convergem.
MLE e mínimos quadrados: quando coincidem
Para um modelo de regressão linear com erros normalmente distribuídos, maximizar a verossimilhança em relação aos coeficientes dá exatamente as mesmas estimativas que os mínimos quadrados ordinários. É por isso que a regressão OLS pode ser justificada das duas formas, como minimizar o erro quadrático ou como maximizar a verossimilhança sob erros normais: nesse caso específico, são o mesmo problema de otimização.
Para modelos em que a resposta não é normalmente distribuída, resultados binários, contagens, e assim por diante, os mínimos quadrados não se aplicam mais de forma limpa, e o MLE é usado diretamente em seu lugar. É exatamente por isso que a regressão logística é ajustada por MLE, em vez de minimizar o erro quadrático.
Propriedades do MLE para amostras grandes
Sob condições de regularidade padrão, conforme \(n \to \infty\) o estimador de máxima verossimilhança é:
- Consistente: converge para o verdadeiro valor do parâmetro.
- Assintoticamente não tendencioso: qualquer viés em amostra finita diminui em direção a zero.
- Assintoticamente normal: sua distribuição amostral se aproxima de uma distribuição normal.
- Assintoticamente eficiente: atinge a menor variância possível entre os estimadores consistentes, o limite inferior de Cramér-Rao.
Essas são garantias para amostras grandes, não para amostras finitas. É exatamente por isso que o MLE de Bernoulli acima é não tendencioso para qualquer \(n\), enquanto o MLE da variância Normal é tendencioso para qualquer \(n\) finito: ambas as propriedades são consistentes com a mesma teoria assintótica, que só promete bom comportamento conforme \(n\) cresce. Quando a verossimilhança é difícil de otimizar numericamente, o método dos momentos oferece uma alternativa mais simples e de forma fechada, geralmente menos eficiente, mas um bom ponto de partida.
Executando isso em R
Os dois exemplos resolvidos acima cabem em poucas linhas: o caso de Bernoulli se reduz a uma média, e o caso Normal pode ser resolvido tanto em forma fechada quanto com um otimizador numérico de propósito geral.
# Bernoulli MLE: just the sample proportion
flips <- c(1,0,1,1,0,1,1,1,0,1)
p_hat <- mean(flips)

# Normal MLE via numerical optimization (general-purpose approach)
x <- c(4.2, 5.1, 3.8, 4.9, 5.5, 4.4, 4.7, 5.0, 4.1, 4.6)
neg_loglik <- function(par) {
  mu <- par[1]; sigma <- par[2]
  -sum(dnorm(x, mean = mu, sd = sigma, log = TRUE))
}
fit <- optim(par = c(mean(x), sd(x)), fn = neg_loglik)
fit$par   # matches mean(x) and sqrt(mean((x-mean(x))^2)) exactly

# General-purpose MLE fitting
library(MASS)
fitdistr(x, "normal")
💡 MLE na prática: quase sempre invisível, sempre por baixo dos panos
Na maioria das vezes, você nunca chama um otimizador de MLE diretamente. glm() para a regressão logística, fitdistr(), e inúmeras outras funções do R executam MLE internamente quando reportam coeficientes e erros padrão. Saber isso explica por que essas funções pedem uma família de distribuição (family = binomial, e assim por diante): essa escolha determina a função de verossimilhança que está sendo maximizada. A regressão logística é o lugar onde a maioria dos visitantes deste site vai encontrar o MLE na prática, sem necessariamente dar nome a ele.

