Distribuição normal
A distribuição normal é a distribuição contínua mais importante da estatística. Ela descreve uma enorme variedade de fenômenos naturais e é a distribuição limite de somas e médias de variáveis aleatórias independentes, razão pela qual aparece em todos os lugares.
Definição
Uma variável aleatória \(X\) segue uma distribuição normal com média \(\mu \in \mathbb{R}\) e desvio padrão \(\sigma > 0\), escrita \(X \sim N(\mu, \sigma)\), se sua função de densidade de probabilidade é:
\[f(x) = \frac{1}{\sigma\sqrt{2\pi}}\, e^{-\frac{(x-\mu)^2}{2\sigma^2}}, \quad -\infty < x < \infty\]
A curva tem formato de sino, é simétrica em torno de \(\mu\), e sua dispersão é controlada por \(\sigma\). A área total sob a curva é sempre 1.
⚠️ Notação: N(μ, σ) vs. N(μ, σ²)
Livros-texto diferentes usam convenções diferentes:
- \(N(\mu, \sigma)\): parametrizada pela média e pelo desvio padrão. Comum em muitos livros europeus e de língua espanhola.
- \(N(\mu, \sigma^2)\): parametrizada pela média e pela variância. Comum em livros-texto anglo-saxões e na documentação da maioria dos softwares.
Sempre verifique qual convenção a sua disciplina usa antes de substituir números nas fórmulas. Uma distribuição normal com média 0 e desvio padrão 2 é \(N(0, 2)\) em uma convenção e \(N(0, 4)\) na outra.
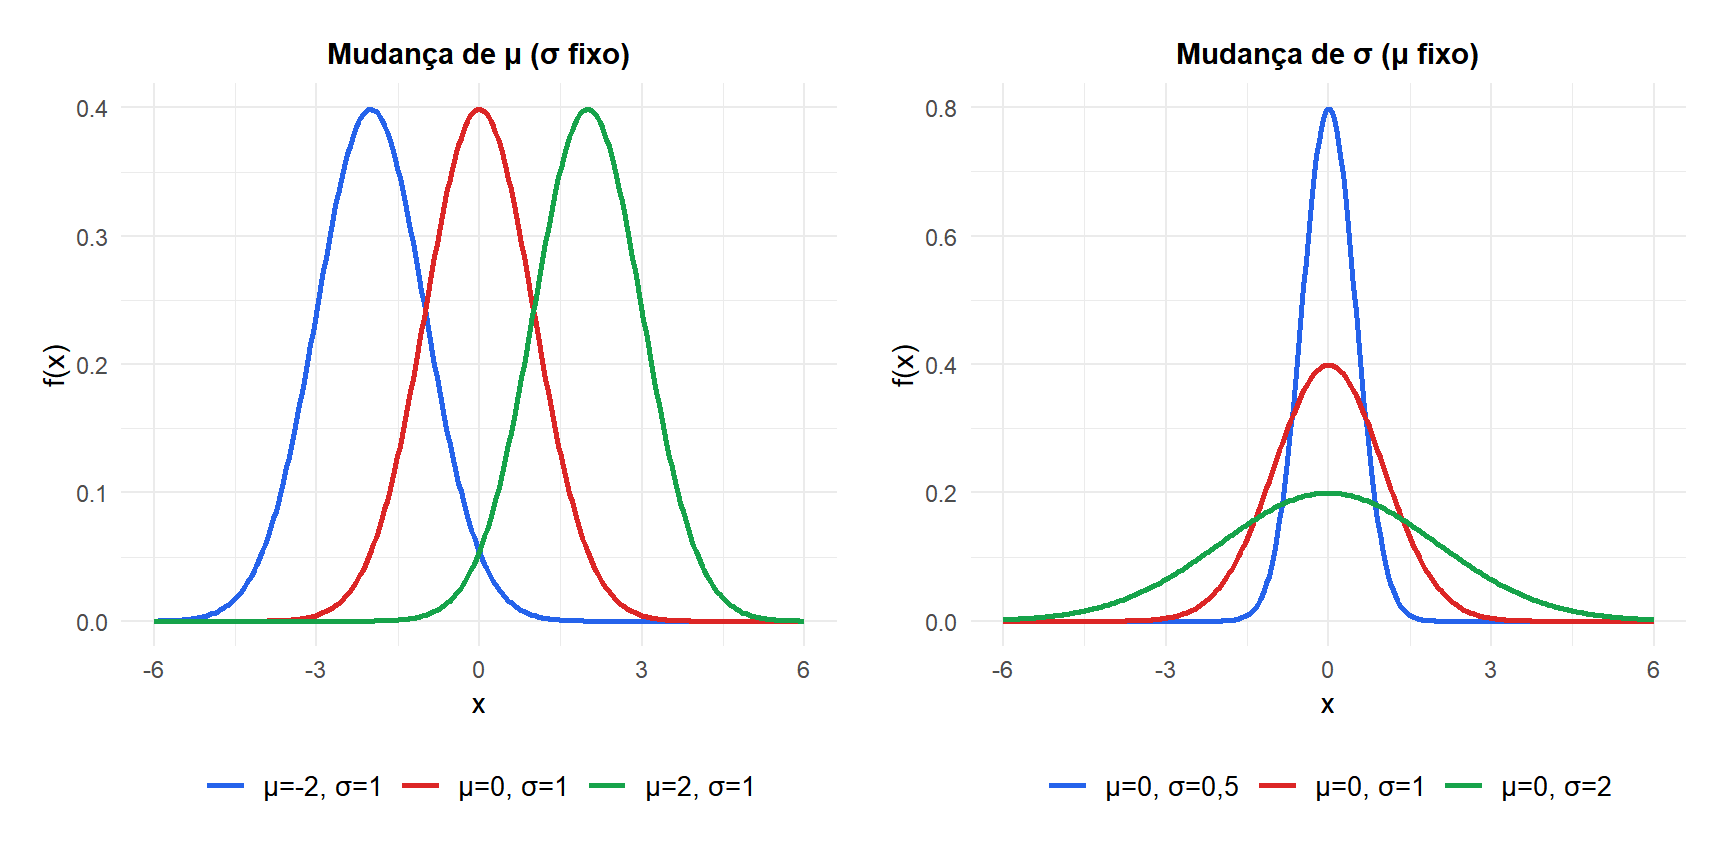
Figure 1: Efeito de mudar μ (esquerda) e σ (direita) na forma da distribuição normal
Propriedades
Para \(X \sim N(\mu, \sigma)\):
- Valor esperado (média)
\[E(X) = \mu\]
- Variância
\[\text{Var}(X) = \sigma^2\]
- Assimetria
Sempre 0. A distribuição normal é perfeitamente simétrica em torno de \(\mu\).
- Curtose
\[g_2 = 0 \quad \text{(curtose em excesso)}\]
A distribuição normal é a referência para a curtose: mesocúrtica por definição. A curtose simples é 3; a curtose em excesso subtrai 3 para dar 0.
- Moda e mediana
\[\text{Moda} = \text{Mediana} = \mu\]
As três medidas de tendência central coincidem, consequência da simetria perfeita.
- CDF
\[F(x) = \Phi\left(\frac{x-\mu}{\sigma}\right) = \frac{1}{2}\left[1 + \text{erf}\left(\frac{x-\mu}{\sigma\sqrt{2}}\right)\right]\]
em que \(\Phi\) é a CDF da normal padrão. Não existe uma primitiva em forma fechada: as probabilidades são calculadas numericamente ou por meio de tabelas.
- Função quantil
\[Q(p) = \mu + \sigma\,\Phi^{-1}(p)\]
O percentil 95 de \(N(0,1)\) é \(\Phi^{-1}(0{,}95) \approx 1{,}645\).
A regra 68-95-99,7
O resultado mais prático sobre a distribuição normal é a regra empírica: quase toda a probabilidade se concentra dentro de poucos desvios padrão da média.
\[P(\mu - \sigma \leq X \leq \mu + \sigma) \approx 0{,}6827\] \[P(\mu - 2\sigma \leq X \leq \mu + 2\sigma) \approx 0{,}9545\] \[P(\mu - 3\sigma \leq X \leq \mu + 3\sigma) \approx 0{,}9973\]
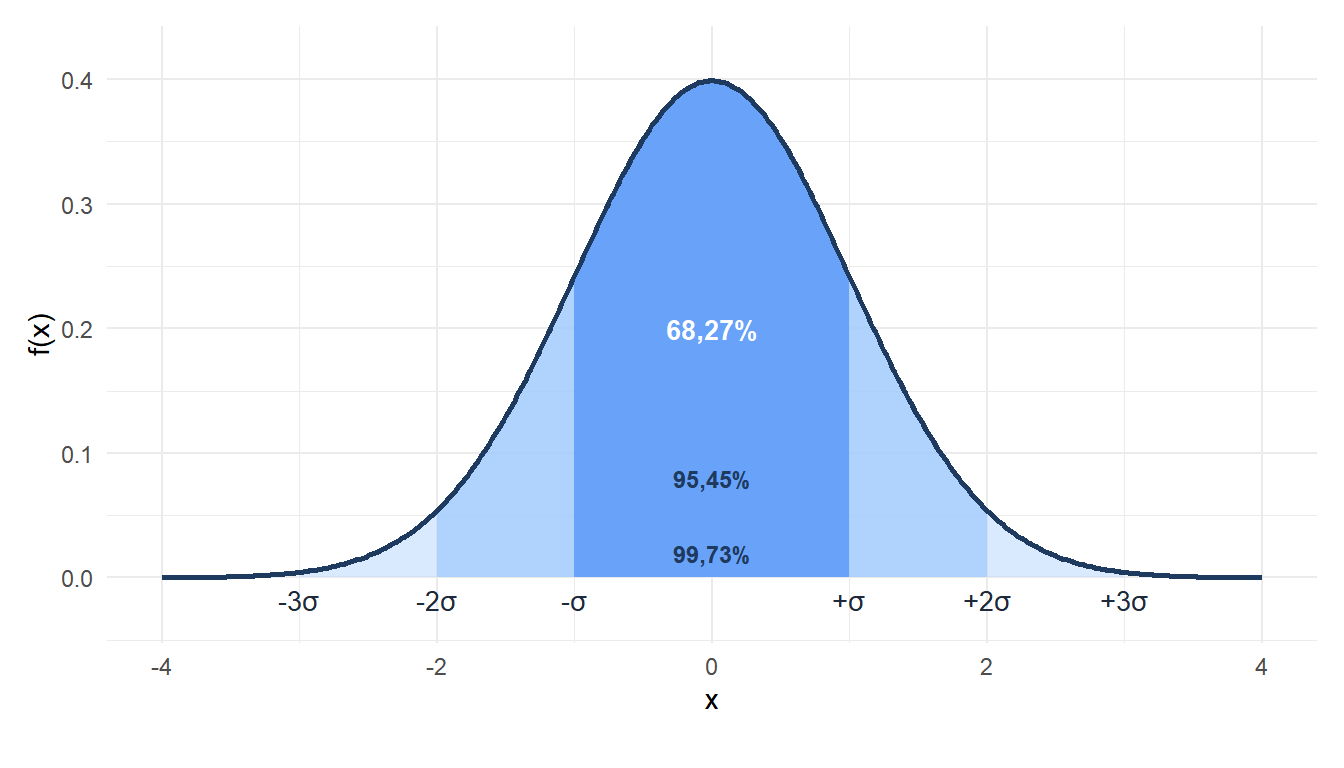
Figure 2: A regra 68-95-99,7: probabilidade dentro de 1, 2 e 3 desvios padrão da média
A estatura de homens adultos em um país segue \(N(175, 7)\) cm (média 175 cm, desvio padrão 7 cm).
- Cerca de 68% dos homens têm entre \(175 - 7 = 168\) e \(175 + 7 = 182\) cm.
- Cerca de 95% têm entre \(175 - 14 = 161\) e \(175 + 14 = 189\) cm.
- Apenas cerca de 0,3% têm menos de 154 cm ou mais de 196 cm (mais de 3 desvios padrão da média).

Distribuição normal padrão
A distribuição normal padrão \(Z \sim N(0, 1)\) tem média 0 e desvio padrão 1. Sua PDF é:
\[f(z) = \frac{1}{\sqrt{2\pi}}\,e^{-z^2/2}, \quad -\infty < z < \infty\]
Sua CDF é denotada \(\Phi(z) = P(Z \leq z)\) e está tabulada nas tabelas da normal padrão.
Qualquer variável normal pode ser padronizada:
\[Z = \frac{X - \mu}{\sigma}\]
Isso converte \(X \sim N(\mu, \sigma)\) em \(Z \sim N(0,1)\), permitindo usar uma única tabela para todas as distribuições normais.
Propriedades de simetria úteis de \(\Phi\):
- \(\Phi(-z) = 1 - \Phi(z)\)
- \(P(Z > z) = 1 - \Phi(z)\)
- \(P(a \leq Z \leq b) = \Phi(b) - \Phi(a)\)
Exemplo passo a passo
As notas em uma prova padronizada seguem \(X \sim N(70, 10)\) (média 70, desvio padrão 10).
Probabilidade de obter mais de 85 pontos:
Padronizando: \(z = (85 - 70)/10 = 1{,}5\)
\[P(X > 85) = P(Z > 1{,}5) = 1 - \Phi(1{,}5) \approx 1 - 0{,}9332 = 0{,}0668\]
Cerca de 6,7% dos estudantes obtêm mais de 85 pontos.
Probabilidade de obter entre 60 e 80 pontos:
\[P(60 \leq X \leq 80) = \Phi\left(\frac{80-70}{10}\right) - \Phi\left(\frac{60-70}{10}\right) = \Phi(1) - \Phi(-1) \approx 0{,}8413 - 0{,}1587 = 0{,}6827\]
Isso é exatamente os 68,27% da regra empírica: o intervalo \([\mu - \sigma, \mu + \sigma]\).
Nota no percentil 90:
\[Q(0{,}90) = 70 + 10 \times \Phi^{-1}(0{,}90) \approx 70 + 10 \times 1{,}282 = 82{,}82\]
Um estudante precisa obter cerca de 82,8 pontos para estar nos 10% melhores.
Por que a distribuição normal está em todos os lugares
O Teorema Central do Limite (TCL) estabelece que a soma (ou média) de um grande número de variáveis aleatórias independentes, independentemente de suas distribuições individuais, tende a uma distribuição normal. Essa é a razão matemática pela qual a distribuição normal aparece em tantos fenômenos naturais e sociais:
- Alturas e pesos resultam da soma de muitos fatores genéticos e ambientais pequenos.
- Erros de medição em física são somas de muitas fontes de erro pequenas e independentes.
- Médias amostrais em inferência estatística são aproximadamente normais para amostras grandes, independentemente da distribuição da população.
💡 Relação com outras distribuições
- Normal padrão: \(N(0, 1)\) é a referência. Todas as outras distribuições normais são deslocamentos e reescalonamentos dela.
- Qui-quadrado: a soma de quadrados de \(k\) variáveis \(N(0,1)\) independentes segue uma \(\chi^2(k)\).
- t de Student: a razão entre uma variável \(N(0,1)\) e a raiz quadrada de uma \(\chi^2(k)/k\).
- Lognormal: se \(\ln(X) \sim N(\mu, \sigma)\), então \(X\) segue uma distribuição lognormal. Usada para preços de ativos e medições biológicas que não podem ser negativas.
- Aproximação binomial: \(\text{Binomial}(n,p) \approx N(np,\, \sqrt{np(1-p)})\) para \(n\) grande.

