Intervalo de confiança para a diferença entre duas proporções
O intervalo de confiança para \(p_1 - p_2\) estima o intervalo de valores plausíveis para a verdadeira diferença entre duas proporções populacionais. É a ferramenta padrão para comparar taxas de conversão, taxas de resposta ou qualquer resultado binário entre dois grupos independentes, estendendo o IC de uma única proporção para uma comparação entre dois grupos.
Fórmula
Dadas duas amostras independentes com \(x_1\) sucessos em \(n_1\) tentativas e \(x_2\) sucessos em \(n_2\) tentativas, as proporções amostrais são \(\hat{p}_1 = x_1/n_1\) e \(\hat{p}_2 = x_2/n_2\).
Um IC \((1-\alpha)\) para \(p_1 - p_2\) é:
\[(\hat{p}_1 - \hat{p}_2) \pm z_{\alpha/2} \sqrt{\frac{\hat{p}_1(1-\hat{p}_1)}{n_1} + \frac{\hat{p}_2(1-\hat{p}_2)}{n_2}}\]
O erro padrão da diferença combina os EPs individuais em quadratura (raiz quadrada da soma das variâncias), já que as duas amostras são independentes.
A aproximação normal é válida quando todas as quatro contagens são pelo menos 10:
\[n_1\hat{p}_1 \geq 10, \quad n_1(1-\hat{p}_1) \geq 10, \quad n_2\hat{p}_2 \geq 10, \quad n_2(1-\hat{p}_2) \geq 10\]
⚠️ Quando a aproximação normal falha
Quando qualquer uma das quatro contagens é menor que 10, a aproximação normal é pouco confiável. Nesse caso:
- Use o teste exato de Fisher para um teste de hipóteses.
- Use o intervalo de Newcombe (baseado nos intervalos de escore de Wilson para cada proporção separadamente), que mantém melhor cobertura sem exigir amostras grandes.
- Para eventos muito raros, considere a aproximação de Poisson.
A mesma condição que valida o IC da proporção individual deve se manter para os dois grupos para validar o IC da diferença.
Distribuição amostral da diferença
Por independência e pelo TCL, \(\hat{p}_1 - \hat{p}_2\) é aproximadamente normal com:
\[E[\hat{p}_1 - \hat{p}_2] = p_1 - p_2\]
\[\text{EP}(\hat{p}_1 - \hat{p}_2) = \sqrt{\frac{p_1(1-p_1)}{n_1} + \frac{p_2(1-p_2)}{n_2}}\]
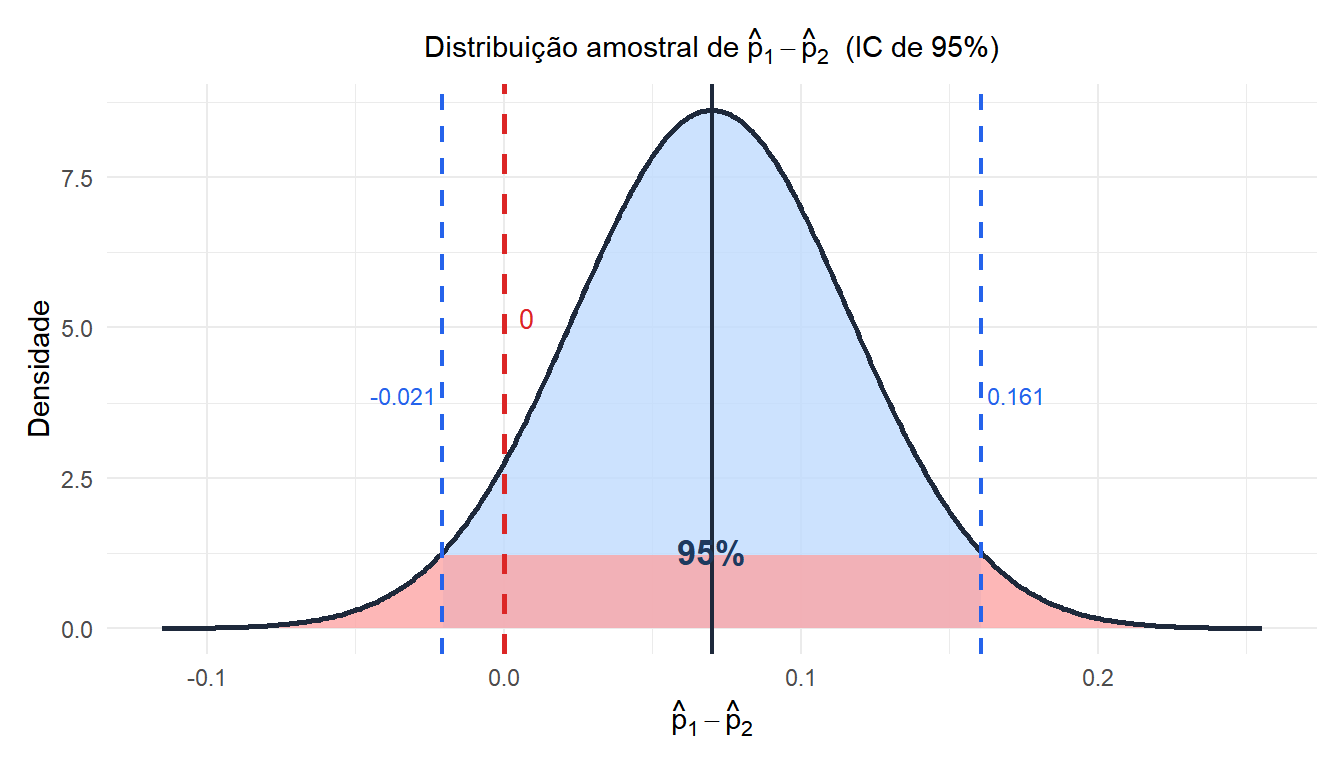
A linha vermelha tracejada em 0 representa “nenhuma diferença”. Como 0 cai fora do IC, a diferença é estatisticamente significativa no nível de 5%.
Exemplos passo a passo
Exemplo 1: teste A/B
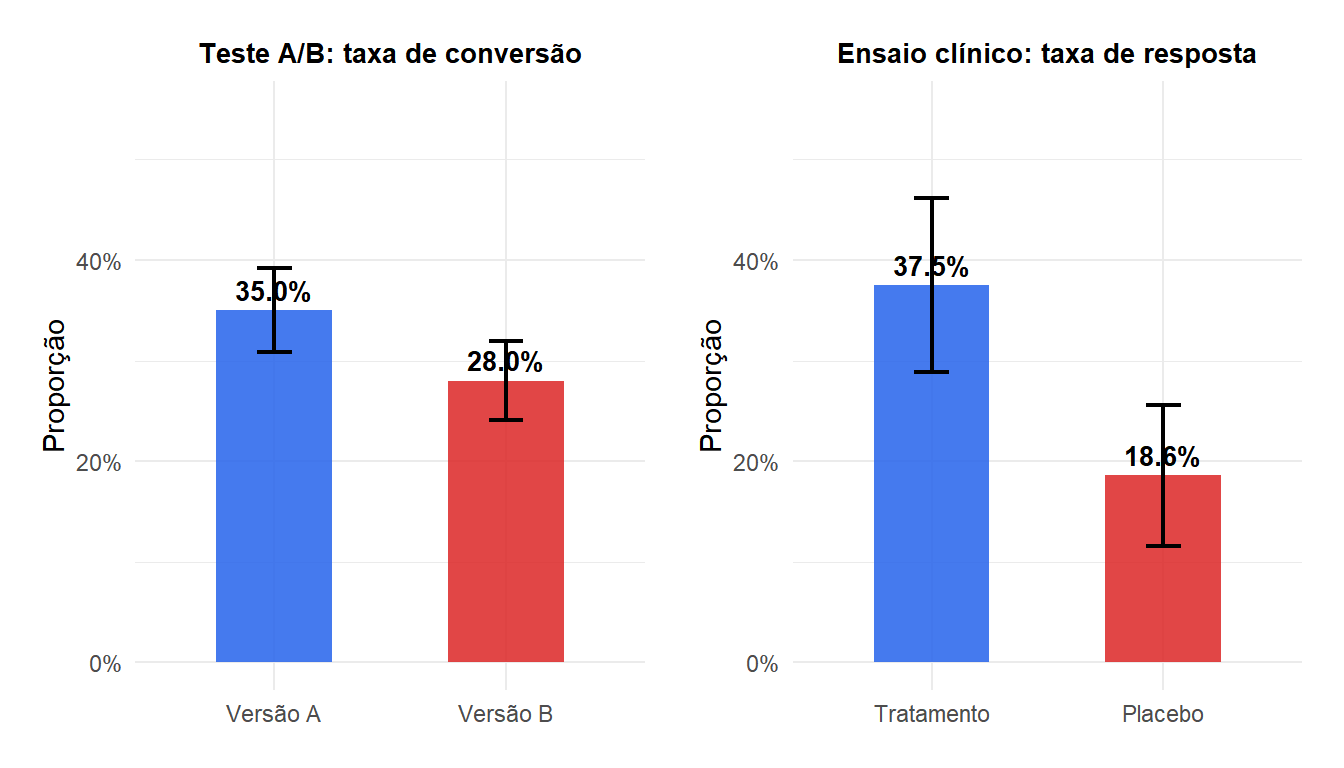
Uma plataforma de e-commerce testa dois designs de página de destino. A versão A é mostrada a 500 visitantes, 175 dos quais fazem uma compra. A versão B é mostrada a 500 visitantes, 140 dos quais fazem uma compra.
\[\hat{p}_A = 175/500 = 0{,}350, \qquad \hat{p}_B = 140/500 = 0{,}280\]
Verificação das condições:
\[n_A\hat{p}_A = 175 \geq 10, \quad n_A(1-\hat{p}_A) = 325 \geq 10 \checkmark\] \[n_B\hat{p}_B = 140 \geq 10, \quad n_B(1-\hat{p}_B) = 360 \geq 10 \checkmark\]
Erro padrão:
\[\text{EP} = \sqrt{\frac{0{,}350 \times 0{,}650}{500} + \frac{0{,}280 \times 0{,}720}{500}} = \sqrt{0{,}000455 + 0{,}000403} = \sqrt{0{,}000858} \approx 0{,}0293\]
IC de 95%:
\[0{,}350 - 0{,}280 \pm 1{,}960 \times 0{,}0293 = 0{,}070 \pm 0{,}057 = (0{,}013;\; 0{,}127)\]
A versão A converte entre 1,3 e 12,7 pontos percentuais mais do que a versão B. Como o intervalo exclui o 0, a diferença é estatisticamente significativa. A versão A é melhor.
Exemplo 2: ensaio clínico
Um ensaio randomizado compara a taxa de resposta de um novo medicamento com placebo. Grupo de tratamento: 45 respondedores de 120. Grupo placebo: 22 respondedores de 118.
\[\hat{p}_T = 45/120 = 0{,}375, \qquad \hat{p}_P = 22/118 = 0{,}186\]
\[\text{EP} = \sqrt{\frac{0{,}375 \times 0{,}625}{120} + \frac{0{,}186 \times 0{,}814}{118}} = \sqrt{0{,}001953 + 0{,}001283} \approx 0{,}0569\]
IC de 95%:
\[0{,}375 - 0{,}186 \pm 1{,}960 \times 0{,}0569 = 0{,}189 \pm 0{,}111 = (0{,}078;\; 0{,}300)\]
O tratamento aumenta a taxa de resposta entre 7,8 e 30,0 pontos percentuais. Essa é uma melhora clinicamente relevante e estatisticamente significativa.
Conexão com testes de hipóteses
Um IC \((1-\alpha)\) para \(p_1 - p_2\) se conecta diretamente ao teste bilateral de \(H_0: p_1 = p_2\) no nível de significância \(\alpha\):
- Se o IC exclui 0: rejeita-se \(H_0\). Há evidência significativa de uma diferença.
- Se o IC inclui 0: não se rejeita \(H_0\). Os dados são consistentes com proporções iguais.
Observe que a estatística do teste usa uma proporção combinada \(\hat{p} = (x_1 + x_2)/(n_1 + n_2)\) sob \(H_0\), enquanto o IC usa as proporções individuais. O IC é mais informativo porque mostra a magnitude e a direção da diferença, não apenas se ela é significativa.
Três resultados possíveis, ilustrados com exemplos:
- IC = (0,013; 0,127): inteiramente positivo. O Grupo 1 tem proporção maior. Significativo.
- IC = (-0,043; 0,083): inclui 0. Nenhuma diferença significativa detectada.
- IC = (-0,127; -0,013): inteiramente negativo. O Grupo 2 tem proporção maior. Significativo.
Um IC que exclui 0 por muito pouco (por exemplo, \((-0{,}001;\, 0{,}082)\)) é muito diferente de um que o inclui com folga (por exemplo, \((-0{,}05;\, 0{,}07)\)). Sempre reporte o intervalo real, não apenas “significativo” ou “não significativo”.

💡 Diretrizes práticas
- Verifique a condição das quatro contagens (\(\geq 10\)) antes de aplicar a fórmula.
- Para contagens pequenas ou eventos raros, use o teste exato de Fisher ou o intervalo de Newcombe.
- Reporte como: “\(\hat{p}_1 - \hat{p}_2 = 0{,}07\) (IC de 95%: 0,013 a 0,127)”.
- Para o planejamento do tamanho de amostra, veja o post de cálculo do tamanho da amostra: a fórmula para duas proporções usa a mesma estrutura que para uma proporção, mas considera os dois grupos.
- No R:
prop.test(c(x1, x2), c(n1, n2))calcula o IC e o teste simultaneamente.

