Teste de Dickey-Fuller
O post geral sobre estacionariedade introduz a raiz unitária e menciona brevemente os testes ADF e KPSS. Este post se aprofunda em um único teste: como a regressão de Dickey-Fuller (aumentada) é de fato construída, por que seus valores críticos não são os de uma tabela t normal, e um exemplo completo resolvido manualmente a partir de resultados reais do R.
A regressão de Dickey-Fuller
Comece a partir do processo AR(1) simples:
\[y_t = \phi y_{t-1} + \varepsilon_t\]
Subtraindo \(y_{t-1}\) de ambos os lados obtém-se uma forma de regressão algebricamente equivalente:
\[y_t - y_{t-1} = (\phi - 1) y_{t-1} + \varepsilon_t \quad \implies \quad \Delta y_t = \gamma y_{t-1} + \varepsilon_t, \qquad \gamma = \phi - 1\]
Essa reescrita transforma a pergunta difícil “\(\phi = 1\)?” em uma fácil: “\(\gamma = 0\)?”, algo que um coeficiente de regressão comum pode responder diretamente.
\[H_0: \gamma = 0 \ \ (\phi = 1,\ \text{raiz unitária, não estacionária})\] \[H_1: \gamma < 0 \ \ (\phi < 1,\ \text{estacionária})\]
Na prática, três especificações são usadas, correspondendo ao argumento type= de urca::ur.df():
none: sem constante, sem tendência. \(\Delta y_t = \gamma y_{t-1} + \varepsilon_t\).drift: apenas constante, sem tendência. \(\Delta y_t = \alpha + \gamma y_{t-1} + \varepsilon_t\).trend: constante mais uma tendência linear. \(\Delta y_t = \alpha + \beta t + \gamma y_{t-1} + \varepsilon_t\).
A especificação drift é o padrão mais comum para séries sem uma tendência determinística óbvia, e é a usada no exemplo resolvido abaixo. Escolher a especificação errada custa poder estatístico em ambas as direções: incluir um termo de tendência quando a série não tem nenhuma desperdiça graus de liberdade e torna menos provável rejeitar uma raiz unitária falsa, enquanto omitir uma tendência genuinamente presente pode fazer uma série não estacionária com tendência parecer enganosamente próxima de estacionária.
\[\Delta y_t = \alpha + \gamma y_{t-1} + \varepsilon_t \qquad H_0: \gamma = 0 \quad \text{vs} \quad H_1: \gamma < 0\]
Cada especificação tem sua própria tabela de valores críticos, já que adicionar uma constante ou uma tendência desloca a distribuição de referência de \(\tau\). A convenção de nomenclatura de MacKinnon rotula essas tabelas como \(\tau_1\) (none), \(\tau_2\) (drift) e \(\tau_3\) (trend); summary(ur.df(...)) imprime automaticamente a correspondente, dependendo de type=.
Por que não uma tabela t normal?
Este é o ponto mais facilmente esquecido: sob \(H_0\), \(y_{t-1}\) é, por si só, não estacionária (é um processo com raiz unitária), então a estatística t de \(\gamma\), normalmente denotada \(\tau\) (tau), não segue uma distribuição t de Student padrão, nem mesmo assintoticamente conforme o tamanho da amostra cresce.
Intuitivamente, sob uma raiz unitária, o regressor \(y_{t-1}\) continua se afastando cada vez mais do seu ponto de partida conforme \(t\) cresce, então ele não se estabiliza na distribuição fixa e bem-comportada em que a teoria de mínimos quadrados ordinários se apoia. A distribuição amostral de \(\tau\) acaba enviesada para a esquerda e deslocada da forma de sino familiar, razão pela qual confiar em valores críticos t padrão faria o teste rejeitar com muito menos frequência do que deveria.
Dickey e Fuller derivaram a distribuição de referência correta por simulação e tabularam valores críticos para ela. MacKinnon depois tornou esses valores utilizáveis para qualquer tamanho de amostra por meio de regressões de superfície de resposta, que é exatamente o que pacotes como urca usam internamente para imprimir valores críticos ou p-valores. É por isso que \(\tau\) deve sempre ser comparado com valores críticos especiais de Dickey-Fuller (ou MacKinnon), nunca com qt() ou uma tabela t impressa.
Aumentando para a autocorrelação (o “A” de ADF)
A regressão acima assume que os erros \(\varepsilon_t\) são ruído branco. Se \(y_t\) tem autocorrelação de ordem superior, os resíduos não serão ruído branco e o teste se torna não confiável. A solução é adicionar termos de diferenças defasadas até que os resíduos sejam branqueados:
\[\Delta y_t = \alpha + \gamma y_{t-1} + \sum_{j=1}^p \delta_j \Delta y_{t-j} + \varepsilon_t\]
O número de defasagens \(p\) é normalmente escolhido por AIC ou BIC, ou por um procedimento sequencial: começar com um número generoso de defasagens e eliminar a menos significativa até que a última defasagem incluída seja significativa. Adicionar defasagens apenas controla a autocorrelação; o teste de hipótese em si continua sendo sobre \(\gamma\), sem alteração.
Poucas defasagens deixam autocorrelação nos resíduos e distorcem o tamanho do teste, fazendo-o rejeitar com muita frequência. Defasagens demais desperdiçam graus de liberdade e reduzem o poder, dificultando a rejeição de uma raiz unitária falsa. Na prática, esse equilíbrio é exatamente a razão pela qual urca::ur.df() expõe lags como um argumento em vez de fixar uma única escolha.
Uma regra prática comum para o número inicial de defasagens, devida a Schwert, é \(p_{max} = \lfloor 12 (T/100)^{1/4} \rfloor\), após a qual o AIC, o BIC ou o procedimento sequencial de teste t o reduzem. Para a série curta usada no exemplo resolvido abaixo, \(T=60\), esse limite superior já é pequeno o suficiente para que testar com lags = 0 seja uma simplificação razoável para fins de ilustração.
Um exemplo resolvido, manualmente
Executar o teste lado a lado em uma série genuinamente estacionária e outra genuinamente não estacionária mostra exatamente como são a estatística de teste e o p-valor em cada caso.
Simule duas séries de comprimento \(T=60\): um processo AR(1) estacionário com \(\phi=0{,}6\), e um passeio aleatório puro.
set.seed(1)
T <- 60
eps  <- rnorm(T)
y_ar <- numeric(T)
for (t in 2:T) y_ar[t] <- 0.6 * y_ar[t-1] + eps[t]
eps2 <- rnorm(T)
y_rw <- cumsum(eps2)
Ambas são testadas com a especificação drift e sem defasagens de aumento (urca::ur.df(y, type = "drift", lags = 0)).
Para y_ar (a série AR(1) estacionária):
\[\widehat{\Delta y_t} = 0{,}165 - 0{,}550\, y_{t-1}\]
\(SE(\hat\gamma) = 0{,}118\), então \(\tau = -0{,}550/0{,}118 = -4{,}655\), com \(gl\) residual \(= 57\).
Para y_rw (o passeio aleatório):
\[\widehat{\Delta y_t} = 0{,}417 - 0{,}083\, y_{t-1}\]
\(SE(\hat\gamma) = 0{,}0547\), então \(\tau = -0{,}083/0{,}0547 = -1{,}509\), com \(gl\) residual \(= 57\).
Valores críticos de MacKinnon para a especificação drift (\(\tau_2\)): 1% = \(-3{,}51\), 5% = \(-2{,}89\), 10% = \(-2{,}58\).
Decisão para y_ar: \(\tau = -4{,}655 < -3{,}51\), então \(H_0\) é rejeitada no nível de 1%. Forte evidência de estacionariedade, correspondendo corretamente a como a série foi simulada: um AR(1) com \(|\phi| < 1\).
Decisão para y_rw: \(\tau = -1{,}509\), maior até do que o valor crítico de 10% (\(-2{,}58\)), ou seja, menos negativo, dentro da região de não rejeição. \(H_0\) não é rejeitada. Nenhuma evidência contra a raiz unitária, correspondendo corretamente a como a série foi simulada: um passeio aleatório puro.

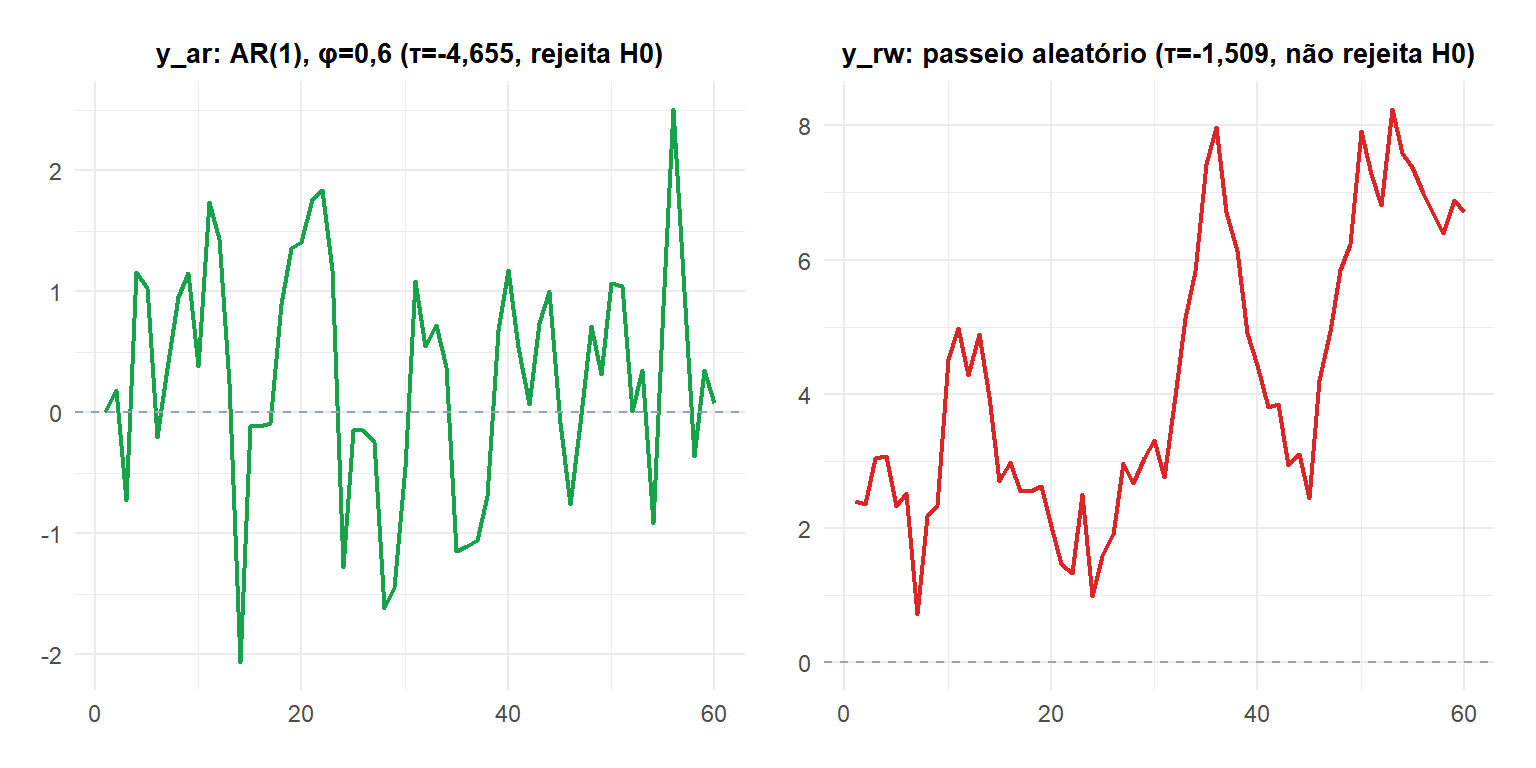
A série estacionária (verde) oscila em torno de uma média constante e cruza repetidamente a linha de zero. O passeio aleatório (vermelho) se afasta de zero e nunca retorna de forma confiável, exatamente a assinatura visual que o teste ADF capta numericamente.
Observe a direção dos dois erros padrão em relação a \(\hat\gamma\): para y_ar, \(SE(\hat\gamma) = 0{,}118\) é pequeno em relação ao coeficiente, então ele é estimado com precisão suficiente para ser distinguível de zero. Para y_rw, \(SE(\hat\gamma) = 0{,}0547\) também é pequeno em termos absolutos, mas o próprio coeficiente, \(-0{,}083\), está perto o suficiente de zero para que \(\tau\) ainda caia bem dentro da região de não rejeição.
⚠️ tseries::adf.test() não é a mesma regressão: verifique o que ele realmente ajusta
Por padrão, tseries::adf.test() no R ajusta uma especificação diferente da de apenas constante usada acima: ela inclui tanto uma constante quanto um termo de tendência linear, e escolhe automaticamente a ordem de defasagem de aumento por uma regra prática, \(p = \lfloor (n-1)^{1/3} \rfloor\). O exemplo resolvido acima, em vez disso, usou urca::ur.df(type = "drift", lags = 0): apenas constante, sem aumento.
Como a especificação difere, a estatística e o p-valor impressos por adf.test() geralmente não corresponderão aos números de drift sem aumento calculados acima. Ambos são testes ADF válidos, apenas respondem a uma pergunta sutilmente diferente: se há uma tendência determinística a controlar, e quantas defasagens de autocorrelação são necessárias para branquear os resíduos. Sempre verifique qual especificação uma função está usando (type= em urca::ur.df(), ou a documentação de qualquer pacote que você use) antes de comparar resultados entre ferramentas ou artigos.
Escolhendo entre ADF, KPSS e Phillips-Perron
O ADF testa \(H_0\) = raiz unitária, enquanto o KPSS testa o oposto, \(H_0\) = estacionária, então uma conclusão robusta exige que ambos os testes concordem, em vez de confiar em apenas um. O post geral sobre estacionariedade cobre o KPSS e o Phillips-Perron em mais profundidade; aqui vai apenas um lembrete compacto.
| Teste | \(H_0\) | Rejeitar \(H_0\) significa |
|---|---|---|
| ADF | Raiz unitária (não estacionária) | Evidência de estacionariedade |
| KPSS | Estacionária | Evidência de raiz unitária |
| Phillips-Perron | Raiz unitária (não estacionária) | Evidência de estacionariedade (robusto à heterocedasticidade) |
Executando o teste em R
summary() em um objeto ur.df() imprime os coeficientes da regressão ajustada, a estatística de teste (rotulada tau2 para a especificação drift), e uma pequena tabela de valores críticos nos níveis de 1%, 5% e 10%, os mesmos números usados no exemplo resolvido acima. Ler essa tabela diretamente, em vez de confiar apenas em um p-valor, é uma boa prática: ela mostra exatamente quão próxima a decisão esteve do próximo nível de significância.
library(urca)

set.seed(1)
T <- 60
eps  <- rnorm(T)
y_ar <- numeric(T)
for (t in 2:T) y_ar[t] <- 0.6 * y_ar[t-1] + eps[t]
eps2 <- rnorm(T)
y_rw <- cumsum(eps2)

# Transparent regression form, exactly matching the by-hand example
summary(ur.df(y_ar, type = "drift", lags = 0))
summary(ur.df(y_rw, type = "drift", lags = 0))

# Quick, commonly used alternative (different default specification, see warning above)
library(tseries)
adf.test(y_ar)
adf.test(y_rw)

# Automatic order-of-differencing helper
library(forecast)
ndiffs(y_rw)
ndiffs() executa internamente exatamente esse tipo de busca baseada em ADF (o KPSS também é uma opção por meio do argumento test=) e retorna o número mínimo de diferenças regulares que estima serem necessárias, um atalho conveniente depois que você já entende o que a regressão subjacente está fazendo.
💡 Sempre diferencie e teste novamente
Se o teste ADF não rejeitar a raiz unitária, o remédio padrão é diferenciar a série uma vez e executar o teste ADF novamente em \(\Delta y_t\). Repita até que o teste rejeite. A maioria das séries econômicas e financeiras é integrada de ordem 1, \(I(1)\): uma diferenciação é suficiente. forecast::ndiffs() automatiza essa busca. A diferenciação excessiva, ir além do necessário, introduz ruído desnecessário e deve ser evitada: sempre confirme o \(d\) mínimo que alcança a estacionariedade, em vez de diferenciar repetidamente “por precaução”.

