Análise de variância (ANOVA)
A ANOVA de um fator testa se as médias de três ou mais grupos independentes são todas iguais. Ela estende o teste t de duas amostras para múltiplos grupos, controlando a taxa de erro tipo I, que se inflaria se múltiplos testes t fossem aplicados em pares. Quando uma covariável contínua também precisa ser controlada, veja a ANCOVA.
Por que não múltiplos testes t?
Com \(k\) grupos, existem \(\binom{k}{2}\) comparações par a par possíveis. Com \(\alpha = 0{,}05\), cada teste t tem 5% de chance de um falso positivo. Com 3 grupos (3 comparações), a probabilidade de pelo menos um falso positivo é \(1 - 0{,}95^3 \approx 0{,}14\): quase três vezes a taxa nominal. A ANOVA testa todos os grupos simultaneamente com uma única estatística F, mantendo o erro tipo I em \(\alpha\).
Hipóteses
As afirmações concorrentes que a ANOVA distingue são simples de enunciar: ou todas as médias de grupo são iguais, ou pelo menos uma delas não é.
\[H_0: \mu_1 = \mu_2 = \cdots = \mu_k \qquad H_1: \text{pelo menos um } \mu_i \neq \mu_j\]
Um resultado significativo indica apenas que pelo menos uma média de grupo difere. Testes post-hoc identificam quais pares diferem.
Particionando a variância
A ANOVA decompõe a variação total em dois componentes:
\[SQ_\text{total} = SQ_\text{entre} + SQ_\text{dentro}\]
em que:
- \(SQ_\text{entre} = \sum_{i=1}^k n_i (\bar{y}_i - \bar{y})^2\): variação devida a diferenças entre as médias de grupo.
- \(SQ_\text{dentro} = \sum_{i=1}^k \sum_{j=1}^{n_i} (y_{ij} - \bar{y}_i)^2\): variação dentro dos grupos (residual).
A estatística F é a razão entre os quadrados médios:
\[F = \frac{QM_\text{entre}}{QM_\text{dentro}} = \frac{SQ_\text{entre}/(k-1)}{SQ_\text{dentro}/(N-k)}\]
Sob \(H_0\) e a suposição de normalidade, \(F \sim F(k-1, N-k)\). Valores grandes de \(F\) indicam que a variação entre grupos excede o que seria esperado apenas pela amostragem aleatória.
A tabela ANOVA
Os resultados são tipicamente apresentados em uma tabela padronizada:
| Fonte | SQ | gl | QM | F | valor-p |
|---|---|---|---|---|---|
| Entre grupos | \(SQ_E\) | \(k-1\) | \(QM_E = SQ_E/(k-1)\) | \(F = QM_E/QM_D\) | \(P(F_{k-1,N-k} \geq F)\) |
| Dentro dos grupos | \(SQ_D\) | \(N-k\) | \(QM_D = SQ_D/(N-k)\) | ||
| Total | \(SQ_T\) | \(N-1\) |
Exemplo completo: três planos de dieta
Uma nutricionista compara a perda de peso (kg) em três planos de dieta após 8 semanas:
- Dieta A: 4, 5, 6, 5, 7 (\(n_1 = 5\), \(\bar{y}_1 = 5{,}4\))
- Dieta B: 8, 7, 9, 10, 8 (\(n_2 = 5\), \(\bar{y}_2 = 8{,}4\))
- Dieta C: 3, 2, 4, 3, 2 (\(n_3 = 5\), \(\bar{y}_3 = 2{,}8\))
Média geral: \(\bar{y} = (5{,}4 + 8{,}4 + 2{,}8)/3 = 5{,}533\).
\(SQ_\text{entre}\):
\[SQ_E = 5(5{,}4-5{,}533)^2 + 5(8{,}4-5{,}533)^2 + 5(2{,}8-5{,}533)^2\] \[= 5(0{,}018) + 5(8{,}211) + 5(7{,}474) = 0{,}089 + 41{,}056 + 37{,}369 = 78{,}533\]
\(SQ_\text{dentro}\) (soma dos desvios ao quadrado dentro de cada grupo):
Dieta A: \((4-5{,}4)^2+(5-5{,}4)^2+(6-5{,}4)^2+(5-5{,}4)^2+(7-5{,}4)^2 = 1{,}96+0{,}16+0{,}36+0{,}16+2{,}56 = 5{,}2\)
Dieta B: \((8-8{,}4)^2+(7-8{,}4)^2+(9-8{,}4)^2+(10-8{,}4)^2+(8-8{,}4)^2 = 0{,}16+1{,}96+0{,}36+2{,}56+0{,}16 = 5{,}2\)
Dieta C: \((3-2{,}8)^2+(2-2{,}8)^2+(4-2{,}8)^2+(3-2{,}8)^2+(2-2{,}8)^2 = 0{,}04+0{,}64+1{,}44+0{,}04+0{,}64 = 2{,}8\)
\(SQ_D = 5{,}2 + 5{,}2 + 2{,}8 = 13{,}2\)
Tabela ANOVA:
| Fonte | SQ | gl | QM | F | valor-p |
|---|---|---|---|---|---|
| Entre | 78,533 | 2 | 39,267 | 35,70 | < 0,001 |
| Dentro | 13,200 | 12 | 1,100 | ||
| Total | 91,733 | 14 |
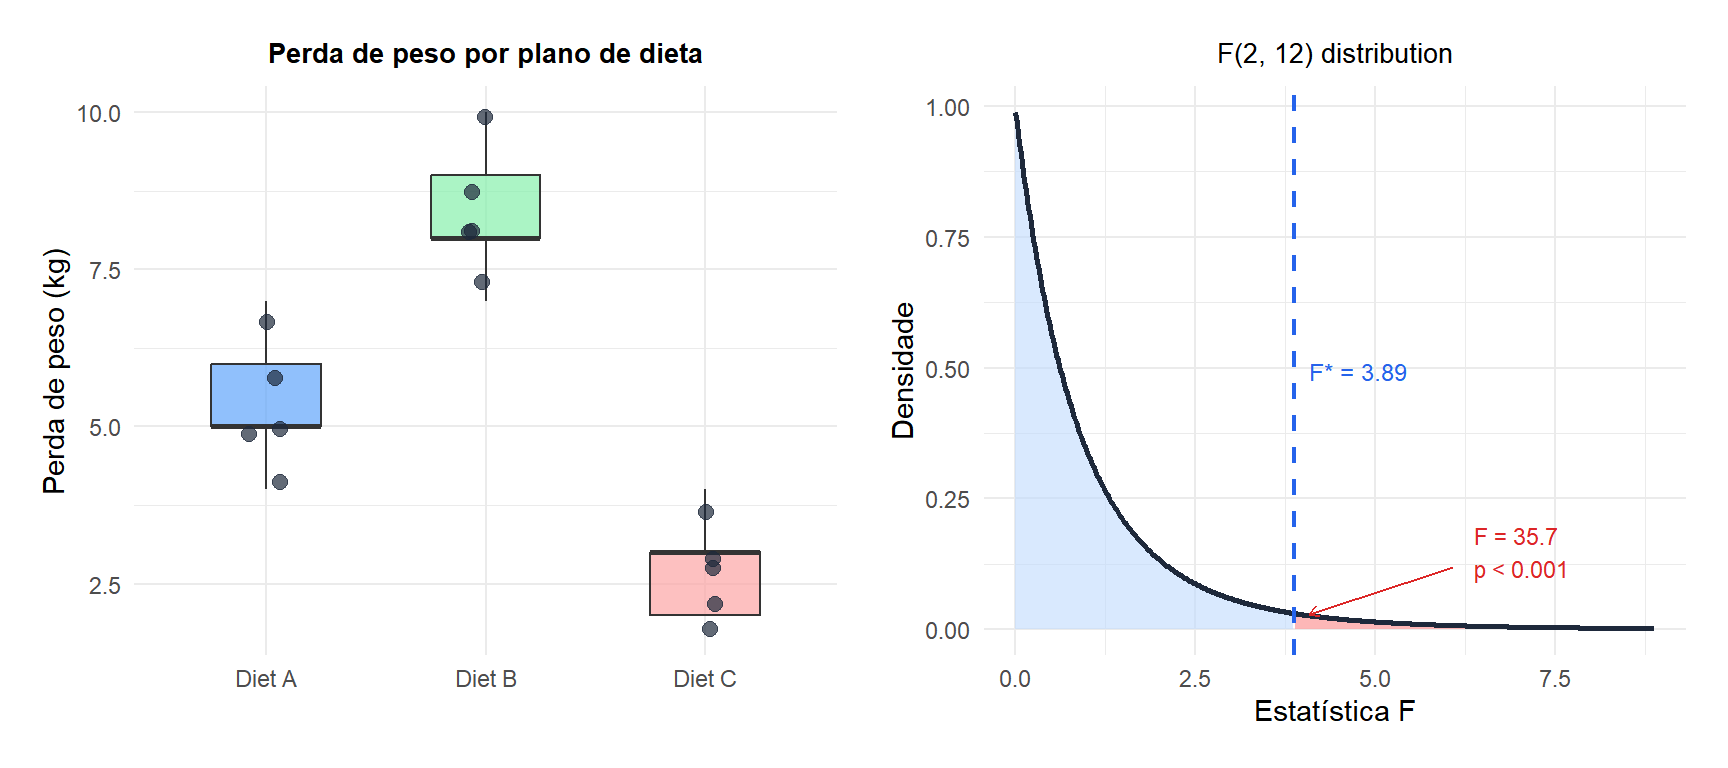
Decisão: \(F = 35{,}70 \gg F_{0{,}05,2,12} = 3{,}885\), \(p < 0{,}001\). Rejeitamos \(H_0\): pelo menos uma dieta produz uma perda de peso média diferente.
Testes post-hoc: quais grupos diferem?
A rejeição de \(H_0\) pela ANOVA só diz que algumas médias diferem. Testes post-hoc identificam quais pares, controlando as comparações múltiplas.
O HSD de Tukey (Differença Honestamente Significativa) é a opção padrão ao comparar todos os pares. Ele usa a distribuição da amplitude estudentizada e controla a taxa de erro familiar em \(\alpha\).
Para tamanhos de grupo iguais, a diferença mínima significativa entre duas médias é:
\[\text{HSD} = q_{\alpha,k,N-k} \sqrt{\frac{QM_D}{n}}\]
em que \(q_{\alpha,k,N-k}\) é o valor crítico da distribuição da amplitude estudentizada.
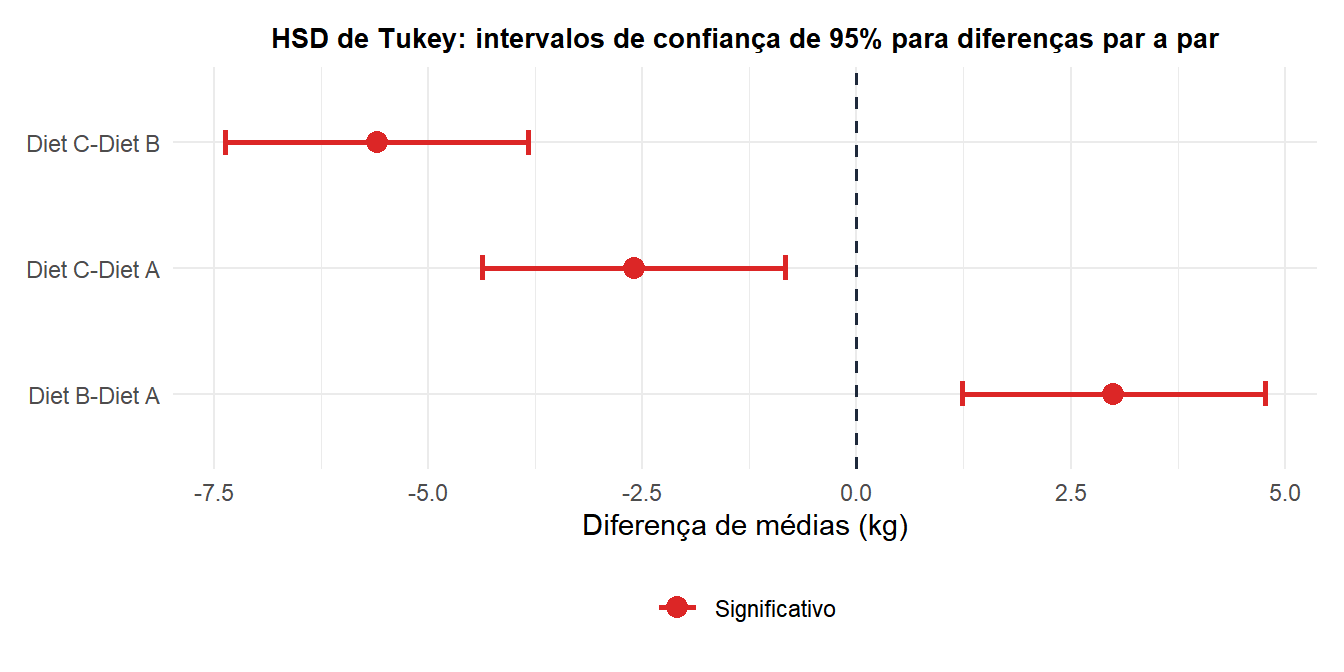
As três comparações par a par são significativas: todas as dietas diferem entre si. A Dieta B produz a maior perda de peso; a Dieta C, a menor.
Suposições
A ANOVA de um fator exige:
- Independência: as observações são independentes dentro de cada grupo e entre grupos.
- Normalidade: os resíduos são aproximadamente normais dentro de cada grupo. Verifique com Shapiro-Wilk ou gráficos Q-Q.
- Homocedasticidade: variâncias iguais entre grupos. Verifique com o teste de Levene.
⚠️ A ANOVA é robusta a violações leves de normalidade, mas não à heterocedasticidade
Para tamanhos de grupo iguais ou similares, a ANOVA é bastante robusta a desvios leves de normalidade (TCL). Ela é mais sensível a variâncias desiguais, especialmente quando os tamanhos de grupo diferem.
Se o teste de Levene rejeitar a homocedasticidade:
- Use a ANOVA de Welch (
oneway.test(..., var.equal = FALSE)no R): não assume variâncias iguais. - Use Kruskal-Wallis como alternativa não paramétrica.
Se a normalidade for severamente violada: use Kruskal-Wallis.
Executando a ANOVA em R
A mesma comparação de dietas acima, mais a variante de Welch e o teste post-hoc de Tukey, ajustadas diretamente em R:
# One-way ANOVA
fit <- aov(loss ~ diet, data = df_diet)
summary(fit)

# Welch's ANOVA (unequal variances)
oneway.test(loss ~ diet, data = df_diet, var.equal = FALSE)

# Tukey post-hoc
TukeyHSD(fit)

# Levene's test for homoscedasticity
car::leveneTest(loss ~ diet, data = df_diet)

# Kruskal-Wallis (nonparametric alternative)
kruskal.test(loss ~ diet, data = df_diet)
💡 ANOVA vs. múltiplos testes t: a regra chave
Nunca execute testes t par a par como substituto da ANOVA. Use a ANOVA primeiro para testar a \(H_0\) global. Se significativa, use testes post-hoc (Tukey, Bonferroni, Scheffé) que controlam a taxa de erro familiar. Executar testes t par a par sem correção infla a taxa de erro tipo I e não é cientificamente válido.

