Teste HSD de Tukey
Após um teste F de ANOVA significativo, tudo o que você sabe é que pelo menos uma média de grupo difere das outras, não quais. O teste HSD de Tukey (Diferença Honestamente Significativa) responde a essa pergunta, testando cada comparação par a par de médias de grupo enquanto controla a taxa de erro tipo I geral (familiar) no \(\alpha\) escolhido. O teste F global da ANOVA é um pré-requisito: o HSD de Tukey só tem sentido depois que esse teste já rejeitou \(H_0\).
Por que não simplesmente executar testes t par a par?
O problema das comparações múltiplas já foi introduzido no post sobre ANOVA, mas vale a pena ver os números exatos para este exemplo. Com \(k=3\) grupos, existem \(\binom{3}{2}=3\) comparações par a par possíveis. Se cada uma for testada com um teste t separado em \(\alpha=0{,}05\), a probabilidade de pelo menos um falso positivo nas 3 comparações é:
\[1 - 0{,}95^3 \approx 0{,}143\]
Isso é quase três vezes a taxa nominal de 5%, apenas por executar três testes nos mesmos dados. Em geral, para \(m\) comparações independentes, cada uma executada no nível \(\alpha\), a taxa de erro familiar é \(1-(1-\alpha)^m\), que cresce rapidamente: com 5 grupos há \(\binom{5}{2}=10\) comparações e a taxa de erro familiar sobe além de 40%. O HSD de Tukey corrige isso usando um valor crítico mais amplo, construído especificamente para esse problema, de modo que a probabilidade de qualquer falso positivo entre todas as comparações permanece em \(\alpha\), independentemente de quantos pares sejam testados.
A distribuição da amplitude estudentizada e a fórmula do HSD
O método de Tukey se baseia na estatística da amplitude estudentizada \(q\), a distribuição de (maior média de grupo menos menor média de grupo) dividida pelo erro padrão, em \(k\) grupos normais independentes. Em vez de comparar cada par contra o valor crítico t usual, toda comparação é julgada contra o valor crítico dessa distribuição de amplitude, que já leva em conta o fato de que \(k\) médias estão sendo comparadas simultaneamente.
Para tamanhos de grupo iguais \(n\), a diferença mínima entre duas médias necessária para ser considerada “significativa” é:
\[\text{HSD} = q_{\alpha,\,k,\,N-k} \sqrt{\frac{QM_D}{n}}\]
em que \(q_{\alpha,k,N-k}\) é o valor crítico da distribuição da amplitude estudentizada (\(k\) = número de grupos, \(N-k\) = graus de liberdade residuais/dentro da ANOVA), e \(QM_D\) é o quadrado médio dentro dos grupos da tabela ANOVA, a mesma estimativa de variância combinada que o próprio teste F usa. Qualquer par de médias de grupo cuja diferença absoluta exceda o HSD é declarado significativamente diferente.
O valor crítico da amplitude estudentizada \(q_{\alpha,k,N-k}\) é sempre maior do que o valor crítico t de duas amostras correspondente seria, e cresce com \(k\): comparar mais grupos torna mais difícil que qualquer par específico supere a barra, que é exatamente a “penalidade” que mantém a taxa de erro familiar em \(\alpha\) em vez de deixá-la inflar com cada comparação adicional. Quando \(k=2\), há apenas uma comparação possível e o teste de amplitude estudentizada se reduz a um teste t de duas amostras comum.
Aplicando o HSD de Tukey ao exemplo da dieta
A ANOVA já disse que as três dietas não são todas iguais; o HSD de Tukey é o que determina exatamente quais pares impulsionam esse resultado:
Lembre-se do exemplo de perda de peso com três dietas: Dieta A (\(n=5\), \(\bar y_A = 5{,}4\)), Dieta B (\(n=5\), \(\bar y_B = 8{,}4\)), Dieta C (\(n=5\), \(\bar y_C = 2{,}8\)). A tabela ANOVA deu \(QM_D = 1{,}100\) com \(gl_D = N-k = 12\), e o teste F global já era significativo (\(F=35{,}70\), \(p<0{,}001\)), então uma comparação post-hoc é justificada.
O valor crítico da distribuição da amplitude estudentizada para \(k=3\) grupos e \(gl_D=12\) em \(\alpha=0{,}05\) é \(q_{0{,}05,3,12} = 3{,}773\).
\[\text{HSD} = 3{,}773 \times \sqrt{\frac{1{,}100}{5}} = 3{,}773 \times 0{,}4690 = 1{,}770\]
Qualquer diferença par a par em valor absoluto maior do que 1,770 kg é estatisticamente significativa em \(\alpha=0{,}05\).
| Comparação | Diferença | IC 95% | Significativa? |
|---|---|---|---|
| B \(-\) A | 3,0 | (1,230, 4,770) | Sim (\(p=0,0019\)) |
| C \(-\) A | \(-2,6\) | (\(-4,370\), \(-0,830\)) | Sim (\(p=0,0053\)) |
| C \(-\) B | \(-5,6\) | (\(-7,370\), \(-3,830\)) | Sim (\(p<0,0001\)) |
As três diferenças par a par excedem 1,770 kg em valor absoluto, então todas as três são significativas: a Dieta B produz uma perda de peso significativamente maior do que a Dieta A, que por sua vez supera significativamente a Dieta C. As três dietas formam uma ordenação estrita, não apenas “pelo menos uma difere”.

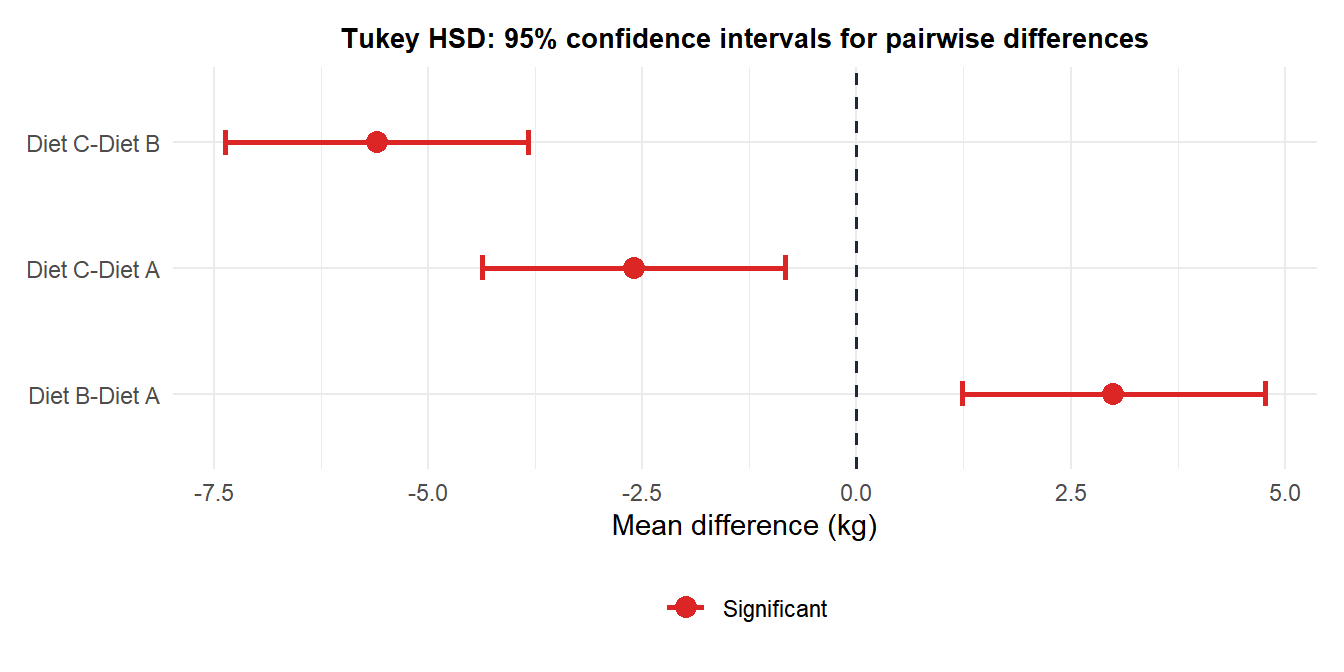
Os três marcadores aparecem em vermelho porque cada intervalo fica inteiramente de um lado do 0: nenhuma das três comparações se aproxima da linha de referência tracejada, o que é consistente com três dietas claramente separadas em efeito, não apenas distinguíveis por pouco no limiar \(\alpha=0{,}05\).
Lendo o intervalo de confiança diretamente
Um intervalo de confiança par a par que exclui 0 é exatamente equivalente a esse par ser significativo. Para B \(-\) A, o intervalo (1,230, 4,770) exclui 0, o que confirma a significância sem nem precisar olhar o valor-p. O intervalo também informa o intervalo plausível para o tamanho real do efeito: a Dieta B supera a Dieta A em algo entre aproximadamente 1,2 e 4,8 kg, informação que o valor-p isoladamente nunca revela. A mesma lógica se aplica às outras duas comparações: nenhum dos intervalos contém 0, então ambas são significativas, e ambas dão um intervalo concreto para o tamanho da diferença.
Suposições
Como o HSD de Tukey reutiliza a estimativa de variância combinada do modelo ANOVA, \(QM_D\), ele herda todas as suposições da ANOVA:
- Independência: as observações são independentes dentro de cada grupo e entre grupos.
- Normalidade: os resíduos são aproximadamente normais dentro de cada grupo, verificada com Shapiro-Wilk ou gráficos Q-Q.
- Homocedasticidade: variâncias iguais entre grupos, verificada com o teste de Levene. Esta é a que mais importa especificamente para o HSD de Tukey, já que cada comparação usa o mesmo \(QM_D\) combinado como sua estimativa de variância. Se um grupo é genuinamente mais variável do que os outros, as comparações envolvendo esse grupo recebem uma estimativa de dispersão que é muito pequena ou muito grande, distorcendo a largura de todo intervalo HSD que o toca.
Tamanhos de grupo desiguais são tratados por uma variante, o método de Tukey-Kramer, que substitui \(\sqrt{QM_D/n}\) por:
\[\sqrt{\frac{QM_D}{2}\left(\frac{1}{n_i}+\frac{1}{n_j}\right)}\]
para cada par específico \(i,j\), de modo que pares envolvendo grupos menores recebem automaticamente um intervalo mais amplo e conservador.
⚠️ O HSD de Tukey não é a única opção post-hoc, e a escolha importa
O HSD de Tukey é construído especificamente para todas as comparações par a par e é a opção mais poderosa exatamente para esse cenário. Se você só se importa em comparar cada grupo com um único grupo de referência/controle (não todos os pares entre si), o teste de Dunnett é mais poderoso porque não “paga” por comparações que você não precisa. Se você precisa testar contrastes mais gerais, não par a par (por exemplo, “a média de A e B é diferente de C?”), o método de Scheffé é a escolha apropriada, mais conservadora. A correção de Bonferroni também funciona para comparações par a par, mas geralmente é mais conservadora (menos poderosa) do que o HSD de Tukey para esse uso específico, já que o método de Tukey é adaptado exatamente ao cenário de todas as médias par a par, enquanto Bonferroni é uma correção genérica que funciona para qualquer conjunto de testes.
Executando o teste em R
TukeyHSD() recebe um objeto aov() ajustado diretamente e retorna cada comparação par a par com seu intervalo de confiança e valor-p ajustados:
loss <- c(4,5,6,5,7, 8,7,9,10,8, 3,2,4,3,2)
diet <- factor(rep(c("A","B","C"), each = 5))

fit <- aov(loss ~ diet)
summary(fit)          # confirm the omnibus F-test is significant first
TukeyHSD(fit)          # pairwise comparisons with 95% CIs
plot(TukeyHSD(fit))    # base R plot of the CIs

# Manual verification of the critical value
qtukey(0.95, nmeans = 3, df = 12)   # = 3.773
TukeyHSD() retorna colunas diff, lwr e upr para cada comparação par a par, dando a diferença de médias e seu intervalo de confiança de 95%, mais uma coluna p adj já ajustada pelo número de comparações, que pode ser comparada diretamente contra \(\alpha\) sem nenhuma correção adicional. plot(TukeyHSD(fit)) desenha o mesmo tipo de gráfico de intervalos mostrado acima usando os gráficos base do R.
💡 A ordem correta das operações
Nunca execute o HSD de Tukey (ou qualquer teste post-hoc) antes de verificar que o teste F global da ANOVA é significativo. Se a ANOVA não rejeitar \(H_0\), não há nenhuma afirmação de “pelo menos um grupo difere” para desdobrar, e testar formalmente as comparações par a par ainda assim anula completamente o propósito de controlar a taxa de erro familiar: você simplesmente voltaria ao problema bruto de testes múltiplos que a ANOVA deveria evitar.

