Correção de Bonferroni
Quando você executa muitos testes de hipóteses de uma vez, cada um individualmente em \(\alpha=0{,}05\), a chance de que pelo menos um produza um falso positivo por puro acaso cresce rapidamente com o número de testes. A correção de Bonferroni é a solução mais simples e mais usada: ela aperta o limiar de significância na proporção de quantos testes você executou.
O problema das comparações múltiplas
Com \(m\) testes independentes, cada um executado no nível de significância \(\alpha\), a probabilidade de pelo menos um falso positivo em todo o conjunto (a taxa de erro familiar, FWER) é:
\[P(\text{pelo menos um falso positivo}) = 1-(1-\alpha)^m\]
Isso cresce muito mais rápido do que a intuição sugere. Mantendo cada teste individual em \(\alpha=0{,}05\):
| Número de testes (\(m\)) | FWER: \(1-(0{,}95)^m\) |
|---|---|
| 1 | 0,050 |
| 5 | 0,226 |
| 10 | 0,401 |
| 20 | 0,642 |
Com apenas 20 testes independentes em um \(\alpha=0{,}05\) bruto cada, há aproximadamente 64% de chance de pelo menos um resultado “significativo” espúrio, mesmo que todas e cada uma das hipóteses nulas sejam exatamente verdadeiras. Executar muitos testes e reportar qualquer um que cruze \(p<0{,}05\), sem nenhum ajuste, está quase garantido a fabricar descobertas falsas.
Quando a correção é (e não é) necessária
A correção é necessária sempre que vários testes de hipóteses são considerados juntos como uma única família, e qualquer um deles sendo erroneamente chamado de significativo contaria como uma falha da afirmação geral. Situações típicas:
- Comparar todos os pares de grupos depois de uma ANOVA significativa (veja a seção de testes post-hoc do tutorial de ANOVA).
- Testar dezenas ou centenas de biomarcadores, genes, ou métricas de site em busca de uma diferença entre duas condições.
- Executar o mesmo teste repetidamente em muitos subgrupos, regiões, ou períodos de tempo, efetivamente pescando por “o que funciona”.
A correção geralmente não é necessária para um único teste de hipóteses pré-registrado e planejado com antecedência. Se você decidir de antemão exatamente qual único teste responde à sua pergunta de pesquisa e executar apenas esse teste, não há problema de comparações múltiplas a corrigir. O problema aparece especificamente quando você começa a testar muitas coisas de uma vez e trata qualquer uma delas cruzando \(p<0{,}05\) como digna de nota.
A correção de Bonferroni
A solução é notavelmente simples: divida o limiar de significância pelo número de testes \(m\).
\[\alpha_{\text{Bonferroni}} = \frac{\alpha}{m}\]
De forma equivalente, e mais comumente reportada, multiplique cada valor-p individual por \(m\) (limitado a 1) e compare o valor-p ajustado com o \(\alpha\) original:
\[p_{\text{ajust},i} = \min(p_i \times m,\ 1)\]
Ambas as formulações dão decisões idênticas: um teste passa a correção exatamente quando seu valor-p bruto está abaixo de \(\alpha/m\), que é exatamente quando seu valor-p ajustado está abaixo de \(\alpha\). Isso garante que a taxa de erro familiar permaneça em \(\alpha\) ou abaixo, independentemente de qualquer estrutura de correlação entre os testes. Funciona mesmo quando os testes não são independentes, o que é parte do motivo pelo qual continua popular apesar de ser conservadora.
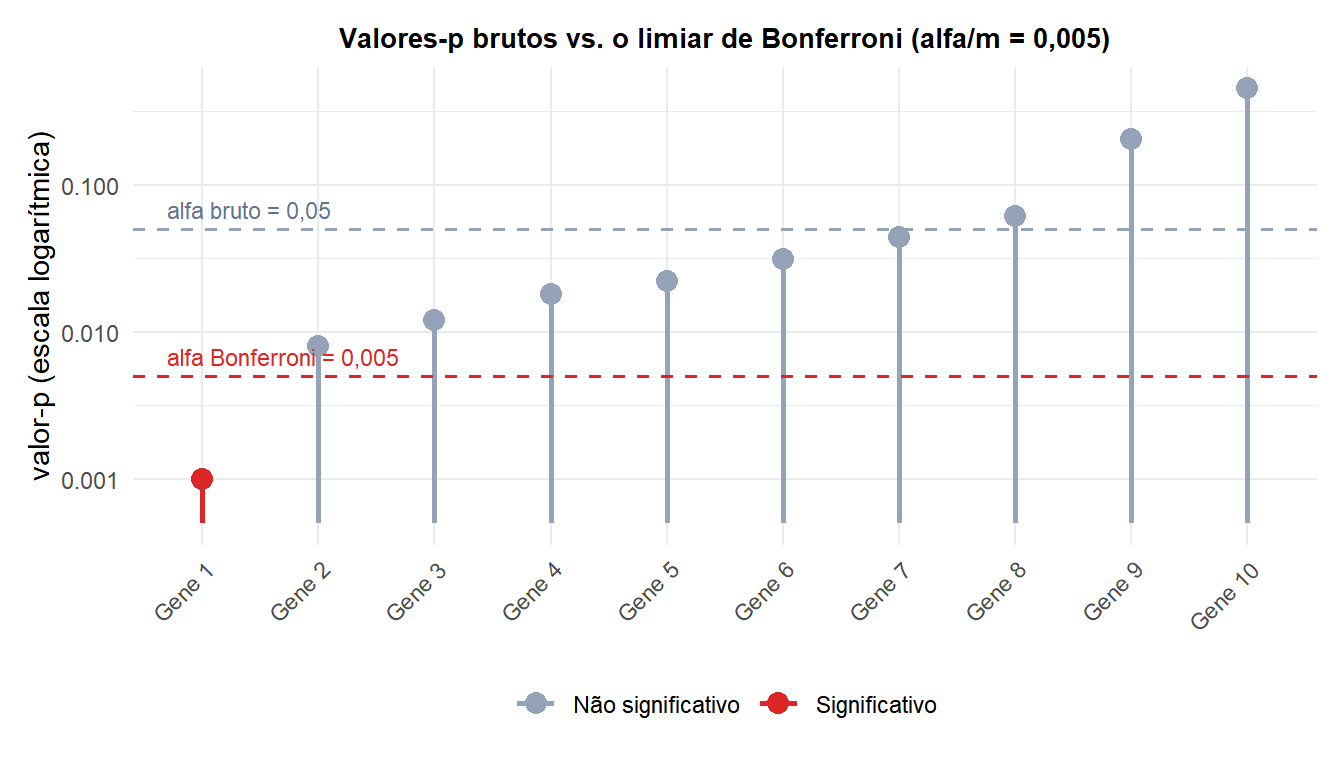
Um pesquisador compara níveis de expressão de 10 genes entre duas condições, executando 10 testes t separados e obtendo estes valores-p brutos:
\[0{,}001,\ 0{,}008,\ 0{,}012,\ 0{,}018,\ 0{,}022,\ 0{,}031,\ 0{,}044,\ 0{,}061,\ 0{,}204,\ 0{,}450\]
No limiar bruto \(\alpha=0{,}05\), 7 dos 10 genes parecem “significativos” (todos exceto os três últimos: 0,061, 0,204, 0,450). Mas com \(m=10\) testes, o limiar corrigido por Bonferroni é \(\alpha/m = 0{,}05/10 = 0{,}005\).
| Valor-p bruto | Valor-p ajustado por Bonferroni (\(p \times 10\), limitado a 1) | Significativo em \(\alpha=0{,}05\) ajustado? |
|---|---|---|
| 0,001 | 0,010 | Sim |
| 0,008 | 0,080 | Não |
| 0,012 | 0,120 | Não |
| 0,018 | 0,180 | Não |
| 0,022 | 0,220 | Não |
| 0,031 | 0,310 | Não |
| 0,044 | 0,440 | Não |
| 0,061 | 0,610 | Não |
| 0,204 | 1,000 | Não |
| 0,450 | 1,000 | Não |
Apenas 1 dos 10 genes sobrevive à correção. O que parecia 7 “achados” no limiar bruto se reduz a um único resultado robusto depois que a correção leva em conta ter executado 10 testes. Esse é todo o propósito da correção: a maioria daqueles resultados brutos “significativos” eram exatamente o tipo de falso positivo que o problema das comparações múltiplas prediz.

O método escalonado de Holm: um Bonferroni estritamente melhor
O procedimento de Holm é uniformemente mais poderoso do que o Bonferroni puro, mantendo o controle exato da taxa de erro familiar em \(\alpha\), então raramente há uma boa razão para preferir o Bonferroni puro na prática. Ele funciona como um procedimento escalonado (step-down):
- Ordene os valores-p em ordem crescente: \(p_{(1)} \leq p_{(2)} \leq \cdots \leq p_{(m)}\).
- Compare o \(i\)-ésimo menor valor-p com \(\alpha/(m-i+1)\).
- Começando de \(i=1\), rejeite cada hipótese enquanto seu valor-p estiver abaixo de seu limiar. Pare na primeira falha, e não rejeite essa hipótese nem nenhuma com um valor-p maior.
Para o exemplo de expressão genética, o procedimento de Holm também só rejeita o menor valor-p. O menor, 0,001, é comparado a \(\alpha/(10-1+1) = 0{,}05/10 = 0{,}005\) e passa. O segundo menor, 0,008, é comparado a \(\alpha/(10-2+1) = 0{,}05/9 \approx 0{,}0056\) e falha, já que \(0{,}008 > 0{,}0056\). O procedimento escalonado para ali, então a conclusão final é a mesma do Bonferroni puro neste exemplo específico: apenas 1 dos 10 genes é significativo. Mas essa coincidência é específica deste conjunto de dados, não uma regra geral: o método de Holm nunca é menos poderoso do que o Bonferroni, e frequentemente é mais poderoso, então deveria ser o padrão prático sempre que uma correção simples de erro familiar for desejada.
O motivo pelo qual Holm só pode melhorar em relação ao Bonferroni está nos próprios limiares. O Bonferroni puro compara todos os valores-p ao mesmo limiar estrito \(\alpha/m\). Os limiares escalonados de Holm começam no mesmo valor mais estrito para o menor valor-p, mas se afrouxam em cada passo seguinte, de \(\alpha/m\) até \(\alpha/(m-1)\), \(\alpha/(m-2)\), e assim por diante, já que menos hipóteses permanecem “em jogo” uma vez que as anteriores já foram rejeitadas. Isso significa que o procedimento de Holm nunca pode rejeitar menos hipóteses do que o Bonferroni, e frequentemente rejeita estritamente mais, enquanto fornece exatamente a mesma garantia de taxa de erro familiar.
⚠️ Bonferroni é conservador, e controla uma taxa de erro diferente do que você poderia esperar
Bonferroni (e Holm) controlam a taxa de erro familiar: a probabilidade de qualquer falso positivo entre todos os \(m\) testes. Esse é um padrão estrito, apropriado quando mesmo um único falso positivo seria custoso, por exemplo aprovar uma única variante de medicamento inefetiva, ou sinalizar erroneamente um único funcionário por fraude. Mas se torna extremamente conservador conforme \(m\) cresce. Em contextos exploratórios com centenas ou milhares de testes, como triar milhares de genes ou centenas de métricas de teste A/B de um site, o Bonferroni vai enterrar quase todo efeito real e verdadeiro sob um número avassalador de comparações. Para esses cenários exploratórios de grande escala, controle a taxa de descobertas falsas em vez disso (a proporção esperada de falsos positivos entre os resultados que você chama de significativos), usando o procedimento de Benjamini-Hochberg.
Benjamini-Hochberg (FDR): uma alternativa menos conservadora para testes em grande escala
O enquadramento da taxa de descobertas falsas (FDR) faz uma pergunta diferente da taxa de erro familiar. FWER pergunta “qual é a chance de algum falso positivo?”. FDR pergunta em vez disso “dos resultados que marco como significativos, qual fração é esperada ser falsa?”. Tolerar uma fração pequena e controlada de falsos positivos entre suas descobertas, em vez de se proteger contra qualquer um deles, é muito menos conservador e muito mais poderoso para detectar efeitos reais quando \(m\) é grande.
O procedimento de Benjamini-Hochberg (BH):
- Ordene os valores-p em ordem crescente: \(p_{(1)} \leq p_{(2)} \leq \cdots \leq p_{(m)}\).
- Encontre o maior \(i\) tal que \(p_{(i)} \leq \frac{i}{m}\alpha\).
- Rejeite todas as hipóteses até e incluindo essa \(i\)-ésima.
Diferentemente de Bonferroni e Holm, cujos limiares se tornam mais estritos (ou permanecem iguais) conforme \(m\) cresce, os limiares de BH, \(\frac{i}{m}\alpha\), aumentam linearmente com o rank \(i\). O maior valor-p é permitido ir até o próprio \(\alpha\), enquanto o menor é mantido no limiar mais estrito \(\alpha/m\). Essa escala deslizante é o que torna BH muito menos conservador do que um corte fixo \(\alpha/m\) aplicado a cada teste.
Aplicando BH aos mesmos 10 valores-p de genes, com \(\alpha=0{,}05\) e \(m=10\):
| Rank \(i\) | valor-p \(p_{(i)}\) | Limiar \(\frac{i}{10}\alpha\) | Abaixo do limiar? |
|---|---|---|---|
| 1 | 0,001 | 0,005 | Sim |
| 2 | 0,008 | 0,010 | Sim |
| 3 | 0,012 | 0,015 | Sim |
| 4 | 0,018 | 0,020 | Sim |
| 5 | 0,022 | 0,025 | Sim |
| 6 | 0,031 | 0,030 | Não |
| 7 | 0,044 | 0,035 | Não |
| 8 | 0,061 | 0,040 | Não |
| 9 | 0,204 | 0,045 | Não |
| 10 | 0,450 | 0,050 | Não |
O maior rank ainda abaixo de seu próprio limiar é \(i=5\), então o procedimento rejeita as primeiras 5 hipóteses (valores-p 0,001, 0,008, 0,012, 0,018 e 0,022), em comparação com apenas 1 para Bonferroni ou Holm. Observe que o rank 6 (p = 0,031) falha seu limiar mesmo que o rank 5 tenha passado: BH procura o maior rank qualificado em toda a lista ordenada, ele não simplesmente para na primeira falha como faz o procedimento escalonado de Holm.
Os mesmos dados, três números muito diferentes de resultados “significativos”: 7 no limiar bruto, 1 com Bonferroni ou Holm, e 5 com BH. Isso mostra concretamente por que escolher a correção certa para sua pergunta de pesquisa real, FWER versus FDR, importa tanto quanto corrigir por comparações múltiplas em primeiro lugar.
Executando a correção em R
Os mesmos dez valores-p acima, ajustados das três formas com uma única função integrada:
pvals <- c(0.001, 0.008, 0.012, 0.018, 0.022, 0.031, 0.044, 0.061, 0.204, 0.450)

p.adjust(pvals, method = "bonferroni")   # simplest, most conservative
p.adjust(pvals, method = "holm")         # uniformly more powerful than Bonferroni
p.adjust(pvals, method = "BH")           # Benjamini-Hochberg, controls FDR instead of FWER

# Decision at alpha = 0.05
data.frame(p = pvals,
           bonferroni = p.adjust(pvals, method = "bonferroni") < 0.05,
           holm       = p.adjust(pvals, method = "holm")       < 0.05,
           BH         = p.adjust(pvals, method = "BH")         < 0.05)
💡 Qual correção usar
Use Bonferroni apenas quando precisar da explicação mais simples possível e tiver muito poucos testes (um punhado), ou precisar de uma correção que seja garantidamente válida mesmo sob dependência desconhecida ou arbitrária entre os testes. Em quase todos os outros casos, prefira o método de Holm em vez do Bonferroni puro: ele é estritamente mais poderoso, dá a mesma garantia, e é igualmente simples de aplicar. Para triagem exploratória em grande escala, muitas dezenas ou centenas de testes, onde você pode tolerar uma fração pequena e controlada de falsos positivos entre suas descobertas em vez de se proteger contra qualquer um deles, use Benjamini-Hochberg em vez disso. A escolha certa depende de se um único falso positivo seria custoso (use FWER: Bonferroni ou Holm) ou se você principalmente quer controlar a proporção geral de pistas falsas entre seus achados (use FDR: Benjamini-Hochberg).

