Teste exato de Fisher
O teste exato de Fisher calcula um valor-p exato para uma tabela de contingência 2x2. Diferentemente do teste qui-quadrado, ele não depende de uma aproximação de amostra grande: ele condiciona os totais marginais fixos da tabela e calcula as probabilidades diretamente a partir da distribuição hipergeométrica, o que o torna confiável mesmo com amostras muito pequenas.
Por que um teste exato?
Considere uma tabela 2x2 com células \(a, b, c, d\), em que as linhas somam \(a+b\) e \(c+d\), as colunas somam \(a+c\) e \(b+d\), e o total geral é \(n\):
| Resultado 1 | Resultado 2 | Total | |
|---|---|---|---|
| Grupo 1 | \(a\) | \(b\) | \(a+b\) |
| Grupo 2 | \(c\) | \(d\) | \(c+d\) |
| Total | \(a+c\) | \(b+d\) | \(n\) |
Se condicionarmos todos os quatro totais marginais como fixos, apenas a célula \(a\) é livre para variar: uma vez que \(a\) é conhecido, \(b\), \(c\) e \(d\) ficam todos determinados por subtração a partir das margens. Sob \(H_0\) de independência, \(a\) segue então uma distribuição hipergeométrica:
\[P(a) = \frac{\binom{a+b}{a}\binom{c+d}{c}}{\binom{n}{a+c}}\]
Essa é exatamente a probabilidade de obter \(a\) “sucessos” ao amostrar \(a+c\) itens sem reposição de uma população de \(n\) itens contendo \(a+b\) sucessos no total. Como essa probabilidade é calculada diretamente, sem depender de nenhuma aproximação de amostra grande, o valor-p resultante é exato, e não assintótico. O valor-p exato soma as probabilidades hipergeométricas de todas as tabelas pelo menos tão extremas quanto a observada, ou seja, todas as tabelas com as mesmas margens fixas que apoiam \(H_1\) tanto quanto a tabela observada, ou mais.
Hipóteses
| Teste | \(H_0\) | \(H_1\) |
|---|---|---|
| Bilateral | as variáveis são independentes (OR = 1) | as variáveis estão associadas (OR \(\neq\) 1) |
| Unilateral (menor) | OR \(\geq\) 1 | OR \(<\) 1 |
| Unilateral (maior) | OR \(\leq\) 1 | OR \(>\) 1 |
\(H_0\) afirma que as duas variáveis categóricas são independentes, o que equivale a dizer que a razão de chances é igual a 1. \(H_1\) para o teste bilateral afirma que as variáveis estão associadas, ou seja, que a razão de chances difere de 1. As versões unilaterais testam uma direção específica de associação, escolhida antes de observar os dados.
A razão de chances
A razão de chances (odds ratio) mede a força e a direção da associação:
\[\text{OR} = \frac{ad}{bc}\]
Uma razão de chances de 1 significa nenhuma associação: as chances do resultado são as mesmas em ambos os grupos. Uma razão de chances maior do que 1 significa que o resultado é mais provável na primeira linha ou grupo, enquanto uma razão de chances menor do que 1 significa que é menos provável.
A função fisher.test() do R não reporta esse simples produto cruzado. Em vez disso, ela reporta uma estimativa corrigida por viés conhecida como estimativa de máxima verossimilhança condicional (MLE condicional) da razão de chances. Esse valor é próximo, mas não idêntico, a \(ad/bc\). Ambas são estimativas legítimas da mesma associação subjacente; o produto cruzado simples é mais fácil de calcular manualmente, enquanto a MLE condicional é a que corresponde ao intervalo de confiança que o R reporta junto com o valor-p.
Exemplos
Exemplo 1: pequeno ensaio clínico, novo medicamento vs. placebo (bilateral)
Um pequeno ensaio tem poucos pacientes demais para que a aproximação qui-quadrado seja confiável:
| Melhorou | Não melhorou | Total | |
|---|---|---|---|
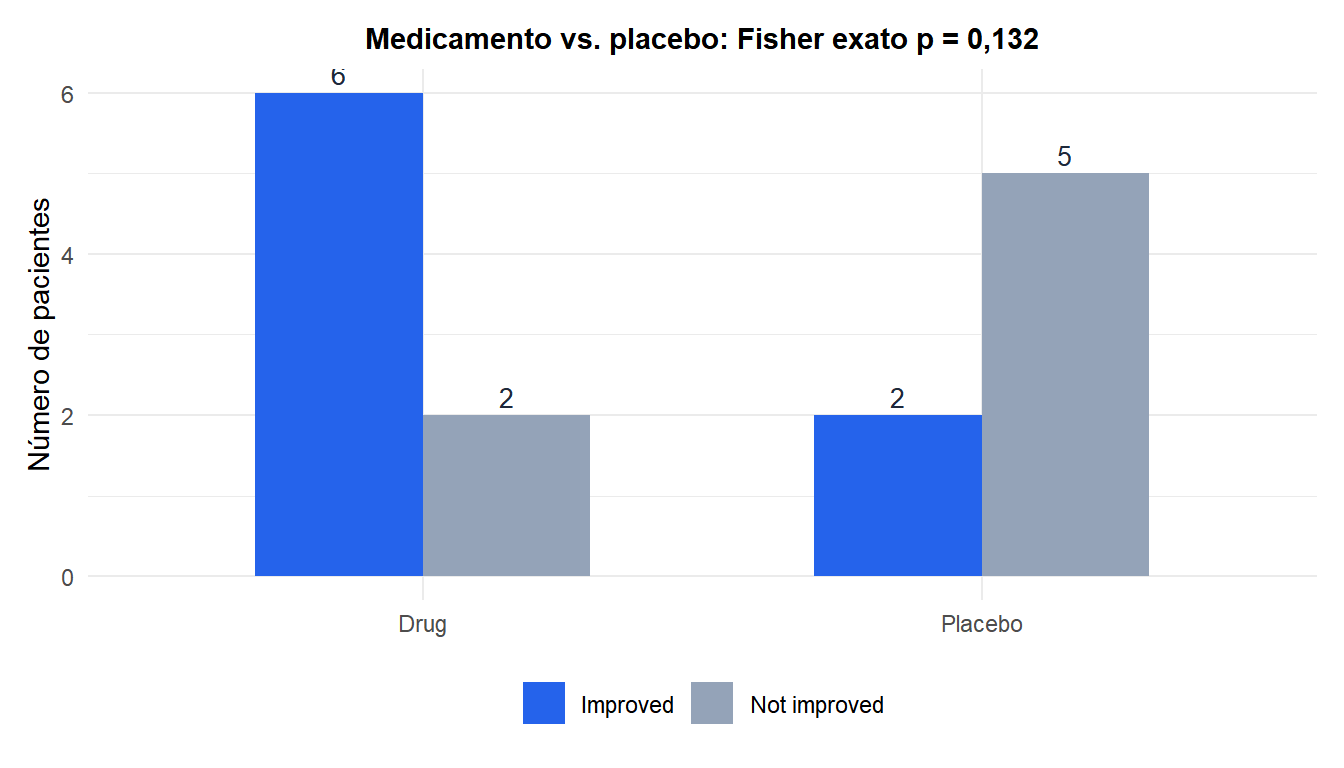
| Medicamento | 6 | 2 | 8 |
| Placebo | 2 | 5 | 7 |
| Total | 8 | 7 | 15 |
As contagens esperadas aqui chegam a ser tão baixas quanto 3,27 em uma célula, bem abaixo da regra prática usual de 5, então o qui-quadrado não seria confiável.
Razão de chances por produto cruzado: \(OR = (6 \times 5)/(2 \times 2) = 30/4 = 7{,}5\).
O teste exato de Fisher (estimativa MLE condicional do R: OR = 6,40) dá um valor-p bilateral de 0,132.
Decisão: não rejeitamos \(H_0\) com \(\alpha=0{,}05\). Apesar da razão de chances descritivamente grande, a amostra é pequena demais para considerar a associação estatisticamente significativa.

Exemplo 2: ensaio de eficácia de vacina (unilateral)
15 pessoas são vacinadas, 15 não são; o resultado é se contraíram gripe naquela temporada:
| Gripe | Sem gripe | Total | |
|---|---|---|---|
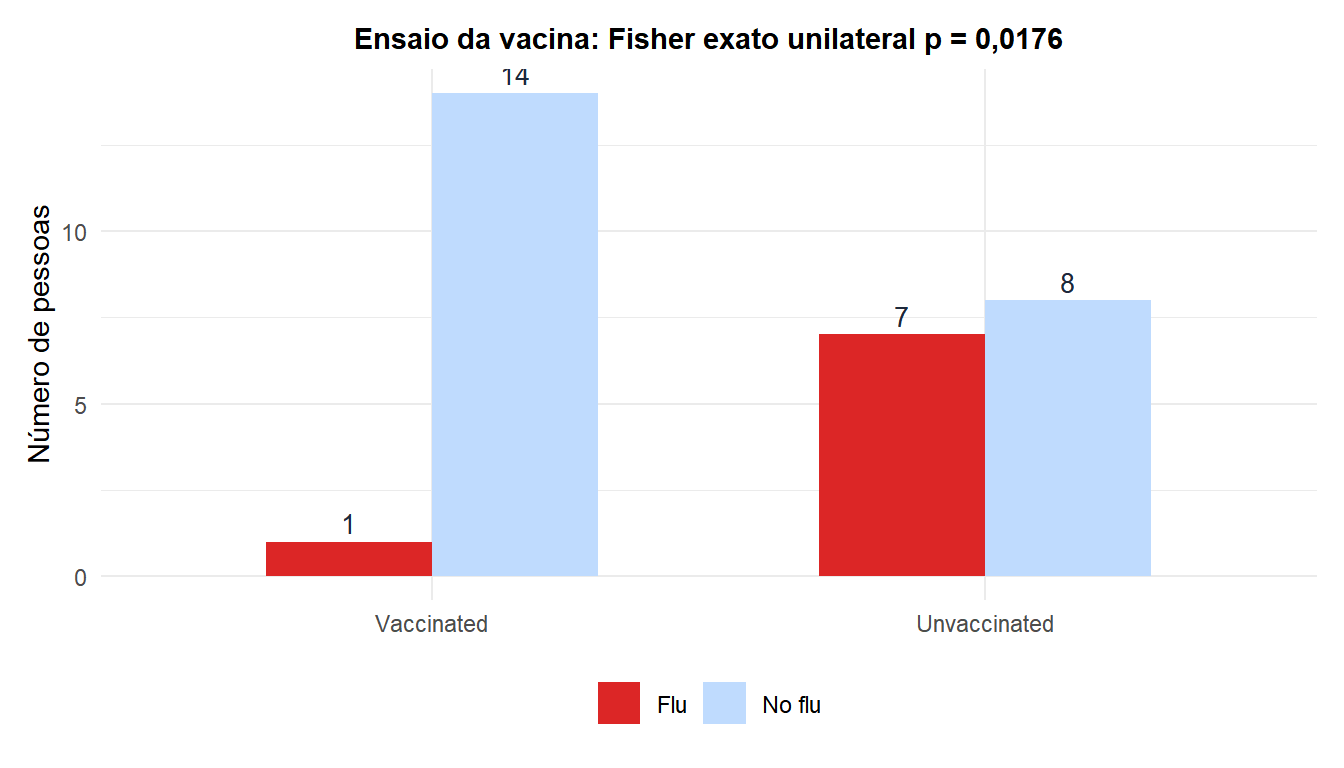
| Vacinados | 1 | 14 | 15 |
| Não vacinados | 7 | 8 | 15 |
| Total | 8 | 22 | 30 |
Hipóteses: \(H_0\): a vacinação não reduz o risco de gripe (OR \(\geq\) 1) vs. \(H_1\): a vacinação reduz o risco de gripe (OR \(<\) 1), um teste unilateral já que os pesquisadores têm uma hipótese direcional específica.
Razão de chances por produto cruzado: \(OR = (1 \times 8)/(14 \times 7) = 8/98 \approx 0{,}082\).
Valor-p unilateral (“menor”): 0,0176. Valor-p bilateral (para comparação): 0,0352.
Decisão (unilateral): rejeitamos \(H_0\) com \(\alpha=0{,}05\). Há evidência significativa de que a vacinação reduz o risco de gripe nesta amostra.
Suposições
O teste exato de Fisher exige:
- Margens fixas: tanto os totais das linhas quanto os das colunas são tratados como fixos. Essa é a formulação clássica e condicional do teste; tratar ambas as margens como fixas é, em si, um debate estatístico de longa data, mas continua sendo a abordagem prática padrão.
- Independência: as observações são independentes entre si.
- Nenhuma restrição de tamanho de amostra: diferentemente do qui-quadrado, não há exigência sobre as contagens esperadas das células. Esse é justamente o propósito do teste: ele funciona mesmo quando a regra prática do qui-quadrado (contagens esperadas \(\geq 5\)) falha.
O teste exato de Fisher normalmente é usado apenas para tabelas 2x2. Tabelas maiores precisam da extensão generalizada de Freeman-Halton, computacionalmente intensiva, mas disponível via fisher.test() no R, que também lida com tabelas \(r \times c\) por simulação para tabelas grandes (simulate.p.value = TRUE).
⚠️ O teste exato de Fisher não é sempre mais poderoso, e pode ser conservador
Um erro comum: “exato” não significa “mais poderoso”. Como a estatística do teste (a contagem em uma célula) é discreta, os valores-p alcançáveis formam um conjunto discreto e grosseiro, então o teste pode ser conservador: sua taxa real de rejeição sob \(H_0\) pode ficar notavelmente abaixo do \(\alpha\) nominal, especialmente com tabelas pequenas e desequilibradas. Essa é uma compensação real em relação à aproximação qui-quadrado, que é anticonservadora nesse mesmo regime de amostra pequena, em vez do contrário.
Na prática: use qui-quadrado quando todas as contagens esperadas forem \(\geq 5\), use o teste exato de Fisher quando não forem, e não espere que o teste exato de Fisher detecte automaticamente um efeito real só porque ele calcula uma resposta “exata”.
Executando o teste em R
Os dois exemplos 2x2 acima, mais uma variante unilateral e uma tabela maior resolvida por simulação, tudo através da mesma função fisher.test():
# Example 1: clinical trial
tab1 <- matrix(c(6, 2, 2, 5), nrow = 2, byrow = TRUE)
fisher.test(tab1)                          # two-sided by default

# Example 2: vaccine trial (one-sided)
tab2 <- matrix(c(1, 14, 7, 8), nrow = 2, byrow = TRUE)
fisher.test(tab2, alternative = "less")    # one-sided
fisher.test(tab2)                          # two-sided, for comparison

# Larger tables (Freeman-Halton extension via simulation)
fisher.test(table_rxc, simulate.p.value = TRUE, B = 10000)
A saída inclui o valor-p, a estimativa MLE condicional da razão de chances, e um intervalo de confiança para a razão de chances. O argumento alternative controla se o teste é bilateral (o padrão) ou unilateral ("less" ou "greater").
💡 Teste exato de Fisher vs. qui-quadrado: a regra de decisão
Use o teste exato de Fisher para tabelas 2x2 quando qualquer contagem esperada de célula estiver abaixo de 5 (a regra prática usual da aproximação qui-quadrado), ou sempre que o tamanho total da amostra for pequeno, independentemente das contagens exatas. Use qui-quadrado para tabelas maiores e bem balanceadas: é computacionalmente mais leve e suas suposições já são atendidas. Para tabelas maiores que 2x2 com contagens pequenas, use fisher.test(..., simulate.p.value = TRUE) em vez da aproximação clássica de aderência qui-quadrado.

