Teste qui-quadrado
O teste qui-quadrado é o método padrão para analisar dados categóricos. Ele existe em duas formas: o teste de independência (duas variáveis categóricas estão associadas?) e o teste de aderência (uma variável categórica segue uma distribuição específica?). Ambos usam a mesma estatística de teste e a distribuição qui-quadrado como referência. Para uma pergunta de aderência sobre uma variável contínua em vez de categórica, veja o teste de Kolmogorov-Smirnov.
A estatística qui-quadrado
Ambos os testes compartilham a mesma ideia central: comparar as frequências observadas \(O_i\) com as frequências esperadas \(E_i\) sob \(H_0\).
\[\chi^2 = \sum \frac{(O_i - E_i)^2}{E_i}\]
Valores grandes de \(\chi^2\) indicam que os dados observados estão distantes do que \(H_0\) prevê. Sob \(H_0\), essa estatística segue uma distribuição \(\chi^2\) cujos graus de liberdade dependem do tipo de teste.
Teste de independência
Usado para testar se duas variáveis categóricas estão associadas em uma tabela de contingência.
Hipóteses: \(H_0\): as duas variáveis são independentes. \(H_1\): existe associação.
Frequências esperadas para cada célula \((i, j)\):
\[E_{ij} = \frac{\text{total da linha}_i \times \text{total da coluna}_j}{\text{total geral}}\]
Graus de liberdade: \(gl = (l-1)(c-1)\), em que \(l\) = número de linhas e \(c\) = número de colunas.
Uma pesquisa com 200 pessoas registra o gênero (Masculino/Feminino) e a preferência pelo produto (Gosta/Não gosta):
| Gosta | Não gosta | Total | |
|---|---|---|---|
| Masculino | 60 | 40 | 100 |
| Feminino | 30 | 70 | 100 |
| Total | 90 | 110 | 200 |
Frequências esperadas sob independência:
\[E_{11} = \frac{100 \times 90}{200} = 45, \quad E_{12} = \frac{100 \times 110}{200} = 55\] \[E_{21} = \frac{100 \times 90}{200} = 45, \quad E_{22} = \frac{100 \times 110}{200} = 55\]
Estatística do teste:
\[\chi^2 = \frac{(60-45)^2}{45} + \frac{(40-55)^2}{55} + \frac{(30-45)^2}{45} + \frac{(70-55)^2}{55}\] \[= 5{,}000 + 4{,}091 + 5{,}000 + 4{,}091 = 18{,}182\]
\(gl = (2-1)(2-1) = 1\). Valor crítico com \(\alpha=0{,}05\): \(\chi^2_{0{,}05,1} = 3{,}841\).
Como \(18{,}182 > 3{,}841\), rejeitamos \(H_0\). Há uma associação significativa entre gênero e preferência de produto.

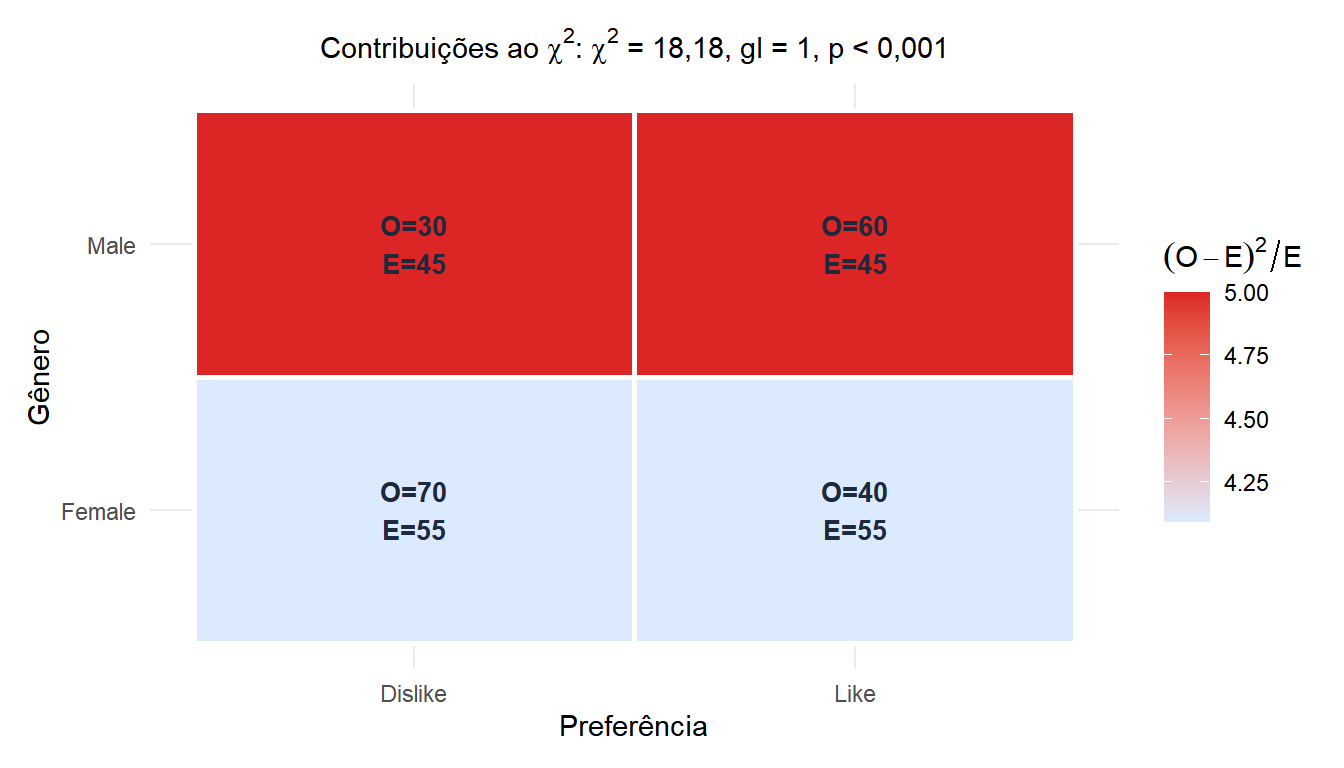
O mapa de calor mostra a contribuição de cada célula para o \(\chi^2\): células mais vermelhas desviam mais da independência.
Tamanho de efeito: V de Cramér
O valor-p diz se a associação é significativa, não quão forte ela é. Para tabelas de contingência, use o V de Cramér:
\[V = \sqrt{\frac{\chi^2}{n \times \min(l-1, c-1)}}\]
\(V\) varia de 0 (sem associação) a 1 (associação perfeita). Para uma tabela \(2 \times 2\), ele é igual ao valor absoluto do coeficiente phi.
Para o exemplo: \(V = \sqrt{18{,}182 / (200 \times 1)} = \sqrt{0{,}0909} \approx 0{,}301\). Uma associação moderada.
⚠️ Significância estatística não é o mesmo que associação forte
Com amostras grandes, mesmo associações triviais produzem estatísticas qui-quadrado significativas. Uma pesquisa com 10.000 pessoas pode encontrar \(\chi^2 = 5{,}2\) (\(p = 0{,}023\)) para uma associação com \(V = 0{,}02\): estatisticamente significativa, mas praticamente desprezível.
Sempre reporte o V de Cramér junto com o valor-p. Como guia aproximado: \(V < 0{,}1\) é fraca, \(0{,}1 \leq V < 0{,}3\) é moderada, \(V \geq 0{,}3\) é forte.
Teste de aderência
Usado para testar se uma única variável categórica segue uma distribuição específica.
Hipóteses: \(H_0\): a variável segue a distribuição especificada. \(H_1\): não segue.
Graus de liberdade: \(gl = k - 1\), em que \(k\) é o número de categorias.
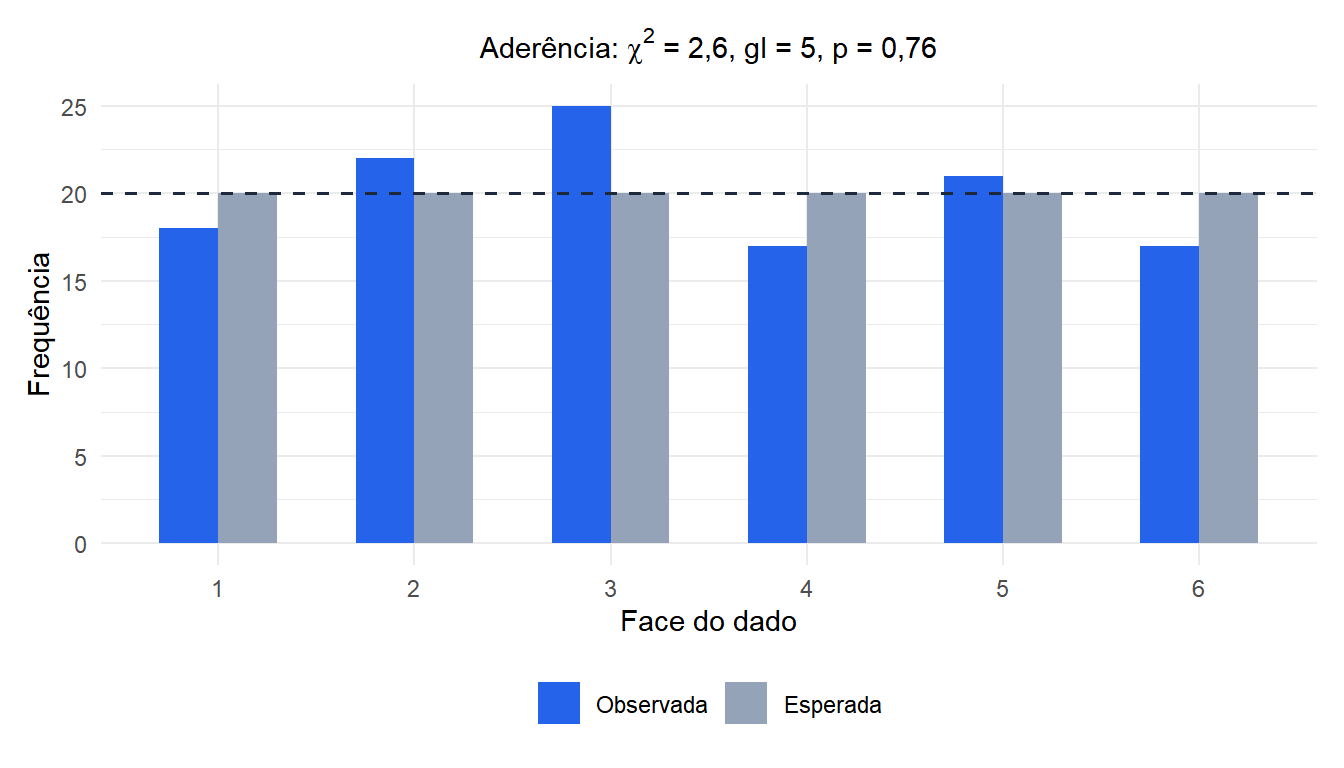
Um dado é lançado 120 vezes. Se for honesto, cada face deveria aparecer 20 vezes. Contagens observadas:
| Face | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
| Observada | 18 | 22 | 25 | 17 | 21 | 17 |
| Esperada | 20 | 20 | 20 | 20 | 20 | 20 |
\[\chi^2 = \frac{(18-20)^2}{20} + \frac{(22-20)^2}{20} + \frac{(25-20)^2}{20} + \frac{(17-20)^2}{20} + \frac{(21-20)^2}{20} + \frac{(17-20)^2}{20}\] \[= 0{,}2 + 0{,}2 + 1{,}25 + 0{,}45 + 0{,}05 + 0{,}45 = 2{,}6\]
\(gl = 6 - 1 = 5\). Valor crítico com \(\alpha=0{,}05\): \(\chi^2_{0{,}05,5} = 11{,}07\).
Como \(2{,}6 < 11{,}07\), não rejeitamos \(H_0\). Nenhuma evidência significativa de que o dado seja desonesto.
Suposições
Ambos os testes qui-quadrado exigem:
- Independência: as observações não são pareadas nem agrupadas.
- Frequências esperadas \(\geq 5\): cada célula da tabela deve ter uma frequência esperada de pelo menos 5. Se isso for violado, combine categorias ou use o teste exato de Fisher (para tabelas \(2 \times 2\)).
- Contagens, não porcentagens: a estatística do teste deve ser calculada a partir de contagens brutas, não de proporções.
⚠️ Os testes qui-quadrado não identificam quais células impulsionam a associação
Um resultado significativo em uma tabela de contingência grande indica que existe uma associação em algum lugar, mas não onde. Use resíduos padronizados para identificar quais células se desviam mais da independência:
\[r_{ij} = \frac{O_{ij} - E_{ij}}{\sqrt{E_{ij}}}\]
Células com \(|r_{ij}| > 2\) estão contribuindo significativamente para o \(\chi^2\) global. No R: chisq.test(table)$residuals.
Executando os testes em R
Ambos os testes estão disponíveis no R base. Para o teste de independência, passe a tabela de contingência para chisq.test(). Para a aderência, passe as contagens observadas e, opcionalmente, as probabilidades esperadas. O argumento correct = FALSE desativa a correção de continuidade de Yates, que raramente é necessária com amostras grandes, mas é aplicada por padrão em tabelas \(2 \times 2\).
# Test of independence
table_data <- matrix(c(60, 40, 30, 70), nrow = 2)
chisq.test(table_data, correct = FALSE)

# Cramér's V (package rstatix or vcd)
library(vcd)
assocstats(table_data)

# Goodness-of-fit
observed <- c(18, 22, 25, 17, 21, 17)
chisq.test(observed)  # tests against uniform by default
A saída inclui a estatística do teste, os graus de liberdade, e o valor-p. Os resíduos padronizados são acessíveis via chisq.test(table_data)$residuals, o que ajuda a identificar quais células impulsionam um resultado significativo.
💡 Escolhendo entre qui-quadrado e o teste exato de Fisher
Para tabelas \(2 \times 2\) com amostras pequenas (qualquer frequência esperada \(< 5\)), use o teste exato de Fisher (fisher.test() no R). Ele calcula o valor-p exato a partir da distribuição hipergeométrica e não exige amostras grandes. Para tabelas maiores, o qui-quadrado é a abordagem padrão.

