Desvio padrão e variância em estatística
A variância e o desvio padrão medem o quanto os valores de um conjunto de dados se dispersam em torno da média. São as medidas de dispersão mais usadas em estatística, e entender suas diferenças, incluindo quando dividir por \(n\) ou por \(n-1\), é fundamental.
Definições
Variância
A variância mede a distância quadrática média de cada observação em relação à média. Elevar as diferenças ao quadrado tem dois propósitos: torna todos os valores positivos e penaliza os desvios grandes mais do que os pequenos.
Existem duas versões dependendo de você estar trabalhando com uma população completa ou com uma amostra.
Variância populacional (quando você tem dados de toda a população):
\[ \sigma^2 = \frac{1}{n} \sum_{i=1}^{n} (x_i - \bar{x})^2 \]
Variância amostral (quando você trabalha com uma amostra e quer estimar a variância populacional):
\[ s^2 = \frac{1}{n-1} \sum_{i=1}^{n} (x_i - \bar{x})^2 \]
⚠️ Variância populacional vs. variância amostral: a correção de n-1
Dividir por (n-1) em vez de (n) na fórmula amostral é chamado de correção de Bessel. O motivo: ao calcular a média a partir de uma amostra, você já está usando os dados para estimar um parâmetro. Isso deixa apenas (n-1) unidades de informação independentes. Dividir por (n) subestima sistematicamente a verdadeira variância populacional. Dividir por (n-1) corrige esse viés.
Na prática: se os seus dados são a população completa, use \(n\). Se os seus dados são uma amostra (que é quase sempre o caso), use \(n-1\). A maioria dos softwares, incluindo a função var() do R, usa \(n-1\) por padrão.
Desvio padrão
O desvio padrão é a raiz quadrada da variância. A principal vantagem sobre a variância é que ele é expresso nas mesmas unidades dos dados originais, o que o torna diretamente interpretável.
Desvio padrão populacional:
\[ \sigma = \sqrt{\frac{1}{n} \sum_{i=1}^{n} (x_i - \bar{x})^2} \]
Desvio padrão amostral:
\[ s = \sqrt{\frac{1}{n-1} \sum_{i=1}^{n} (x_i - \bar{x})^2} \]
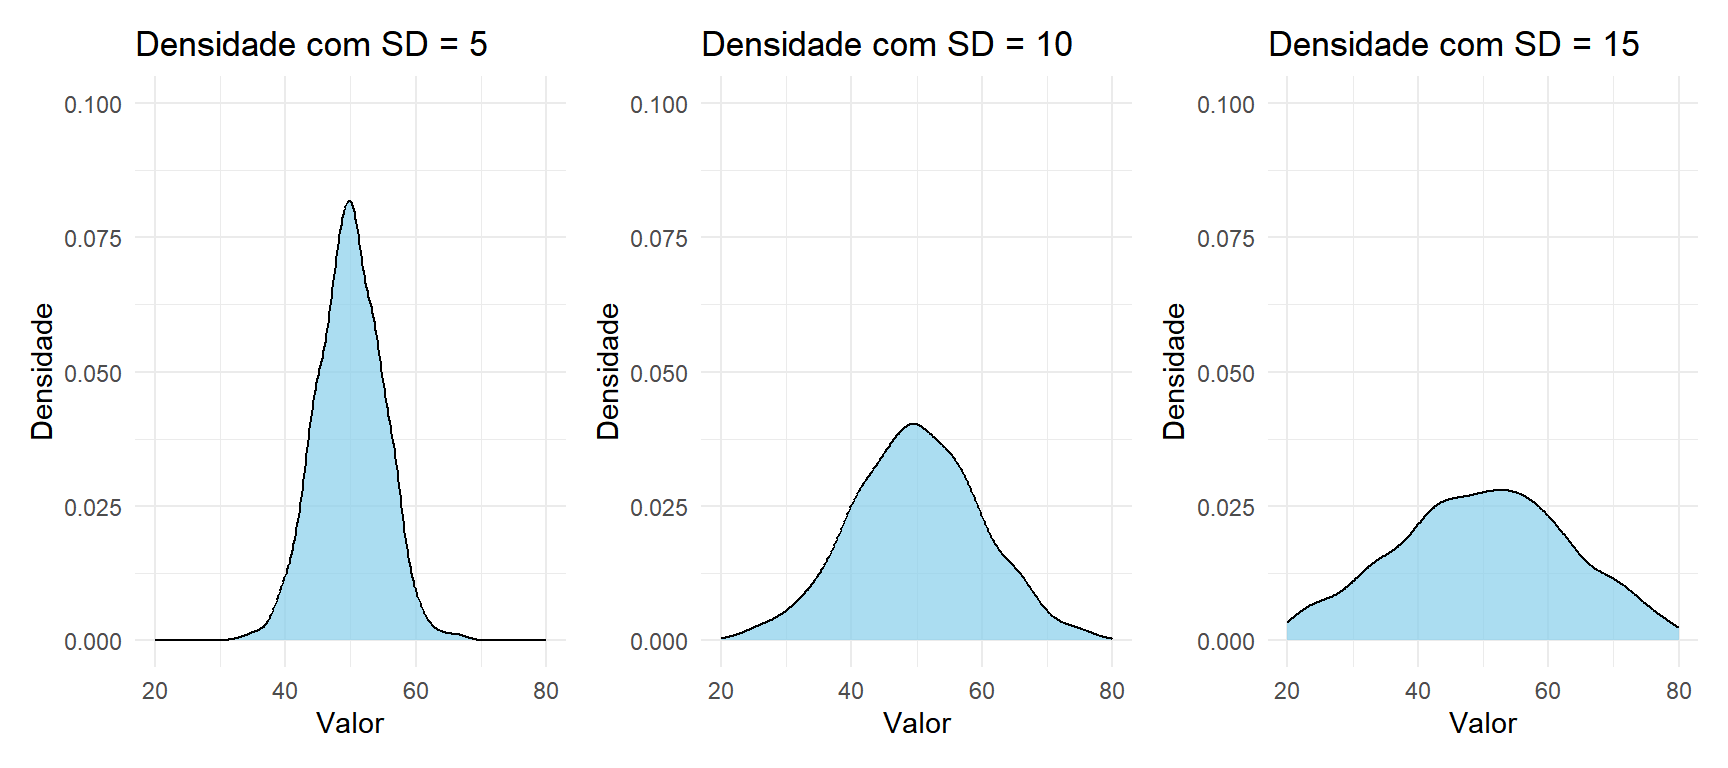
Figure 1: Mesma média, desvios padrão diferentes: um SD maior significa uma distribuição mais larga e mais achatada
Propriedades
- Não negativas: tanto a variância quanto o desvio padrão são sempre \(\geq 0\). Valem zero apenas quando todos os valores são idênticos.
- Mesmas unidades: o desvio padrão está nas mesmas unidades que os dados. A variância está em unidades ao quadrado, e é por isso que o desvio padrão costuma ser preferido para interpretação.
- Sensíveis a outliers: ambas as medidas são afetadas por valores extremos, já que os desvios são elevados ao quadrado. Um único outlier pode inflar a variância substancialmente.
- Transformação linear: se \(Y = aX + b\), então \(\sigma_Y = |a| \cdot \sigma_X\) e \(\sigma_Y^2 = a^2 \cdot \sigma_X^2\). Somar uma constante não muda a dispersão; multiplicar a reescala.
⚠️ Variância e desvio padrão não são intercambiáveis
Um erro comum de prova é usar a variância e o desvio padrão como se medissem a mesma coisa na mesma escala. Se o desvio padrão das notas de uma prova é 8 pontos, a variância é 64 pontos². Reportar uma variância de 64 como se fossem “64 pontos de dispersão” está errado: são 64 pontos ao quadrado. Reporte sempre o desvio padrão quando precisar de uma medida de dispersão interpretável nas unidades originais.
Exemplos
Exemplo 1: cálculo passo a passo
Uma equipe de controle de qualidade mede o peso (em gramas) de 5 itens de um lote de produção: \(85, 90, 88, 92, 78\).
Passo 1: calcular a média.
\[\bar{x} = \frac{85 + 90 + 88 + 92 + 78}{5} = 86{,}6 \text{ g}\]
Passo 2: calcular os desvios ao quadrado em relação à média.
| \(x_i\) | \(x_i - \bar{x}\) | \((x_i - \bar{x})^2\) |
|---|---|---|
| 85 | \(-1{,}6\) | \(2{,}56\) |
| 90 | \(3{,}4\) | \(11{,}56\) |
| 88 | \(1{,}4\) | \(1{,}96\) |
| 92 | \(5{,}4\) | \(29{,}16\) |
| 78 | \(-8{,}6\) | \(73{,}96\) |
| Soma | \(119{,}2\) |
Passo 3: calcular a variância e o desvio padrão.
Como se trata de uma amostra (não o lote completo), usamos \(n - 1 = 4\):
\[s^2 = \frac{119{,}2}{4} = 29{,}8 \text{ g}^2\]
\[s = \sqrt{29{,}8} \approx 5{,}46 \text{ g}\]
O item típico se desvia cerca de 5,5 gramas do peso médio.
Exemplo 2: o efeito de um outlier
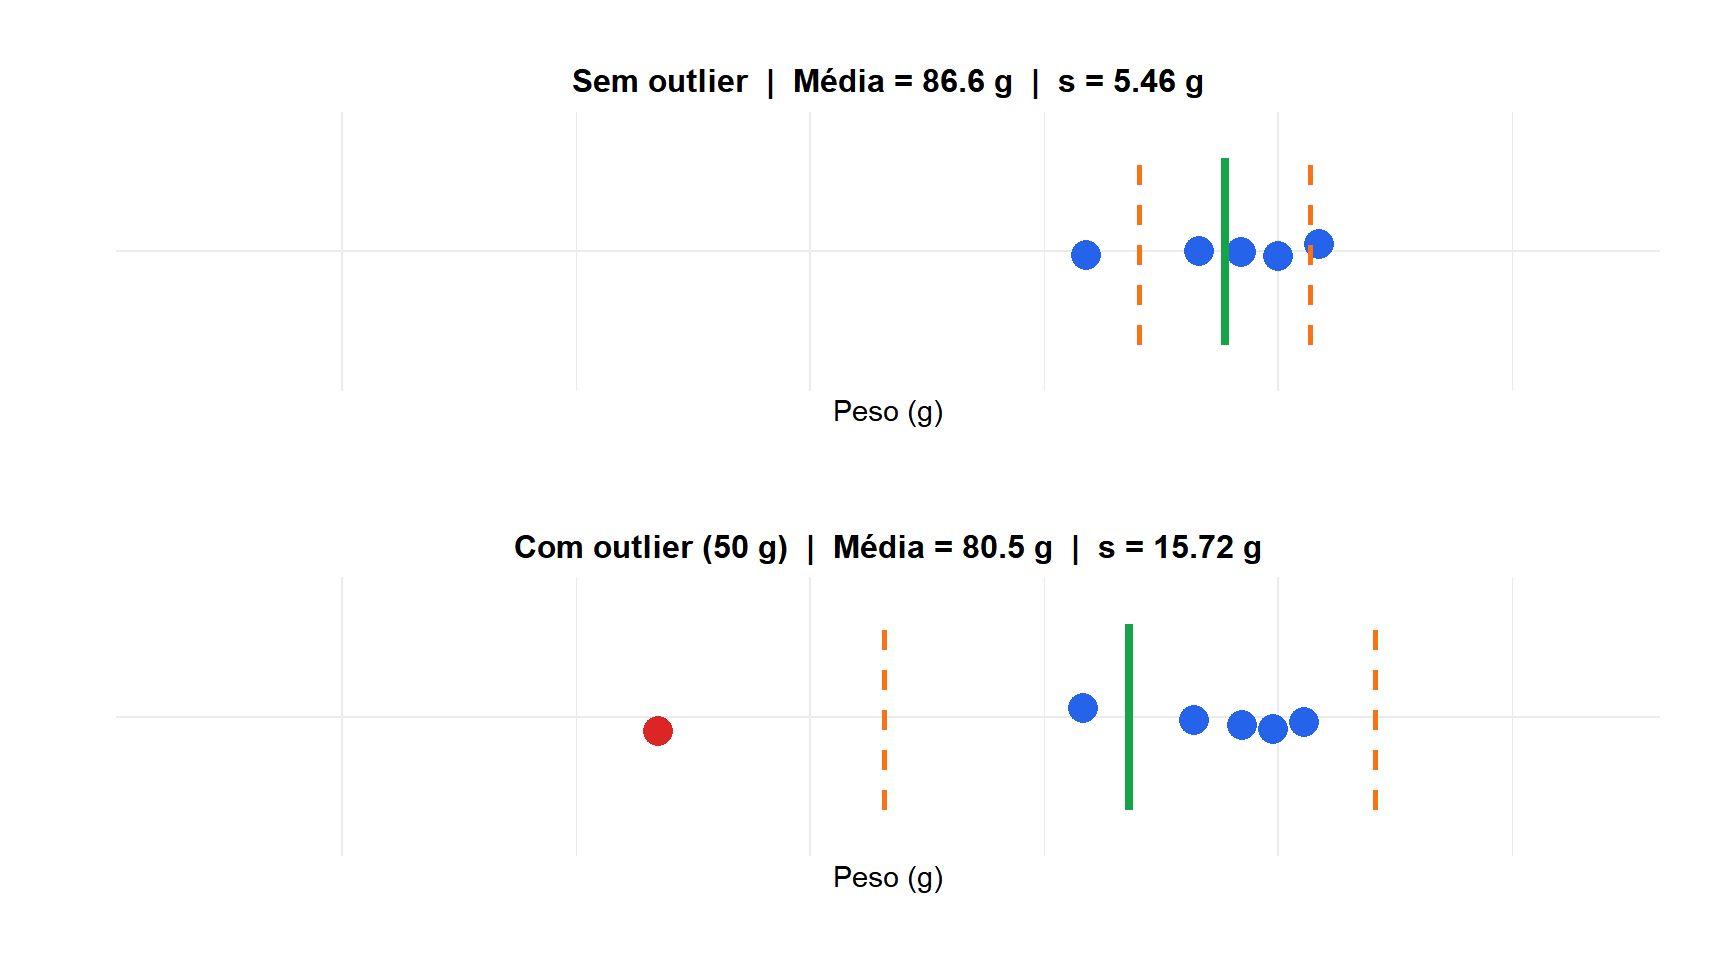
Agora suponha que um item defeituoso passe despercebido, com peso de 50 g. O novo conjunto de dados é: \(85, 90, 88, 92, 78, 50\).
\[\bar{x} = \frac{85 + 90 + 88 + 92 + 78 + 50}{6} = 80{,}5 \text{ g}\]
\[s^2 = \frac{(85-80{,}5)^2 + (90-80{,}5)^2 + (88-80{,}5)^2 + (92-80{,}5)^2 + (78-80{,}5)^2 + (50-80{,}5)^2}{5} = \frac{1215{,}5}{5} = 243{,}1 \text{ g}^2\]
\[s = \sqrt{243{,}1} \approx 15{,}59 \text{ g}\]
Um único item defeituoso triplicou o desvio padrão, de 5,46 g para 15,59 g. É por isso que o desvio padrão é sensível a outliers: o termo ao quadrado amplifica os desvios extremos.
💡 Quando usar o desvio padrão em vez de outras medidas de dispersão

