Intervalo de confiança vs. intervalo de predição
Um intervalo de confiança estima onde está, de fato, um parâmetro populacional, como a verdadeira média \(\mu\). Um intervalo de predição estima onde uma única observação futura vai cair. O segundo é sempre mais amplo, muitas vezes bem mais amplo, porque precisa levar em conta tanto a incerteza na estimação do parâmetro quanto a variabilidade natural das observações individuais em torno dele.
As duas fórmulas, lado a lado
Para uma amostra de tamanho \(n\) de uma população normal, com média amostral \(\bar{x}\) e desvio padrão amostral \(S\):
\[\text{IC para } \mu: \quad \bar{x} \pm t_{\alpha/2,\,n-1} \cdot \frac{S}{\sqrt{n}}\]
\[\text{IP para uma nova observa\c{c}\~{a}o}: \quad \bar{x} \pm t_{\alpha/2,\,n-1} \cdot S\sqrt{1 + \frac{1}{n}}\]
As duas fórmulas compartilham o mesmo centro e o mesmo valor crítico \(t_{\alpha/2,\,n-1}\); a única diferença está no que fica dentro da raiz quadrada. O erro padrão do intervalo de confiança, \(S/\sqrt{n}\), captura apenas com que precisão \(\bar{x}\) estima \(\mu\). O intervalo de predição adiciona um “+1” dentro da raiz quadrada, que é exatamente a variância extra de uma nova observação individual em torno da verdadeira média, uma fonte de incerteza que não tem nada a ver com o tamanho da amostra.
Esse “+1” é toda a história: conforme \(n \to \infty\), \(S/\sqrt{n} \to 0\) e o intervalo de confiança colapsa em direção a um único ponto, mas \(S\sqrt{1 + 1/n} \to S\), então o intervalo de predição se estreita apenas levemente e se estabiliza em uma largura mínima definida pela própria dispersão da população. Nenhuma quantidade de dados adicionais jamais tornará uma única observação futura perfeitamente previsível.
Exemplo resolvido: uma média amostral
Os dois intervalos partem exatamente da mesma amostra; a única coisa que muda é qual pergunta está sendo feita a ela.
Uma amostra de \(n=25\) medições de tempo de reação dá \(\bar{x} = 255{,}63\) ms e \(S = 39{,}19\) ms. Com \(t_{0{,}025,\,24} = 2{,}064\):
| Fórmula | Intervalo | Amplitude | |
|---|---|---|---|
| IC de 95% para \(\mu\) | \(255{,}63 \pm 2{,}064 \times 39{,}19/\sqrt{25}\) | [239,45, 271,80] | 32,35 |
| IP de 95% para um novo valor | \(255{,}63 \pm 2{,}064 \times 39{,}19\sqrt{1+1/25}\) | [173,14, 338,11] | 164,98 |
O intervalo de predição é cerca de 5,1 vezes mais amplo do que o intervalo de confiança, para exatamente a mesma amostra. O intervalo de confiança diz “o tempo de reação médio real está quase com certeza entre 239 e 272 ms”. O intervalo de predição diz algo muito mais amplo: “uma nova medição individual desse processo poderia plausivelmente cair em qualquer lugar entre 173 e 338 ms”. As duas afirmações estão corretas, elas apenas respondem a perguntas diferentes.

A mesma distinção na regressão
A diferença entre os dois intervalos é mais fácil de ver em uma regressão linear simples, em que ambos podem ser lidos na mesma reta ajustada em qualquer valor de \(x\).
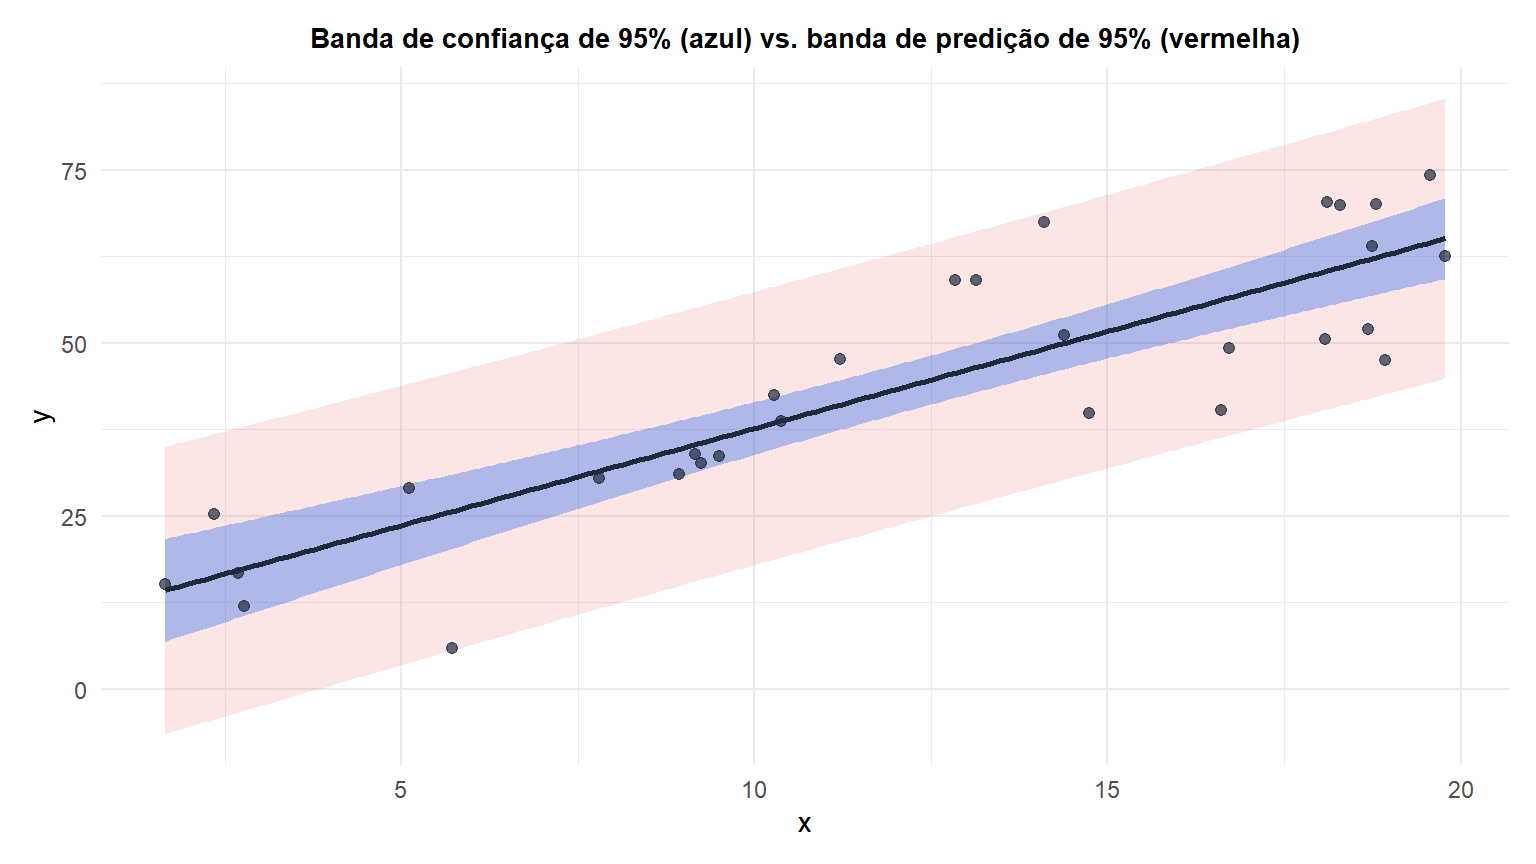
Em \(x = 10\), o valor ajustado é \(\hat{y} = 41{,}30\): o intervalo de confiança de 95% para a resposta média é \([38{,}33, 44{,}26]\), amplitude 5,93, enquanto o intervalo de predição de 95% para uma nova resposta individual é \([25{,}22, 57{,}38]\), amplitude 32,16, cerca de 5,4 vezes mais amplo. A banda azul, estreita, se ajusta de perto à reta ajustada em quase todos os pontos; a banda vermelha é ampla mesmo perto do centro dos dados, porque precisa cobrir onde um novo ponto pode cair, não apenas onde fica a reta média.
Por que confundi-los é um erro com consequências
Escolher o errado entre os dois não é um erro cosmético, muda o quanto de incerteza é reportado a quem está tomando uma decisão a partir disso.
⚠️ Um intervalo de confiança estreito pode criar uma falsa confiança sobre um caso futuro único
Reportar um intervalo de confiança quando uma decisão depende de uma única observação futura subestima sistematicamente a incerteza real. Uma previsão de demanda com um IC de 95% estreito em torno da média de vendas do próximo mês parece tranquilizadora, mas se a decisão real é “quanto estoque precisamos para não ficar sem produto no próximo mês”, o intervalo relevante é o de predição para esse único mês, que pode ser várias vezes mais amplo. Usar o IC nessa situação remove silenciosamente a maior parte do risco real do panorama.
Executando isso em R
Em uma regressão, os dois intervalos vêm da mesma chamada a predict(), apenas com um argumento interval diferente:
fit <- lm(y ~ x, data = df)

predict(fit, newdata = data.frame(x = 10), interval = "confidence", level = 0.95)
predict(fit, newdata = data.frame(x = 10), interval = "prediction", level = 0.95)
Para uma média amostral simples (sem regressão), o R base tem uma função de uma linha para o intervalo de confiança, mas não para o de predição, que precisa ser calculado diretamente pela fórmula:
t.test(x)$conf.int                 # 95% CI for the mean

n <- length(x)
tcrit <- qt(0.975, df = n - 1)
xbar  <- mean(x); s <- sd(x)
pi_lo <- xbar - tcrit * s * sqrt(1 + 1/n)   # 95% PI for a new observation
pi_hi <- xbar + tcrit * s * sqrt(1 + 1/n)
💡 A lição central conforme n cresce
Conforme o tamanho da amostra aumenta, o intervalo de confiança continua se estreitando em direção a uma amplitude zero, em princípio você pode determinar \(\mu\) com a precisão que quiser com dados suficientes. O intervalo de predição faz o contrário: ele se estreita apenas levemente e converge para um piso definido por \(S\), a própria variabilidade da população, que nenhuma quantidade de dados adicionais pode eliminar. Se a pergunta é sobre o parâmetro, mais dados é a resposta. Se a pergunta é sobre um caso futuro único, há um limite para o quanto mais de certeza você pode obter.

