Estimação pelo método dos momentos
O método dos momentos estima os parâmetros de uma distribuição igualando seus momentos teóricos, a média, a variância, e assim por diante, aos momentos observados na amostra, e então resolvendo para os parâmetros. Ele é mais antigo e mais simples do que a estimação de máxima verossimilhança: geralmente só precisa de álgebra, sem cálculo diferencial e sem otimização numérica.
A receita geral
Para uma distribuição com \(k\) parâmetros desconhecidos, igualam-se os primeiros \(k\) momentos teóricos aos momentos amostrais correspondentes, e resolve-se o sistema resultante de \(k\) equações para os \(k\) parâmetros:
\[E[X^j] = \frac{1}{n}\sum_{i=1}^n x_i^j, \qquad j = 1, \ldots, k\]
O lado esquerdo é uma fórmula conhecida em função dos parâmetros, já que vem da própria definição da distribuição. O lado direito é simplesmente um número, calculado diretamente a partir da amostra. Cada equação fixa mais um parâmetro, então uma distribuição com 2 parâmetros desconhecidos precisa dos dois primeiros momentos; uma com 1 parâmetro desconhecido precisa apenas da média.
Exemplo resolvido: ajustando uma distribuição Gama
A distribuição Gama tem dois parâmetros, então precisa dos dois primeiros momentos: a média e a variância.
Uma amostra simulada de \(n=200\) observações de uma distribuição Gama com forma real \(k=4\) e taxa real \(=0{,}5\) (média \(8\), variância \(16\)). Usando as próprias fórmulas dos momentos da Gama, \(E[X] = k\theta\) e \(\text{Var}(X) = k\theta^2\) (com escala \(\theta = 1/\text{taxa}\)), resolvendo para os dois parâmetros a partir da média amostral \(\bar{x}\) e da variância amostral \(s^2\), obtém-se:
\[\hat{k}_{MM} = \frac{\bar{x}^2}{s^2}, \qquad \hat{\theta}_{MM} = \frac{s^2}{\bar{x}}\]
Nessa amostra, \(\bar{x} = 7{,}691\) e \(s^2 = 14{,}162\), então:
| Parâmetro | Método dos momentos | Máxima verossimilhança | Valor real |
|---|---|---|---|
| Forma (\(k\)) | 4,176 | 4,010 | 4 |
| Taxa | 0,543 | 0,521 | 0,5 |
Ambos os métodos ficam próximos do valor real e próximos entre si; a estimativa do método dos momentos não é idêntica à de máxima verossimilhança, eles otimizam critérios diferentes, mas em uma amostra de tamanho razoável de uma distribuição bem comportada, costumam coincidir com poucos pontos percentuais de diferença.

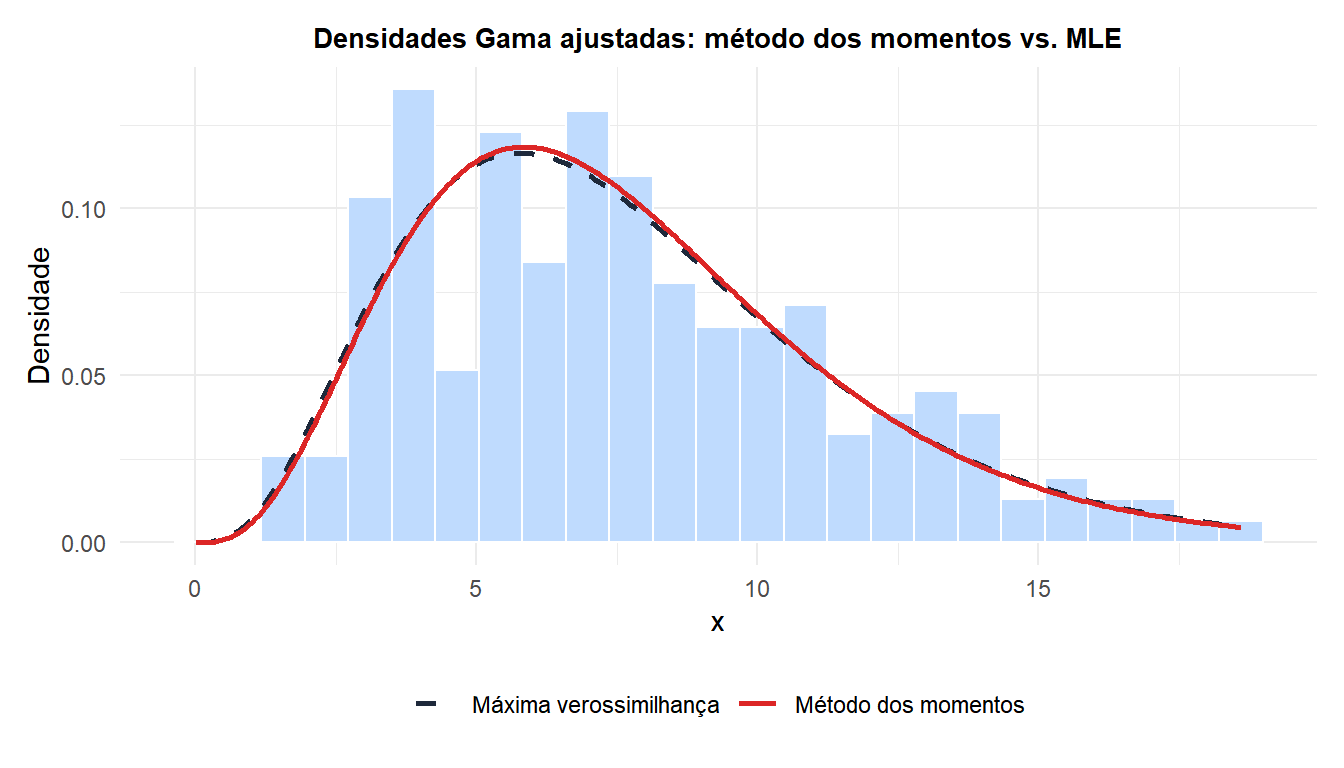
As duas curvas ajustadas quase se sobrepõem. Para uma amostra razoavelmente grande e bem especificada, escolher entre os dois métodos raramente muda a conclusão prática: a diferença aparece na eficiência (o quanto as estimativas oscilam de amostra para amostra), não em um ajuste visivelmente diferente para esse conjunto de dados específico.
Onde o método dos momentos falha
Igualar momentos amostrais e teóricos é simples, mas essa simplicidade tem custos reais.
⚠️ Estimadores pelo método dos momentos nem sempre são válidos, e raramente são tão eficientes quanto o MLE
Como o método dos momentos resolve qualquer álgebra que as equações de momentos produzam, ele pode ocasionalmente retornar uma estimativa sem sentido, por exemplo, um parâmetro de variância implícito negativo a partir de uma amostra pequena ou atípica, algo que um ajuste de MLE devidamente restringido normalmente evita. Ele também geralmente é menos eficiente do que o MLE: para a mesma amostra, o estimador pelo método dos momentos tipicamente tem uma variância amostral maior, o que significa que oscila mais de amostra para amostra. Na prática, estimativas pelo método dos momentos costumam ser usadas principalmente como bons valores iniciais para uma otimização iterativa de MLE, em vez de como a estimativa final reportada.
Executando isso em R
O método dos momentos não precisa de nada além de mean() e var(); a máxima verossimilhança precisa de um otimizador, geralmente escondido dentro de uma função de ajuste:
x <- rgamma(200, shape = 4, rate = 0.5)

# Method of moments, closed-form algebra
xbar <- mean(x)
s2   <- var(x)
k_hat_mom     <- xbar^2 / s2
theta_hat_mom <- s2 / xbar

# Maximum likelihood, via numerical optimization under the hood
library(MASS)
fit_mle <- fitdistr(x, "gamma")
fit_mle$estimate
💡 Por que o MLE se tornou o padrão de qualquer forma
Se o método dos momentos é mais simples, por que o MLE é o que vem embutido em glm(), fitdistr(), e em quase toda outra função de ajuste moderna? Porque a vantagem de eficiência do MLE, alcançar a menor variância amostral possível entre os estimadores consistentes conforme a amostra cresce, geralmente supera a conveniência da álgebra em forma fechada, agora que os computadores tornam a otimização numérica essencialmente gratuita. O método dos momentos ainda se justifica para estimativas rápidas de rascunho, para distribuições em que o MLE não tem forma fechada e precisa de um valor inicial razoável, e para ensinar a ideia central, igualar os próprios momentos dos dados, antes de introduzir a verossimilhança.

