Métricas de avaliação de regressão (MAE, MSE, RMSE, MAPE, WAPE)
Modelos de classificação são avaliados por uma matriz de confusão e pela curva ROC/AUC. Modelos de regressão e previsão, em que a previsão é um número em vez de uma classe, são avaliados pelo quão distante esse número costuma ficar. MAE, MSE, RMSE, MAPE e WAPE são as cinco métricas que respondem a isso, e elas nem sempre concordam sobre qual modelo é melhor.
MAE, MSE e RMSE
Essas três trabalham diretamente com os erros de previsão \(e_i = y_i - \hat{y}_i\), nas unidades originais de \(y\), ou em unidades ao quadrado para o MSE:
\[\text{MAE} = \frac{1}{n}\sum_{i=1}^n |e_i|, \qquad \text{MSE} = \frac{1}{n}\sum_{i=1}^n e_i^2, \qquad \text{RMSE} = \sqrt{\text{MSE}}\]
O MAE trata toda unidade de erro da mesma forma. O MSE eleva o erro ao quadrado primeiro, então um único erro grande contribui muito mais do que vários erros pequenos, o que torna o MSE (e o RMSE, sua raiz quadrada, de volta às unidades originais de \(y\)) muito mais sensível a outliers do que o MAE. O RMSE é o mais comumente reportado dos três, porque está nas mesmas unidades de \(y\) enquanto ainda penaliza fortemente erros grandes, um meio-termo útil.
MAPE e WAPE: métricas baseadas em porcentagem
MAE, MSE e RMSE são todos dependentes da escala: um RMSE de 50 é excelente para prever preços de imóveis e catastrófico para prever vendas diárias de café. O MAPE e o WAPE corrigem isso expressando o erro como uma porcentagem do valor real, o que os torna comparáveis entre séries ou conjuntos de dados em escalas completamente diferentes:
\[\text{MAPE} = \frac{100\%}{n}\sum_{i=1}^n \left|\frac{e_i}{y_i}\right|, \qquad \text{WAPE} = 100\% \cdot \frac{\sum_{i=1}^n |e_i|}{\sum_{i=1}^n |y_i|}\]
A diferença parece pequena, o MAPE calcula a média dos erros percentuais individuais, o WAPE soma os erros absolutos e os valores reais absolutos separadamente antes de dividir, mas isso tem uma grande consequência prática abordada abaixo.
Exemplo resolvido: uma previsão enviesada e ruidosa
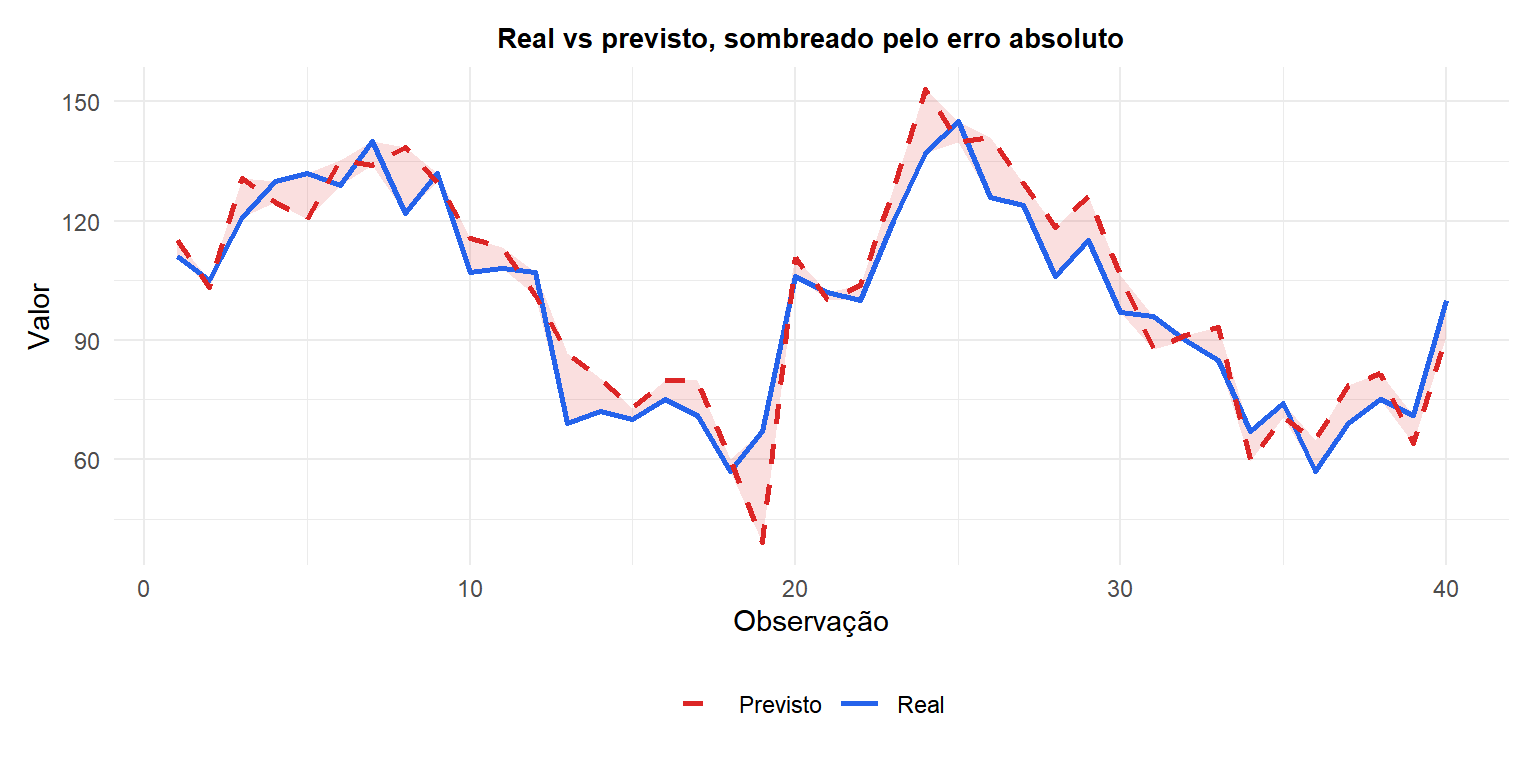
Calcular as cinco métricas sobre exatamente as mesmas previsões mostra como elas classificam os mesmos erros de forma diferente.
Uma série simulada de \(n=40\) valores reais (variando de 57 a 145) e uma previsão com um pequeno viés para cima (previsão média cerca de 2 unidades alta demais) mais ruído aleatório. As cinco métricas calculadas sobre os mesmos dados:
| Métrica | Valor |
|---|---|
| MAE | 7,95 |
| MSE | 89,64 |
| RMSE | 9,47 |
| MAPE | 8,64% |
| WAPE | 7,97% |
Aqui o MAPE e o WAPE concordam aproximadamente, ambos dizem que o erro típico é cerca de 8% do valor real, porque todo valor real nessa série está confortavelmente longe de zero (mínimo de 57).

Onde o MAPE falha e o WAPE não
O MAPE divide por cada valor real individual, então um valor-alvo de previsão que às vezes está próximo de zero faz o MAPE explodir, mesmo que o erro absoluto naquele ponto seja minúsculo.
⚠️ Um único valor real próximo de zero pode tornar o MAPE sem sentido
Tome um conjunto de 20 valores reais, a maioria entre 30 e 90, mas dois deles iguais a 1 e 0,5. A previsão erra nesses dois pontos por apenas algumas unidades em termos absolutos, o mesmo que em todos os outros pontos, dando \(\text{MAE} = 3{,}95\). Mas os erros percentuais nesses dois pontos, por si só, são de \(522{,}5\%\) e \(862{,}5\%\), que arrastam o \(\text{MAPE}\) geral para \(76{,}0\%\), um número que sugere um modelo seriamente quebrado, mesmo que as previsões sejam, em termos absolutos, perfeitamente comuns. O \(\text{WAPE}\) nos mesmos dados exatos permanece em \(7{,}6\%\), porque ele soma todos os erros absolutos e todos os valores reais absolutos primeiro, então um par de denominadores minúsculos não consegue mais dominar o resultado.
É por isso que o WAPE (também chamado de MAPE ponderado) é a escolha padrão em previsão de demanda e varejo, em que produtos ou dias individuais com vendas reais próximas de zero são rotineiros, não um caso extremo. O MAPE continua útil quando todo valor real está seguramente longe de zero e uma porcentagem ainda é mais interpretável do que unidades brutas.
Executando em R
Nenhuma dessas tem uma única função universal no R base; cada uma é uma fórmula de uma linha:
mae  <- mean(abs(actual - pred))
mse  <- mean((actual - pred)^2)
rmse <- sqrt(mse)
mape <- mean(abs((actual - pred) / actual)) * 100
wape <- sum(abs(actual - pred)) / sum(abs(actual)) * 100

# Packages that bundle all of them, with consistent naming
library(Metrics)
mae(actual, pred); rmse(actual, pred)

library(yardstick)
# yardstick works on a data frame of truth/estimate columns
💡 O R quadrado é um tipo de métrica completamente diferente
O R quadrado mede a proporção de variância explicada, um número relativo e sem unidades, enquanto MAE, RMSE, MAPE e WAPE medem diretamente o tamanho típico do erro. Um modelo pode ter um R quadrado alto e um RMSE grande ao mesmo tempo se a própria resposta tiver uma variância enorme; os dois tipos de métrica respondem a perguntas diferentes e geralmente são reportados juntos, não como substitutos um do outro.

