R quadrado e R quadrado ajustado explicados
O R quadrado é a proporção de variância da resposta que um modelo de regressão explica. É um dos primeiros números que qualquer pessoa observa após ajustar um modelo, e um dos mais mal interpretados: ele sempre sobe ao adicionar um preditor, mesmo um inútil, que é exatamente o que o R quadrado ajustado foi criado para corrigir. Este post se baseia na regressão linear simples.
O que o R quadrado mede
O \(R^2\) compara o erro que resta após o modelo com a variância total que o modelo tinha disponível para explicar:
\[R^2 = 1 - \frac{SS_{res}}{SS_{tot}} = 1 - \frac{\sum_{i=1}^n (y_i-\hat y_i)^2}{\sum_{i=1}^n (y_i-\bar y)^2}\]
\(SS_{res}\) é a soma dos quadrados dos resíduos que resta depois do modelo, \(SS_{tot}\) é a soma total dos desvios ao quadrado em relação à média, a variância que o modelo tinha disponível para explicar desde o início. O \(R^2\) compara os dois: é a fração dessa variância total que o modelo consegue explicar.
Em um ajuste dentro da amostra, o \(R^2\) fica entre 0 (o modelo não explica nada além da média) e 1 (o modelo reproduz exatamente cada valor observado). Pode se tornar negativo em dados novos aos quais o modelo não foi ajustado, se o modelo chegar a prever pior do que simplesmente usar a média de treinamento todas as vezes.
Por que o R quadrado sempre sobe ao adicionar um preditor
Os mínimos quadrados ordinários escolhem coeficientes para minimizar \(SS_{res}\). Adicionar qualquer preditor, mesmo um que seja puro ruído aleatório sem nenhuma relação com a resposta, dá aos mínimos quadrados mais um coeficiente que ele pode fixar no valor que melhor ajustar os dados de treinamento. O pior que os mínimos quadrados podem fazer com um novo preditor é fixar seu coeficiente exatamente em zero, reproduzindo o ajuste anterior. Na prática, com uma amostra finita, quase sempre haverá algum coeficiente diferente de zero que ajuste marginalmente melhor por puro acaso. \(SS_{res}\) só pode permanecer igual ou diminuir, então o \(R^2\) só pode permanecer igual ou subir; ele nunca pode cair ao se adicionar um preditor aos mesmos dados.
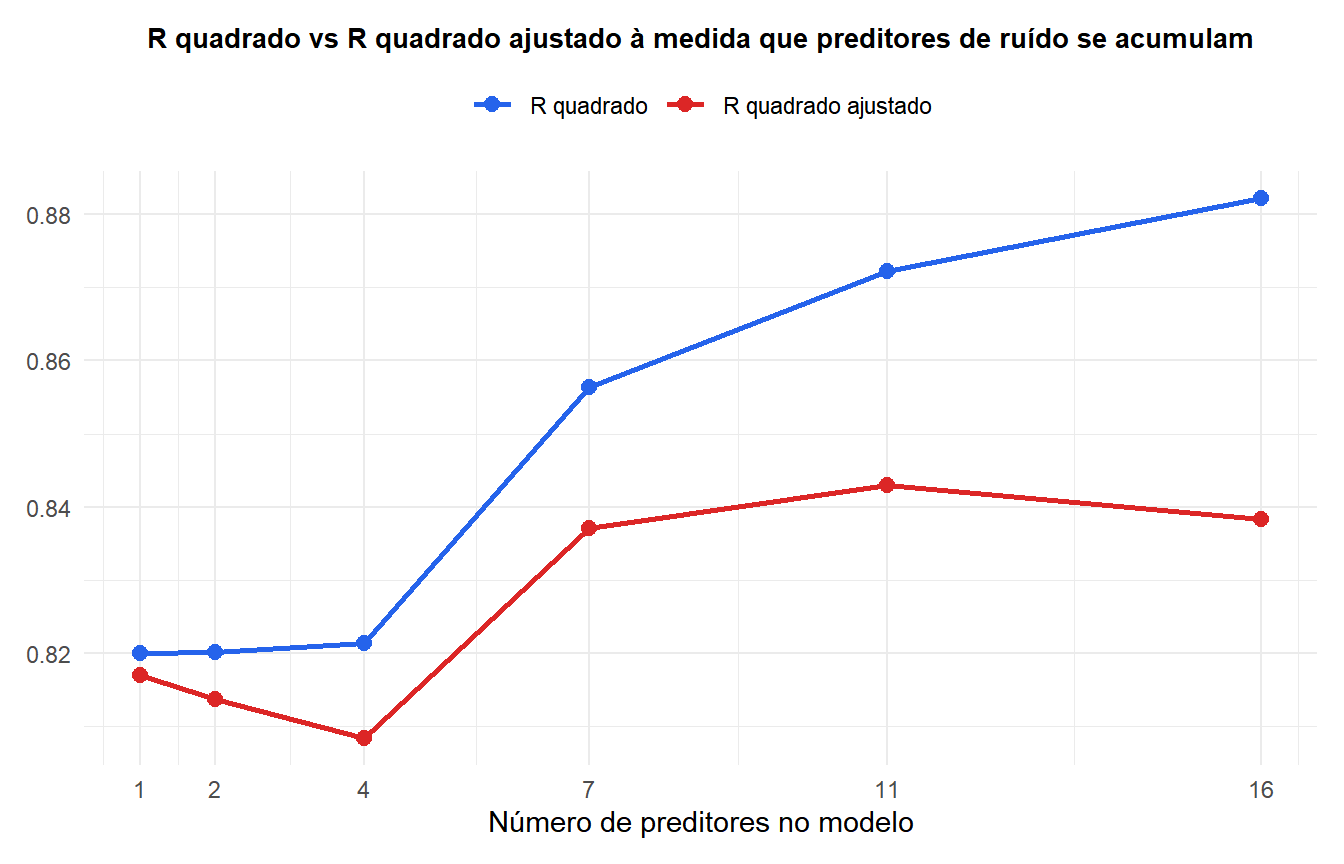
Um conjunto de dados de \(n=60\) estudantes tem uma relação real entre horas estudadas e nota da prova, mais ruído natural: score = 40 + 5*hours_studied + noise. Partindo desse único preditor genuíno, preditores de ruído aleatório, colunas de números sem nenhuma relação com a nota, são adicionados um após o outro:
| Preditores no modelo | \(R^2\) | \(R^2\) ajustado |
|---|---|---|
| 1 (apenas horas estudadas) | 0,820 | 0,817 |
| 2 (+1 coluna de ruído) | 0,820 | 0,814 |
| 4 (+3 colunas de ruído) | 0,821 | 0,808 |
| 7 (+6 colunas de ruído) | 0,856 | 0,837 |
| 11 (+10 colunas de ruído) | 0,872 | 0,843 |
| 16 (+15 colunas de ruído) | 0,882 | 0,838 |
O \(R^2\) nunca cai na tabela, exatamente como a mecânica acima prevê, mesmo que 15 dos 16 preditores finais sejam ruído sem nenhuma conexão real com a nota. O \(R^2\) ajustado conta uma história diferente nas três primeiras linhas: cai de 0,817 para 0,808 ao adicionar as primeiras colunas de ruído, sinalizando corretamente que esses preditores não estão contribuindo. Mas ele não é uma catraca de via única como o \(R^2\) puro: com 15 colunas de ruído candidatas e apenas 60 observações, algumas delas se alinham com os dados bem o suficiente por pura sorte para que o \(R^2\) ajustado se recupere e até supere seu valor inicial mais adiante na tabela. Isso em si é um alerta útil: quanto mais preditores candidatos você jogar em uma amostra modesta, maior a chance de que algum deles se ajuste apenas por coincidência.

A fórmula do R quadrado ajustado
O R quadrado ajustado usa a mesma fórmula e multiplica o termo de erro por um fator que cresce com o número de preditores:
\[R^2_{adj} = 1 - (1 - R^2)\frac{n-1}{n-p-1}\]
em que \(n\) é o tamanho da amostra e \(p\) é o número de preditores. O fator \(\frac{n-1}{n-p-1}\) é sempre pelo menos 1 quando \(p \geq 1\), o que significa que o R quadrado ajustado é sempre menor ou igual ao R quadrado puro: ele só pode puxar o número para baixo, nunca para cima, em relação à versão não ajustada. Quanto mais preditores em relação ao tamanho da amostra, maior essa penalidade. Conforme \(p\) se aproxima de \(n-1\), a penalidade cresce sem limite, exatamente por isso o R quadrado ajustado pode oscilar muito mais do que o R quadrado puro na tabela acima, uma vez que o modelo tem muitos preditores em relação às suas 60 observações.
⚠️ Um R quadrado alto não significa que um modelo é bom
O \(R^2\) só mede quanta variância dentro da amostra é explicada; ele não diz nada sobre se o modelo tem a forma funcional correta, se seus coeficientes são confiáveis, ou se ele preverá bem com dados novos. Um modelo pode atingir um \(R^2\) alto estando mal especificado, e um modelo pode ter um \(R^2\) modesto e ainda ser o melhor ajuste possível a dados que simplesmente são ruidosos por natureza; um \(R^2\) de 0,3 em um campo como as ciências sociais, em que os resultados são influenciados por inúmeros fatores não medidos, pode ser um resultado genuinamente forte. Consulte os diagnósticos de regressão para avaliar de fato se um modelo é adequado, em vez de ler o \(R^2\) isoladamente como um veredito.
Executando em R
Ambos os números saem diretamente de summary(), e as fórmulas manuais confirmam exatamente de onde vêm:
fit <- lm(score ~ hours_studied, data = df)
summary(fit)$r.squared
summary(fit)$adj.r.squared

# Manual formula check
ss_res <- sum(residuals(fit)^2)
ss_tot <- sum((df$score - mean(df$score))^2)
r2 <- 1 - ss_res / ss_tot

n <- nrow(df)
p <- 1
adj_r2 <- 1 - (1 - r2) * (n - 1) / (n - p - 1)
💡 R quadrado e R quadrado ajustado, regras práticas
Use o \(R^2\) puro para descrever quanta variância um modelo fixo, já escolhido, explica. Use o R quadrado ajustado em vez do R quadrado puro sempre que comparar modelos com diferentes números de preditores, já que o R quadrado puro favorece mecanicamente o modelo maior mesmo quando os preditores extras não agregam nada real. Nenhum dos dois números indica que o modelo tem a forma funcional correta; veja regressão vs correlação para uma distinção relacionada e frequentemente confundida: a correlação mede a associação entre duas variáveis, o \(R^2\) mede o quão bem um modelo de regressão completo se ajusta.

