Cointegração e VECM
Duas séries individualmente não estacionárias ainda podem se mover juntas de forma estável e previsível ao longo do tempo, compartilhando o que se chama de uma tendência estocástica comum. Quando isso acontece, elas são cointegradas, e modelá-las separadamente, ou ajustar um VAR simples sobre seus níveis brutos, descarta informação real sobre essa relação de longo prazo, ou, piso ainda, produz uma regressão espúria. Este post aborda como testar a cointegração e como modelá-la corretamente com um Modelo Vetorial de Correção de Erros (VECM).
Antes que qualquer coisa disso se aplique, ambas as séries devem primeiro ter demonstrado individualmente que têm uma raiz unitária; veja o teste de Dickey-Fuller e o post geral sobre estacionariedade para essa primeira etapa.
O que significa cointegração
Se \(x_t\) e \(y_t\) são ambas \(I(1)\) (integradas de ordem 1: não estacionárias, mas estacionárias após uma diferenciação), elas são cointegradas se alguma combinação linear delas for, em si, estacionária, \(I(0)\). Intuitivamente: ambas as séries podem vagar sem limite por conta própria, como dois passeios aleatórios separados, mas uma combinação linear específica delas permanece ancorada e nunca se afasta muito de zero, porque compartilham a mesma tendência estocástica subjacente.
\[x_t, y_t \sim I(1), \qquad y_t - \beta x_t \sim I(0)\]
\(\beta\) é o coeficiente de cointegração, e \(y_t - \beta x_t\) (ou, de forma mais geral, incluindo uma constante, \(y_t - \beta x_t - \alpha\)) é a relação de cointegração, interpretável como o equilíbrio de longo prazo ao qual as duas séries estão ancoradas. Exemplos clássicos do mundo real: preços spot e futuros da mesma commodity, consumo e renda, taxas de câmbio vinculadas pela paridade do poder de compra.
O método de dois passos de Engle-Granger
A forma mais simples de testar e estimar a cointegração entre exatamente duas séries.
Passo 1: regrida \(y_t\) sobre \(x_t\) por MQO e guarde os resíduos:
\[\hat u_t = y_t - \hat\alpha - \hat\beta x_t\]
Passo 2: teste se os resíduos \(\hat u_t\) são estacionários usando um teste do tipo ADF. Se forem, \(x_t\) e \(y_t\) são cointegradas, a relação de MQO É a relação de cointegração. Se os resíduos ainda têm uma raiz unitária, não há evidência de cointegração.
⚠️ O passo 2 de Engle-Granger precisa de seus próprios valores críticos, não da tabela ADF padrão
Os resíduos \(\hat u_t\) vêm de uma regressão ESTIMADA, o MQO já escolheu \(\hat\alpha, \hat\beta\) para ajustar os dados o melhor possível, então testá-los para uma raiz unitária com os valores críticos comuns de Dickey-Fuller é muito permissivo: ele vai encontrar “estacionariedade” (rejeitar a raiz unitária) com mais frequência do que deveria, puramente devido a esse efeito de estimação. Engle e Granger derivaram valores críticos separados e mais estritos (refinados depois por MacKinnon) especificamente para testar resíduos de uma regressão de cointegração. Funções construídas para esse propósito, como tseries::po.test(), aplicam os valores críticos corretos automaticamente. Um adf.test() genérico sobre os resíduos tecnicamente usa a distribuição de referência errada, embora uma estatística de teste fortemente negativa, como no exemplo resolvido abaixo, geralmente ainda supere mesmo o limiar mais estrito.
Exemplo resolvido: duas séries compartilhando uma tendência comum
Simular duas séries construídas a partir do mesmo passeio aleatório subjacente permite verificar, passo a passo, que o procedimento de Engle-Granger recupera corretamente a cointegração que foi deliberadamente embutida.
Simule duas séries que compartilham uma única tendência comum de passeio aleatório, então elas são cointegradas por construção:
set.seed(5)
T <- 150
common_trend <- cumsum(rnorm(T))
x <- common_trend + rnorm(T, 0, 1)
y <- 2*common_trend + 5 + rnorm(T, 0, 1)
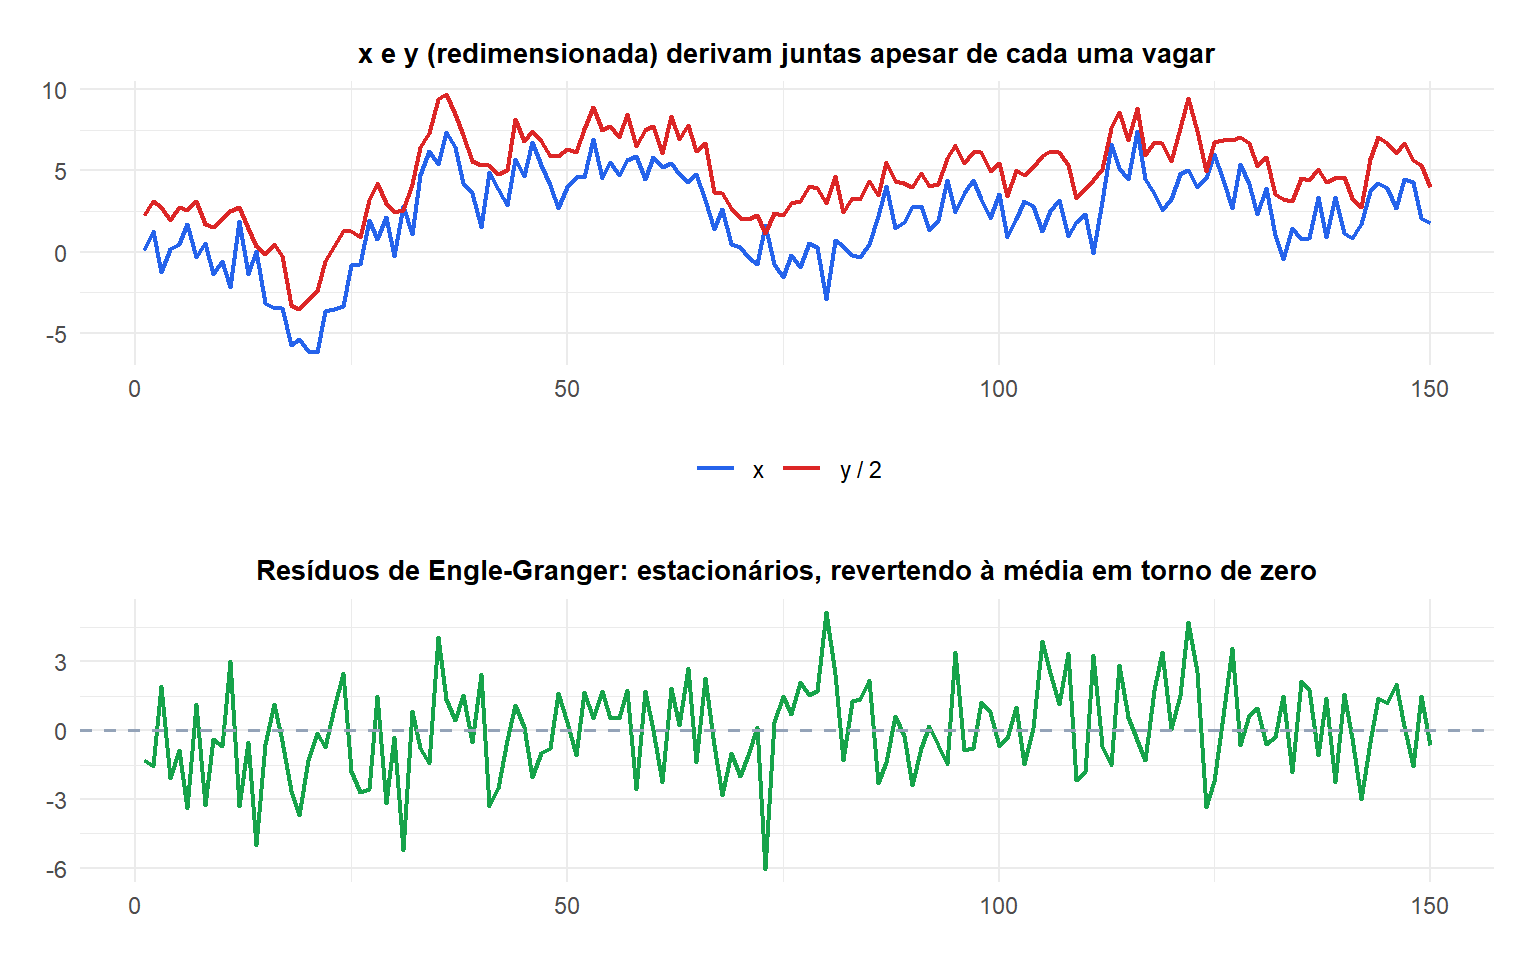
Individualmente, ambas as séries são não estacionárias. Teste ADF em \(x\): estatística de teste \(-2{,}45\), \(p = 0{,}389\), não rejeita a raiz unitária. Teste ADF em \(y\): estatística de teste \(-2{,}26\), \(p = 0{,}467\), não rejeita a raiz unitária. Nenhuma das séries é estacionária isoladamente.
Passo 1 de Engle-Granger: regressão MQO de \(y\) sobre \(x\):
\[\hat y_t = 5{,}659 + 1{,}679\, x_t\]
Ambos os coeficientes são altamente significativos (\(p < 0{,}001\)), \(R^2 = 0{,}845\).
Passo 2 de Engle-Granger: teste ADF nos resíduos da regressão \(\hat u_t\), usando a especificação sem constante, 1 defasagem (urca::ur.df(resid, type = "none", lags = 1)): estatística de teste \(= -8{,}286\). Isso é muito mais negativo até do que o valor crítico estrito de 1% para essa especificação (\(-2{,}58\)), então a raiz unitária nos resíduos é decisivamente rejeitada.
Conclusão: \(x\) e \(y\) são cointegradas, exatamente como embutido na simulação, já que ambas as séries compartilham a única tendência comum.

O teste de Johansen: uma segunda verificação independente
O método de Engle-Granger só lida com exatamente 2 séries e trata uma delas como “dependente” de forma arbitrária. O teste de Johansen é mais geral: funciona para qualquer número de séries simultaneamente e não exige escolher uma variável dependente, baseando-se nos autovalores de uma matriz derivada de um VAR em níveis. Ele testa, em sequência, quantas relações de cointegração existem (o posto de cointegração \(r\)): \(H_0: r = 0\) (sem cointegração) vs \(r \geq 1\), depois \(H_0: r \leq 1\) vs \(r \geq 2\), e assim por diante.
Teste do traço de Johansen (urca::ca.jo(cbind(x, y), type = "trace", ecdet = "const", K = 2)) sobre os mesmos \(x, y\) simulados:
| Hipótese | Estatística de teste | Valor crítico de 5% | Conclusão |
|---|---|---|---|
| \(r = 0\) | 72,92 | 19,96 | Rejeita: pelo menos 1 relação de cointegração |
| \(r \leq 1\) | 5,92 | 7,52 | Não rejeita: no máximo 1 |
Lendo a tabela de cima para baixo, pare na primeira linha em que \(H_0\) NÃO é rejeitada, aqui isso é \(r \leq 1\), então o posto de cointegração é \(r = 1\): exatamente uma relação de cointegração, concordando com o resultado de Engle-Granger acima e com o verdadeiro desenho da simulação, duas séries compartilhando uma única tendência comum.
O Modelo Vetorial de Correção de Erros (VECM)
Uma vez estabelecida a cointegração, o modelo correto é um VECM, em vez de um VAR em níveis ou um VAR em diferenças, ambos descartam informação: um ignora as raízes unitárias, o outro ignora a relação de longo prazo. Um VECM combina dinâmicas de curto prazo, em diferenças, com um termo de correção de erro que traz o sistema de volta em direção ao equilíbrio de longo prazo sempre que ele se afasta.
\[\Delta \mathbf{y}_t = \boldsymbol{\alpha}(\boldsymbol{\beta}' \mathbf{y}_{t-1} - \mu) + \boldsymbol{\Gamma}_1 \Delta \mathbf{y}_{t-1} + \boldsymbol{\varepsilon}_t\]
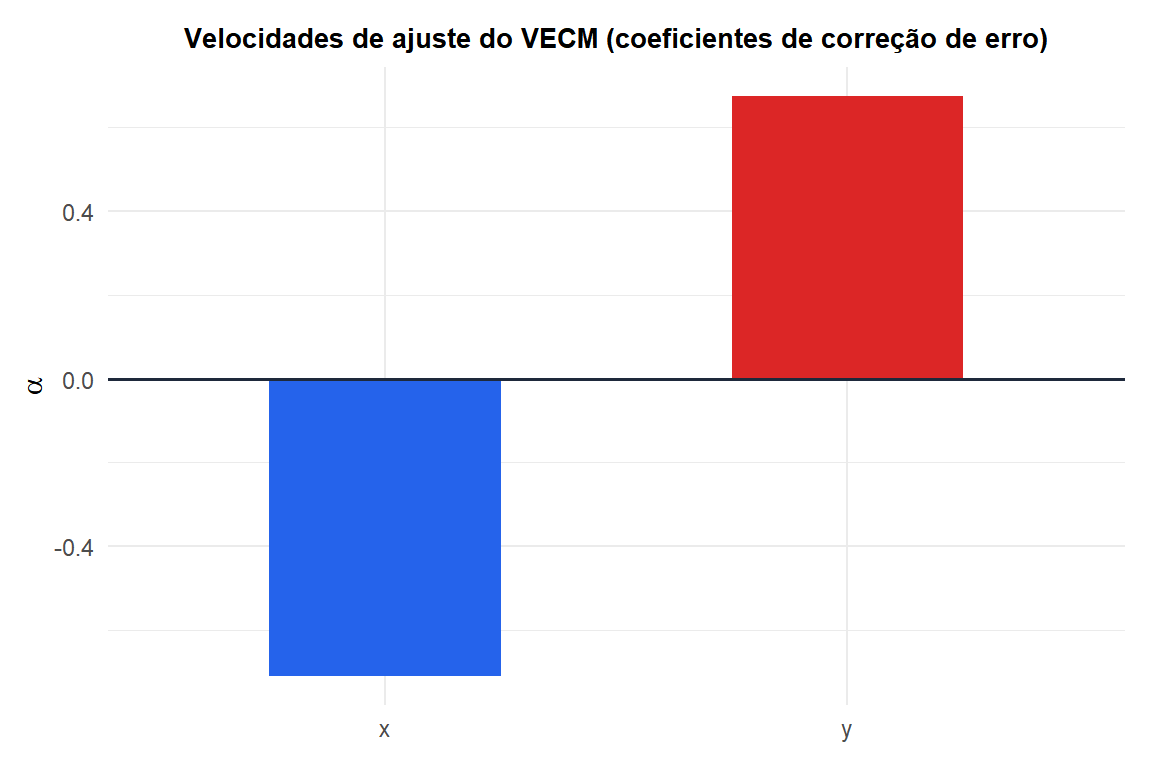
em que \(\boldsymbol{\beta}' \mathbf{y}_{t-1}\) é a relação de cointegração (o quanto o sistema se afastou do equilíbrio no período anterior) e \(\boldsymbol{\alpha}\) é o vetor de velocidades de ajuste, o quão fortemente cada variável corrige de volta em direção ao equilíbrio após um desvio.
Ajustando o VECM via vars::cajorls() sobre os mesmos dados, no posto \(r = 1\), obtêm-se velocidades de ajuste estimadas \(\alpha_x = -0{,}709\) e \(\alpha_y = +0{,}675\). Interpretação concreta: sempre que a relação de cointegração está acima de seu valor de equilíbrio de longo prazo, um desvio positivo, \(x\) se move PARA BAIXO (coeficiente negativo) e \(y\) se move PARA CIMA (coeficiente positivo) no período seguinte, ambas as ações empurrando o sistema de volta em direção ao equilíbrio, exatamente a correção de erro que dá nome ao modelo.
⚠️ Ajustar um VAR em níveis sobre séries cointegradas não é apenas subótimo, os resultados podem ser espúrios
Se duas séries não estacionárias são cointegradas e você ajusta um VAR simples sobre seus níveis brutos, ignorando completamente as raízes unitárias, o modelo está mal especificado: erros padrão, testes de significância, e respostas a impulso desse VAR não são confiáveis. Diferenciar ambas as séries para forçar a estacionariedade e ajustar um VAR sobre as diferenças também está errado, de uma forma diferente, isso descarta completamente a relação de cointegração de longo prazo, desperdiçando informação real. Um VECM é a especificação que usa corretamente ambas as peças: dinâmicas de curto prazo dos dados diferenciados, mais o equilíbrio de longo prazo da relação em níveis.
Executando em R
As mesmas três verificações usadas acima, o teste de resíduos de Engle-Granger, o procedimento de Johansen, e o ajuste do próprio VECM, cada uma corresponde a uma única chamada em R:
library(urca)

# Engle-Granger two-step (manual)
fit_ols <- lm(y ~ x)
resid_eg <- residuals(fit_ols)
ur.df(resid_eg, type = "none", lags = 1)   # test residuals for a unit root

# Or the built-in Engle-Granger test with correct critical values
library(tseries)
po.test(cbind(y, x))

# Johansen test
jo_test <- ca.jo(cbind(x, y), type = "trace", ecdet = "const", K = 2)
summary(jo_test)

# Fit the VECM at the chosen rank
library(vars)
vecm_fit <- cajorls(jo_test, r = 1)
summary(vecm_fit$rlm)

# Convert to a VAR in levels for forecasting, if needed
var_form <- vec2var(jo_test, r = 1)
predict(var_form, n.ahead = 12)
💡 O fluxo de trabalho de cointegração, passo a passo
- Teste cada série individualmente para uma raiz unitária (teste de Dickey-Fuller), confirme que ambas são \(I(1)\).
- Teste a cointegração: Engle-Granger para 2 séries, Johansen para 2 ou mais.
- Se cointegradas, ajuste um VECM no posto de cointegração encontrado.
- Se NÃO cointegradas, diferencie ambas as séries e ajuste um VAR simples sobre as diferenças, ou reconsidere se as duas séries devem ser modeladas juntas.
Pular direto para um VAR em níveis sem verificar nada disso é o erro mais comum no trabalho aplicado de séries temporais multivariadas.

