Lei dos grandes números
A Lei dos Grandes Números (LGN) é a garantia formal por trás de uma intuição que todo mundo já tem: jogue uma moeda algumas vezes e você pode obter uma sequência incomum; jogue um milhão de vezes e a proporção de caras estará extremamente próxima de 50%. É o parente mais próximo do Teorema Central do Limite neste site, mas responde a uma pergunta diferente; este post deixa essa distinção precisa.
A lei fraca dos grandes números
Para variáveis aleatórias independentes e identicamente distribuídas \(X_1, X_2, \ldots\) com média finita \(\mu\), a média amostral \(\bar{X}_n\) converge em probabilidade para \(\mu\):
\[\bar{X}_n \xrightarrow{P} \mu \quad \text{quando } n \to \infty\]
Formalmente, para qualquer \(\varepsilon > 0\): \(P(|\bar{X}_n - \mu| > \varepsilon) \to 0\) quando \(n \to \infty\). Em termos simples: por menor que seja a margem \(\varepsilon\) que você escolha, a probabilidade de a média amostral se desviar da média real por mais do que essa margem diminui em direção a zero à medida que a amostra cresce.
Lei fraca vs. lei forte
A lei fraca acima diz que a probabilidade de um desvio grande desaparece à medida que \(n\) cresce, mas em princípio ela ainda permite que a sequência \(\bar{X}_n\) se afaste ocasionalmente de \(\mu\) infinitas vezes, só que com probabilidade cada vez menor em cada \(n\) fixo.
A lei forte é uma garantia mais rigorosa:
\[\bar{X}_n \to \mu \quad \text{quase certamente}\]
Ou seja, com probabilidade 1, a sequência real de médias amostrais converge para \(\mu\) e, a partir de certo ponto, permanece arbitrariamente próxima para sempre, não apenas “provavelmente próxima em cada \(n\)”. Para praticamente qualquer propósito prático neste site, essa distinção não muda como você usaria o resultado, mas é uma distinção matemática real e famosa que vale a pena saber que existe.
Exemplo resolvido: a média móvel de lançamentos de um dado
Um único dado é o caso mais limpo possível: a média real é conhecida exatamente, então qualquer oscilação ou convergência na média móvel é fácil de ver.
Jogue repetidamente um único dado honesto de seis lados. A média real é \(\mu = 3{,}5\). Acompanhe a média móvel à medida que o número de lançamentos cresce:
set.seed(7)
for (n in c(10, 100, 1000, 10000, 100000)) {
  rolls <- sample(1:6, n, replace = TRUE)
  # mean(rolls), abs(mean(rolls) - 3.5)
}| Número de lançamentos \(n\) | Média amostral \(\bar{X}_n\) | \(\lvert \bar{X}_n - 3{,}5 \rvert\) |
|---|---|---|
| 10 | 3,30 | 0,20 |
| 100 | 3,43 | 0,07 |
| 1.000 | 3,538 | 0,038 |
| 10.000 | 3,5049 | 0,0049 |
| 100.000 | 3,4979 | 0,0021 |
A diferença diminui no geral, mas não de forma suave em cada etapa: o desvio em \(n=1.000\) (0,038) ainda é menor do que em \(n=100\) (0,07), mas, em geral, esse tipo de comparação pode ir em qualquer direção em etapas intermediárias. A LGN nunca promete que cada lançamento adicional torna a média estritamente mais próxima de \(\mu\), apenas que a probabilidade de estar longe de \(\mu\) diminui de forma confiável à medida que \(n\) cresce sem limite. É exatamente isso que significa “convergir em probabilidade”: uma garantia sobre o longo prazo, não uma promessa de melhora suave, passo a passo.

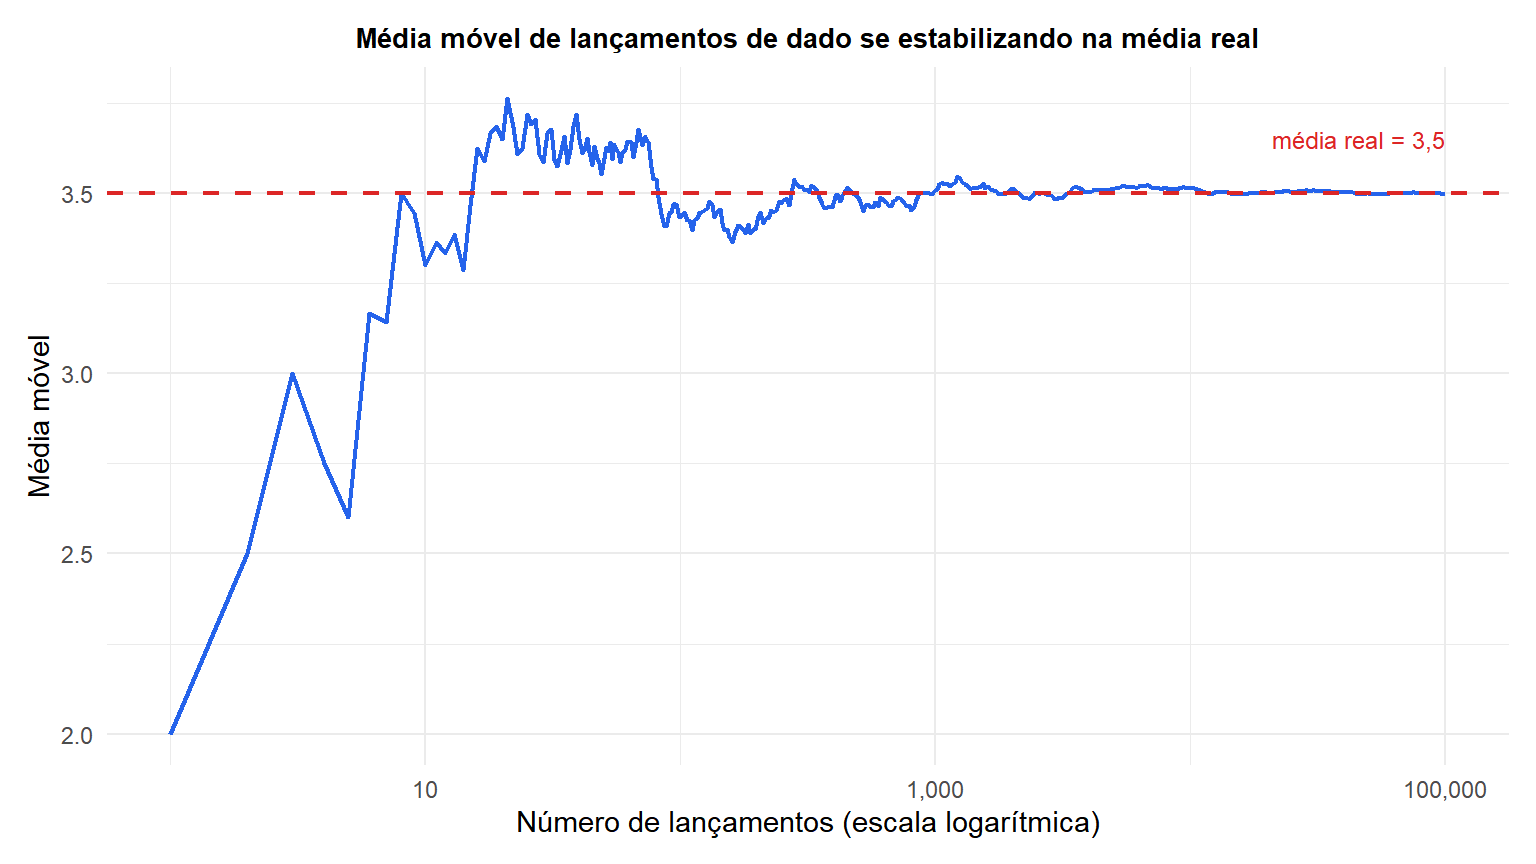
No início, com apenas algumas poucas jogadas, a média móvel oscila muito. À medida que o número de lançamentos cresce para os milhares e além, as oscilações diminuem e a linha se estabiliza bem perto da média real de 3,5.
Lei dos Grandes Números vs. Teorema Central do Limite: a diferença fundamental
Ambos descrevem o comportamento de \(\bar{X}_n\) à medida que \(n\) cresce, mas respondem a perguntas diferentes.
- A LGN diz ONDE \(\bar{X}_n\) termina: ela converge para o único ponto \(\mu\), colapsando para uma massa pontual no limite.
- O TCL diz COMO \(\bar{X}_n\) flutua EM TORNO de \(\mu\) para um \(n\) grande, mas finito: aproximadamente distribuída normalmente, com a dispersão diminuindo como \(\sigma/\sqrt{n}\).
Dito de forma direta: a LGN é uma afirmação sobre a convergência para um ponto; o TCL é um refinamento que descreve a forma e o ritmo dessa convergência. Se você reescalar \(\bar{X}_n - \mu\) por \(\sqrt{n}\), o “colapso para um ponto” da LGN se torna exatamente a distribuição normal do TCL: são duas visões da mesma convergência subjacente em escalas de zoom diferentes.
⚠️ A Lei dos Grandes Números não explica, nem justifica, a falácia do jogador
Um uso indevido muito comum: acreditar que, depois de uma longa sequência de um resultado (digamos, cara), a LGN de alguma forma torna o outro resultado (coroa) “devido” para equilibrar as coisas e acelerar o retorno da média para 0,5. Isso é falso. Cada lançamento continua completamente independente do passado; a moeda não tem memória.
O que realmente acontece não é que os desvios passados sejam corrigidos, mas que eles sejam diluídos numericamente: uma sequência de 10 caras extras nos primeiros 20 lançamentos quase não move a média depois de um milhão de lançamentos, não porque o universo equilibre nada, mas simplesmente porque \(10/1.000.000\) é um número minúsculo. A LGN funciona por diluição, graças a um tamanho de amostra crescente, nunca por compensação.
Requisitos para que a Lei dos Grandes Números valha
As observações precisam ter média finita. Para distribuições com média indefinida ou infinita, a média amostral não converge para nada à medida que \(n\) cresce; ela continua saltando de forma imprevisível, não importa quão grande a amostra fique. Essa é uma exceção genuína, embora pouco comum, que vale a pena saber que existe; a maioria das grandezas do mundo real, com média finita, está seguramente coberta pela LGN.
Executando a simulação em R
A simulação de lançamentos de dado acima vem do acompanhamento de uma única média acumulada enquanto o tamanho da amostra sobe até as dezenas de milhares:
set.seed(7)
n_max <- 100000
rolls <- sample(1:6, n_max, replace = TRUE)
running_mean <- cumsum(rolls) / seq_along(rolls)

# Valor em alguns pontos de controle
running_mean[c(10, 100, 1000, 10000, 100000)]
💡 A LGN na prática: por que seguros, cassinos e testes A/B dependem dela
A LGN é a razão matemática pela qual as seguradoras conseguem prever de forma lucrativa os pagamentos agregados, apesar da incerteza total sobre qualquer segurado individual; pela qual a margem de lucro esperada a longo prazo de um cassino é confiável, mesmo que cada aposta individual seja como jogar uma moeda; e pela qual os testes A/B e as pesquisas de opinião precisam de uma amostra grande o suficiente antes que suas médias observadas possam ser consideradas próximas da taxa real subjacente. Em todos os casos, a garantia é sobre a média ao longo de muitas repetições, nunca sobre qualquer resultado individual.

