Esperança e variância de uma variável aleatória
A esperança \(E[X]\) resume o centro da distribuição de uma variável aleatória: sua média de longo prazo ao longo de infinitas repetições. A variância \(\text{Var}(X)\) resume sua dispersão em torno desse centro. Ambas são construídas diretamente sobre a função de massa de probabilidade e a função de densidade de probabilidade já vistas nesta seção.
A esperança
A esperança é uma média ponderada pela probabilidade de cada resultado possível, definida de forma diferente dependendo de \(X\) ser discreta ou contínua:
\[E[X] = \sum_x x \cdot p(x) \quad \text{(discreta)} \qquad\qquad E[X] = \int_{-\infty}^{\infty} x \, f(x) \, dx \quad \text{(contínua)}\]
Nos dois casos a ideia é a mesma: multiplicar cada valor possível pela sua probabilidade, e somar (ou integrar) tudo. \(E[X]\) também é chamada de média da variável aleatória, e costuma ser escrita como \(\mu\).
A variância
A variância mede o quão longe os valores de \(X\) costumam ficar de \(E[X]\), usando distâncias ao quadrado para que os desvios acima e abaixo da média não se cancelem:
\[\text{Var}(X) = E\big[(X - E[X])^2\big]\]
Expandindo o quadrado obtemos o atalho de cálculo padrão, usado na prática muito mais do que a própria definição:
\[\text{Var}(X) = E[(X-E[X])^2] = E[X^2] - 2E[X]E[X] + (E[X])^2 = E[X^2] - (E[X])^2\]
O desvio padrão \(SD(X) = \sqrt{\text{Var}(X)}\) devolve a dispersão às unidades originais de \(X\), já que a variância está em unidades ao quadrado.
Propriedades fundamentais
Um punhado de regras algébricas facilita trabalhar com a esperança e a variância sem precisar recalcular uma soma ou integral toda vez:
- Linearidade da esperança: \(E[aX + b] = a E[X] + b\). Isso vale sempre, para qualquer \(X\), mesmo quando \(X\) é construída a partir de outras variáveis aleatórias dependentes, o que a torna tão útil.
- Variância sob uma transformação linear: \(\text{Var}(aX + b) = a^2 \text{Var}(X)\). A constante \(b\) desloca os dados, mas não muda sua dispersão, então ela desaparece completamente; o fator de escala \(a\) fica elevado ao quadrado porque a própria variância está em unidades ao quadrado.
- Somas de variáveis independentes: se \(X\) e \(Y\) são independentes, \(E[X+Y] = E[X] + E[Y]\) e \(\text{Var}(X+Y) = \text{Var}(X) + \text{Var}(Y)\). A aditividade da esperança não precisa de nenhuma suposição de independência; a da variância precisa, a dependência entre \(X\) e \(Y\) introduz um termo de covariância que essa soma simples ignora.
Exemplo resolvido: pagamentos em um jogo simples
Aplicar as duas fórmulas a uma variável aleatória discreta concreta mostra exatamente como o atalho e a definição original coincidem.
Um jogo tem quatro pagamentos possíveis \(x\), cada um com uma probabilidade \(p(x)\) dada:
| \(x\) | \(p(x)\) | \(x \cdot p(x)\) | \((x - 4)^2 \cdot p(x)\) |
|---|---|---|---|
| -5 | 0,50 | -2,5 | 40,5 |
| 0 | 0,30 | 0 | 4,8 |
| 10 | 0,15 | 1,5 | 5,4 |
| 100 | 0,05 | 5 | 460,8 |
| Soma | 1,00 | 4,0 | 511,5 |
\[E[X] = \sum x \cdot p(x) = 4{,}0\]
\[E[X^2] = \sum x^2 \cdot p(x) = 527{,}5 \qquad \text{então} \qquad \text{Var}(X) = 527{,}5 - 4{,}0^2 = 511{,}5\]
\[SD(X) = \sqrt{511{,}5} \approx 22{,}62\]
Um jogador perde dinheiro em 50% das partidas (o pagamento de -5), mas ainda assim a esperança do jogo é um positivo 4,0, puxado para cima pelo resultado de probabilidade pequena e pagamento grande de 100. O desvio padrão de cerca de 22,6 é mais de cinco vezes a própria média: este é um jogo de alta variância, no qual uma única partida diz muito pouco sobre o que esperar, em média.

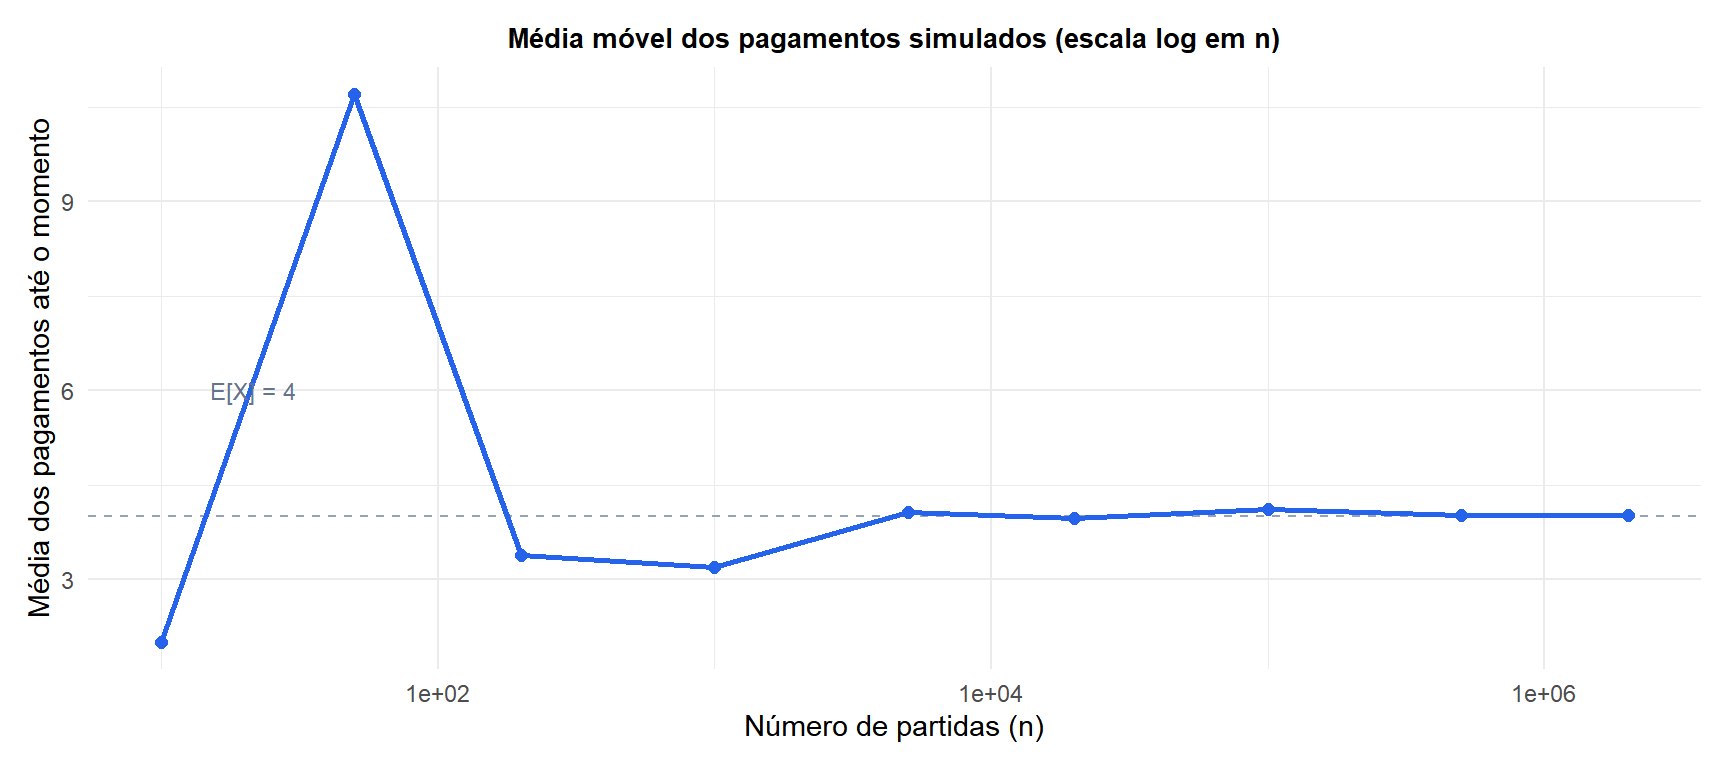
Ao longo de 2.000.000 de partidas simuladas, a média empírica se estabiliza em 4,01 e a variância empírica em 512,45, ambas extremamente próximas dos valores teóricos \(E[X]=4{,}0\) e \(\text{Var}(X)=511{,}5\). Essa é exatamente a interpretação que a lei dos grandes números dá a \(E[X]\): é o valor para o qual a média amostral converge conforme o número de repetições cresce, não um valor que uma única partida produz.
A esperança nem sempre é um resultado possível
A palavra “esperança” convida a uma interpretação equivocada comum. \(E[X]\) é uma quantidade teórica, em nível populacional, e não há nenhuma exigência de que \(X\) possa realmente ser igual a ela.
⚠️ Um dado honesto nunca mostra 3,5
A esperança de um único lançamento de um dado honesto de seis faces é \(E[X] = (1+2+3+4+5+6)/6 = 3{,}5\), um valor que o dado fisicamente não pode mostrar. “Esperança” aqui significa a média de longo prazo ao longo de muitos lançamentos, não uma previsão do que um único lançamento vai mostrar. A mesma lógica se aplica ao exemplo dos pagamentos acima: nenhuma partida individual desse jogo paga exatamente 4, só a média de muitas partidas se aproxima disso.
Fazendo isso em R
As duas quantidades saem diretamente do vetor de probabilidades, sem precisar de nenhuma função especial:
x <- c(-5, 0, 10, 100)
p <- c(0.5, 0.3, 0.15, 0.05)

EX  <- sum(x * p)                  # esperança
EX2 <- sum(x^2 * p)                # E[X^2]
VarX <- EX2 - EX^2                 # variância, fórmula do atalho
SDX  <- sqrt(VarX)                 # desvio padrão

EX; VarX; SDX

# Definição direta, deve coincidir com VarX acima
sum((x - EX)^2 * p)

# Verificação por simulação: a média e a variância empíricas convergem para EX e VarX
samples <- sample(x, size = 2e6, replace = TRUE, prob = p)
mean(samples)
var(samples)
💡 Esperança e variância de distribuições comuns
Raramente é preciso calcular isso do zero para uma distribuição com nome, cada uma tem uma forma fechada conhecida: Binomial\((n,p)\) tem \(E[X]=np\) e \(\text{Var}(X)=np(1-p)\); Poisson\((\lambda)\) tem \(E[X]=\text{Var}(X)=\lambda\) (a média é igual à variância, uma assinatura distintiva da Poisson); para uma Uniforme contínua\((a,b)\), \(E[X]=(a+b)/2\) e \(\text{Var}(X)=(b-a)^2/12\). As fórmulas gerais desta página são de onde esses atalhos vêm.

